
容器与云原生 / 系统课时
识别自动伸缩的四层控制边界
识别自动伸缩的四层控制边界
自动伸缩不是“CPU 高了就加机器”这么简单。本篇把流量、Pod 副本、单 Pod 资源规格和节点容量拆成四层控制边界,帮助你判断一个容量问题应该由 HPA、VPA、节点自动扩缩容,还是由入口限流与队列机制处理。
学习目标
- 区分流量、Pod 副本、单 Pod 规格和节点容量四个控制层次。
- 说明 HPA、VPA 与节点自动扩缩容分别观察什么信号、修改什么对象。
- 根据容量现象判断应调整哪一层,避免多个控制器相互“打架”。
四层不是四个独立开关
请求首先形成工作负载,副本数决定有多少 Pod 分担请求,单 Pod 的 requests 决定调度器如何计算资源需求,节点层再决定集群是否有足够可调度容量。上层动作常会改变下层压力,因此必须把它们看成串联的控制回路。
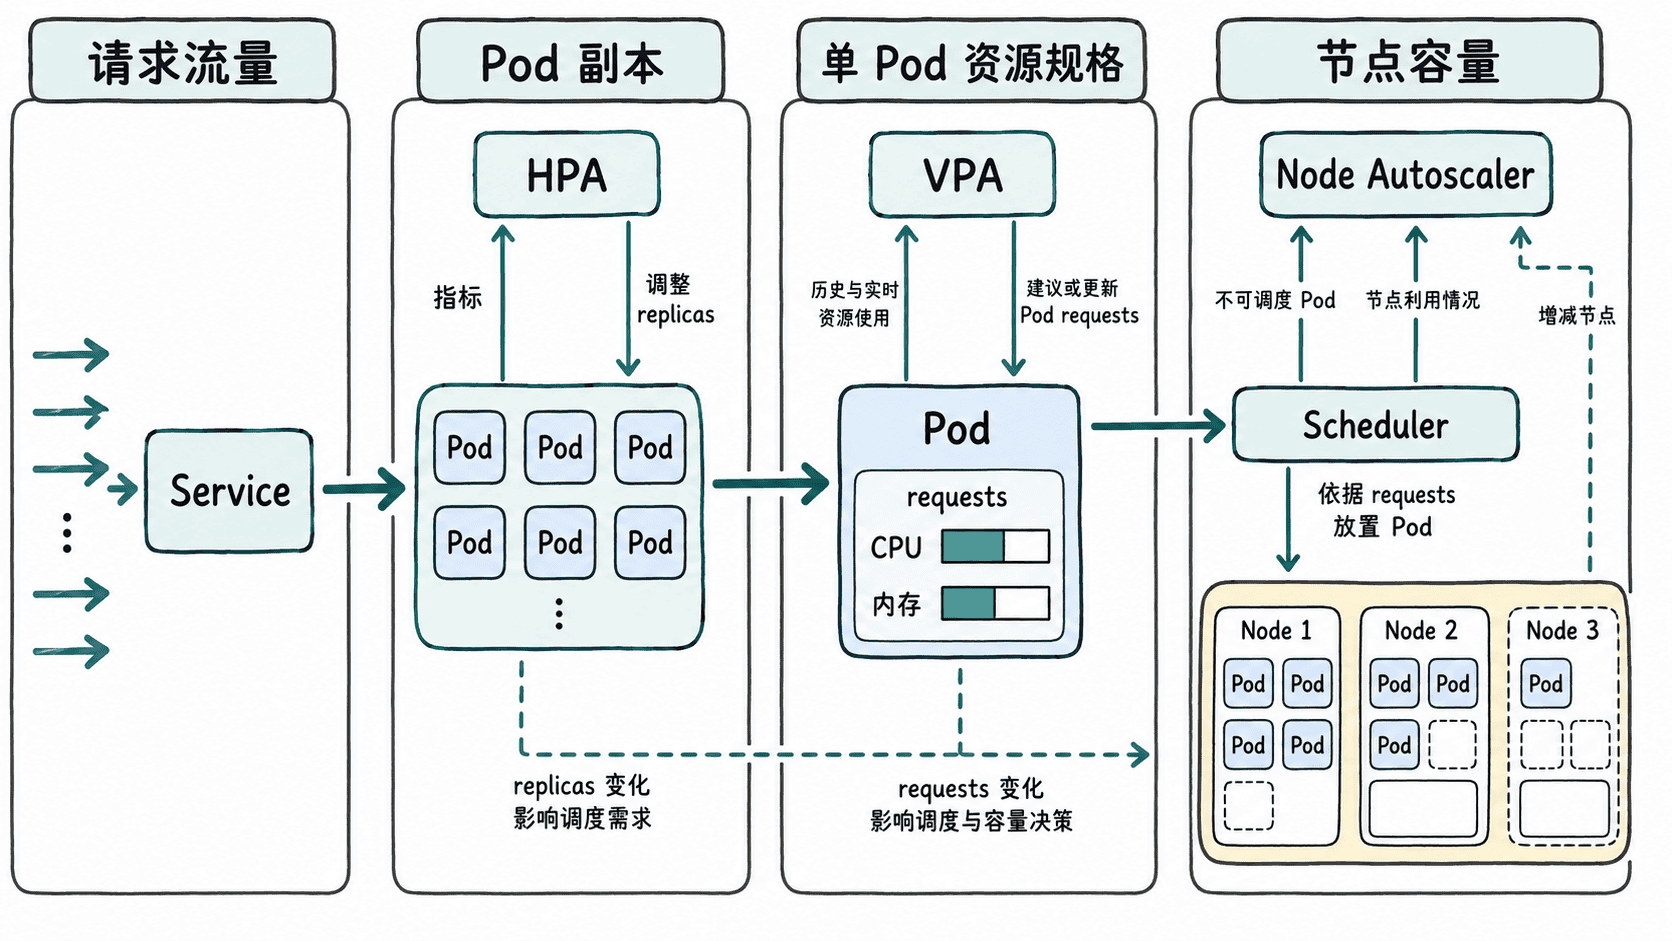
这里最重要的关系是:流量是需求,副本和单 Pod 规格是工作负载形状,节点是承载底座。如果只盯着某一个指标,很容易把症状当成根因。
HPA、VPA 与节点伸缩分别改什么
| 层次 | 典型信号 | 主要动作 | 代表机制 | 不能直接解决的问题 |
|---|---|---|---|---|
| 请求流量 | QPS、队列长度、并发数 | 限流、排队、削峰或事件驱动扩缩 | Ingress、网关、队列、外部控制器 | 节点本身容量不足 |
| Pod 副本 | CPU、内存、自定义或外部指标 | 修改 replicas |
HPA | 单个 Pod 规格明显不合理 |
| 单 Pod 规格 | 实际资源使用、历史分布 | 调整 requests,按策略重建或更新 Pod |
VPA | 集群完全没有可用节点容量 |
| 节点容量 | 不可调度 Pod、节点利用情况 | 增加或缩减节点 | Cluster Autoscaler 等 | 应用自身吞吐瓶颈 |
HPA 的执行器是副本数。以资源利用率型指标为例,它本质上是在比较当前指标与目标指标,再计算期望副本数;但最终能否扩出去,还取决于新 Pod 是否能被调度。
VPA 的执行器是 Pod 的资源请求。它解决的是“一个 Pod 应该申请多少 CPU 和内存”这一类问题。某些更新模式会通过驱逐并重建 Pod 让新请求生效,因此它与 HPA 同时作用于 CPU 或内存时,需要提前设计边界。
节点自动扩缩容关注的是“已经产生的 Pod 是否有地方放”。它通常不会因为某个节点 CPU 高就直接加节点,而是根据不可调度 Pod 的资源需求、节点组能力和缩容安全条件做决策。
看懂控制回路的连锁反应
假设请求量突然翻倍,应用 CPU 上升。HPA 先把副本从 3 个提高到 6 个;新增 Pod 带着各自的 requests 进入调度队列。如果现有节点放不下这些 Pod,节点自动扩缩容才会继续增加节点。
反过来,如果 requests 严重高估,调度器会认为每个 Pod 都很“胖”,HPA 一扩容就更容易制造 Pending Pod,节点层随之扩容,最终出现成本增加但实际 CPU 使用仍很低的现象。此时根因不在节点,而在单 Pod 规格。
用边界判断容量问题
遇到容量问题时,先问“哪个对象应该被改变”。流量突发但下游不能无限扩,先考虑限流、排队或削峰;单 Pod 性能稳定且可并行扩展,优先看 HPA;Pod 长期申请过多或过少资源,评估 VPA 或人工调整 requests;已经出现不可调度 Pod 且节点池有扩容空间,再看节点自动扩缩容。
这四层的顺序不是固定的故障处理步骤,而是一张责任地图。只有先确定信号属于哪一层、执行器能改什么,才能避免用“加副本”修单 Pod 规格问题,或用“加节点”掩盖错误的资源请求。