
容器与云原生 / 系统课时
读取弹性容量关键指标
读取弹性容量关键指标
自动伸缩不是“CPU 高了就加 Pod”。要判断容量是否真的不足,需要把负载信号、服务质量和调度结果放在同一条观察链上。本课建立一套可操作的指标读取顺序,让你能区分“业务变忙”“单个 Pod 吃紧”“Pod 已经扩出但调度不下”等不同问题。
学习目标
- 区分 CPU、内存、请求率、延迟和队列积压分别回答什么问题
- 读取 Pending Pod、节点可分配余量等容量结果,识别瓶颈发生在哪一层
- 建立从负载到工作负载再到节点的固定观察顺序,避免只看单一指标
先把指标分成三层
弹性容量观察最容易犯的错误,是把所有指标都当作同一种“压力值”。更实用的分法是三层:业务负载说明来了多少工作,工作负载状态说明 Pod 是否扛得住,集群容量结果说明 Kubernetes 是否还有地方承载新增副本。
| 层级 | 典型指标 | 主要回答的问题 |
|---|---|---|
| 业务负载 | 请求率、并发数、队列积压 | 现在有多少工作需要处理 |
| 服务与 Pod | 延迟、错误率、CPU、内存 | 当前副本是否在健康完成这些工作 |
| 集群容量 | Pending Pod、节点 CPU/内存余量 | 新副本能否真正被调度并运行 |
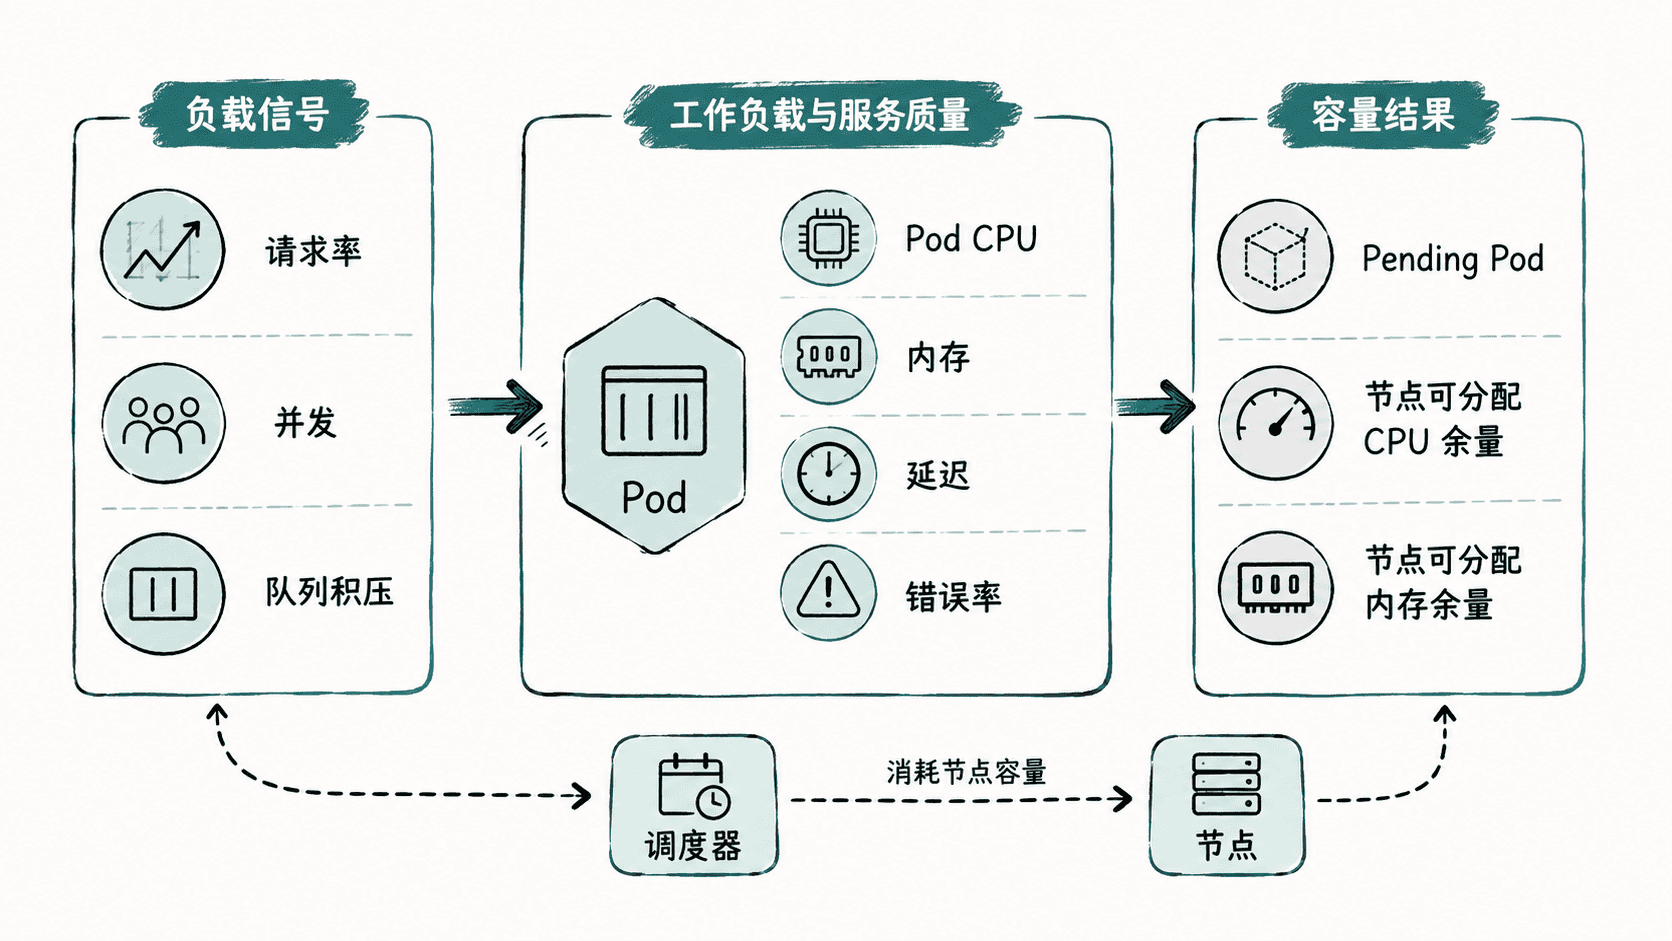
这三层不能互相替代。例如请求率上涨而 CPU 仍低,可能说明应用主要在等待 I/O;CPU 很高但延迟正常,也可能只是充分利用资源,并不代表必须扩容。
用 kubectl 读取资源与调度结果
集群安装并配置 Metrics API 后,可以先用 kubectl top 查看节点和 Pod 的即时 CPU、内存使用,再结合 Pod 状态判断扩容后是否出现调度阻塞。
kubectl top pod -n <NAMESPACE>
kubectl top node
kubectl get pod -n <NAMESPACE> --field-selector=status.phase=Pending
预期输出
NAME              CPU(cores)   MEMORY(bytes)
api-<ID>          <VALUE>      <VALUE>

NAME              CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
<NODE>            <VALUE>      <VALUE> <VALUE>         <VALUE>

NAME              READY   STATUS    RESTARTS   AGE
<pending-pod>     0/1     Pending   0          <TIME>
实际名称和数值会不同;如果最后一条命令没有输出,表示当前没有 Pending 状态 Pod。kubectl top 反映的是使用量,不等于可调度余量,因此还要查看节点的 Allocatable 与已请求资源。
kubectl describe node <NODE>预期输出
Allocatable:
  cpu:                <VALUE>
  memory:             <VALUE>
Allocated resources:
  Resource           Requests      Limits
  cpu                <VALUE>       <VALUE>
  memory             <VALUE>       <VALUE>
调度器主要依据 Pod 的 requests 判断能否放置,而不是依据 kubectl top 看到的瞬时使用量。某节点 CPU 实际使用率不高,但如果可分配 CPU 已被 requests 预留,新 Pod 仍可能调度失败。
业务指标要和资源指标一起读
CPU 和内存是资源消耗,不一定直接代表业务压力。对 Web 服务,请求率和延迟通常更接近用户体验;对异步消费者,队列积压往往比请求率更能反映“工作是否越堆越多”。
一个稳健的读取顺序是:先确认请求率或队列深度是否变化,再看延迟和错误率是否恶化,然后检查 Pod CPU、内存是否接近预期边界,最后确认副本扩出后是否能被调度。这样可以避免把“入口流量增长”和“节点装不下新 Pod”误判成同一种问题。
识别几种典型组合
当请求率上涨、Pod CPU 同步升高、延迟开始变差,而且节点仍有余量时,通常是工作负载副本不足。这类问题适合由 HPA 增加副本。
当 HPA 已经提高期望副本数,但出现越来越多 Pending Pod,同时节点可分配资源不足时,瓶颈已经从工作负载层转移到集群容量层。继续提高 HPA 上限不会让服务真正获得更多运行中的 Pod,此时需要补充节点容量或降低单 Pod 的资源请求。
当 CPU 不高但延迟升高、队列持续积压时,应优先检查外部依赖、锁竞争、I/O 或下游吞吐,而不是直接把 CPU 目标调得更激进。自动伸缩指标必须和服务实际瓶颈匹配,才能把“扩容动作”转化为真正的处理能力。