
容器与云原生 / 系统课时
组合多个伸缩指标
组合多个伸缩指标
单一 CPU 指标只能描述资源压力,未必能反映排队、请求量等业务负载。本课把资源指标与外部业务指标同时交给 HPA,让每个指标独立计算副本建议,再理解最终取值、限幅与指标失败时的保护行为。
学习目标
- 配置
autoscaling/v2HPA 同时使用 CPU 与外部业务指标 - 解释多个指标如何分别计算建议副本并选取最终结果
- 判断单个指标失效时扩容与缩容为何会出现不同处理
HPA 怎样合并多个指标
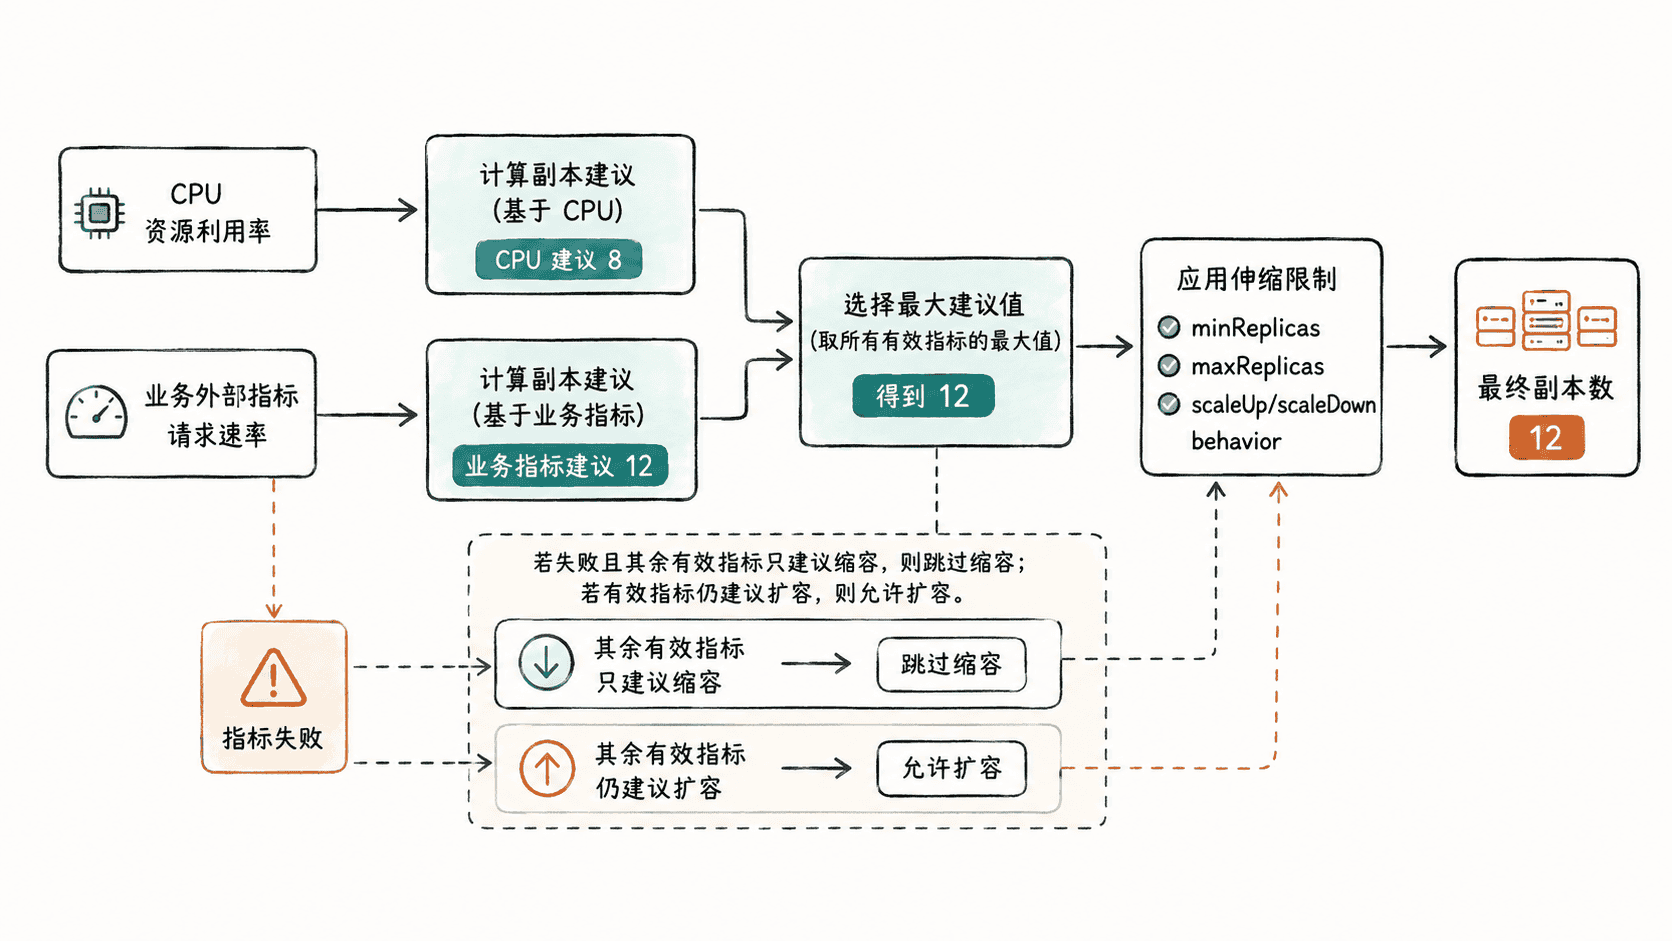
HPA 不会把 CPU 和业务指标先加权成一个总分。控制器会对 metrics 中的每一项独立计算期望副本数,再选择其中最大的建议值。这个策略优先满足最紧张的容量约束:例如 CPU 建议 8 个副本、请求速率建议 12 个副本,候选结果就是 12,而不是二者平均。
选出最大建议后,结果仍会受到 minReplicas、maxReplicas、扩缩容速率策略和稳定窗口限制。因此“取最大值”描述的是指标建议的合并方式,不等于工作负载一定会瞬间跳到该数量。
配置 CPU 与外部业务指标
下面假设 shop 命名空间已有 Deployment/checkout,容器已声明 CPU requests,集群已安装 Metrics Server,并且外部指标适配器能够提供 checkout_requests_per_second。业务指标使用 AverageValue,表示期望每个副本承担的请求速率目标。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: checkout-hpa
  namespace: shop
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: checkout
  minReplicas: 4
  maxReplicas: 30
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 60
    - type: External
      external:
        metric:
          name: checkout_requests_per_second
          selector:
            matchLabels:
              service: checkout
        target:
          type: AverageValue
          averageValue: "800"
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 0
      policies:
        - type: Percent
          value: 100
          periodSeconds: 60
    scaleDown:
      stabilizationWindowSeconds: 300
      policies:
        - type: Percent
          value: 25
          periodSeconds: 60
这里 CPU 目标为 60%,业务目标为每副本 800 请求/秒。scaleDown 的 300 秒稳定窗口与每分钟最多缩减 25% 的策略用于降低指标抖动带来的频繁回收;它们不会改变“多个指标取最大建议”的原则,只会约束最终执行速度。
保存为 hpa-multi.yaml 后应用配置,并确认 HPA 中确实存在两类指标:
kubectl apply -f hpa-multi.yaml
kubectl get hpa checkout-hpa -n shop -o jsonpath='{range .spec.metrics[*]}{.type}{"\n"}{end}'
预期输出
horizontalpodautoscaler.autoscaling/checkout-hpa <VALUE>
Resource
External
<VALUE> 可能是 created、configured 或 unchanged,取决于对象此前是否存在;两行指标类型应保持为 Resource 与 External。
指标失败时为什么缩容更谨慎
多指标场景最容易误解的是失败处理。若某个指标暂时取不到值,而其余可用指标都建议缩容,HPA 会跳过这次缩容,避免因为“缺少一个可能正在报警的指标”而错误回收容量。相反,只要仍有可用指标明确建议扩容到高于当前副本数,HPA 仍可以执行扩容。
排查时应分别确认资源指标链路和外部指标链路。CPU 长期显示未知时先检查 Pod 的 CPU requests 与 Metrics Server;只有业务指标异常时,应检查外部指标适配器、指标名称、标签选择器以及后端监控查询是否一致。
选择能互补而不是重复的指标
组合指标的价值来自覆盖不同风险。CPU 适合捕捉单 Pod 计算压力,请求速率、队列深度或并发量则更接近业务需求。如果两个指标本质上都只是 CPU 的不同变形,配置再多也不会增加容量决策的信息量。
上线前至少演练三种状态:资源压力高但业务量正常、业务量突增但 CPU 尚未升高、业务指标接口暂时失败。只要三种情况下的副本方向都符合预期,并且 maxReplicas 能承受峰值、缩容窗口不会拖慢必要回收,这组多指标策略才算真正可用。