
容器与云原生 / 系统课时
使用外部指标驱动伸缩
使用外部指标驱动伸缩
有些最关键的负载信号根本不属于 Pod,例如托管消息队列的积压、云负载均衡器的请求量或外部服务的消费延迟。本课把队列积压接入 External Metrics API,再让 HPA 按“每个副本承担多少积压”来决定副本数。
学习目标
- 说清外部监控系统、指标适配器、External Metrics API 与 HPA 的数据链路。
- 使用
External指标和AverageValue配置队列驱动的伸缩条件。 - 在创建 HPA 前验证外部指标可读,并定位常见接入失败点。
先确认外部指标链路
External Metrics API 负责暴露“不与某个 Kubernetes 对象绑定”的指标。典型链路是:消息队列或云监控产生指标,指标适配器读取并转换该数据,通过聚合 API 暴露 external.metrics.k8s.io,HPA 再按指标名称和标签选择器查询它。HPA 不需要从目标 Pod 内部采集这类信号。
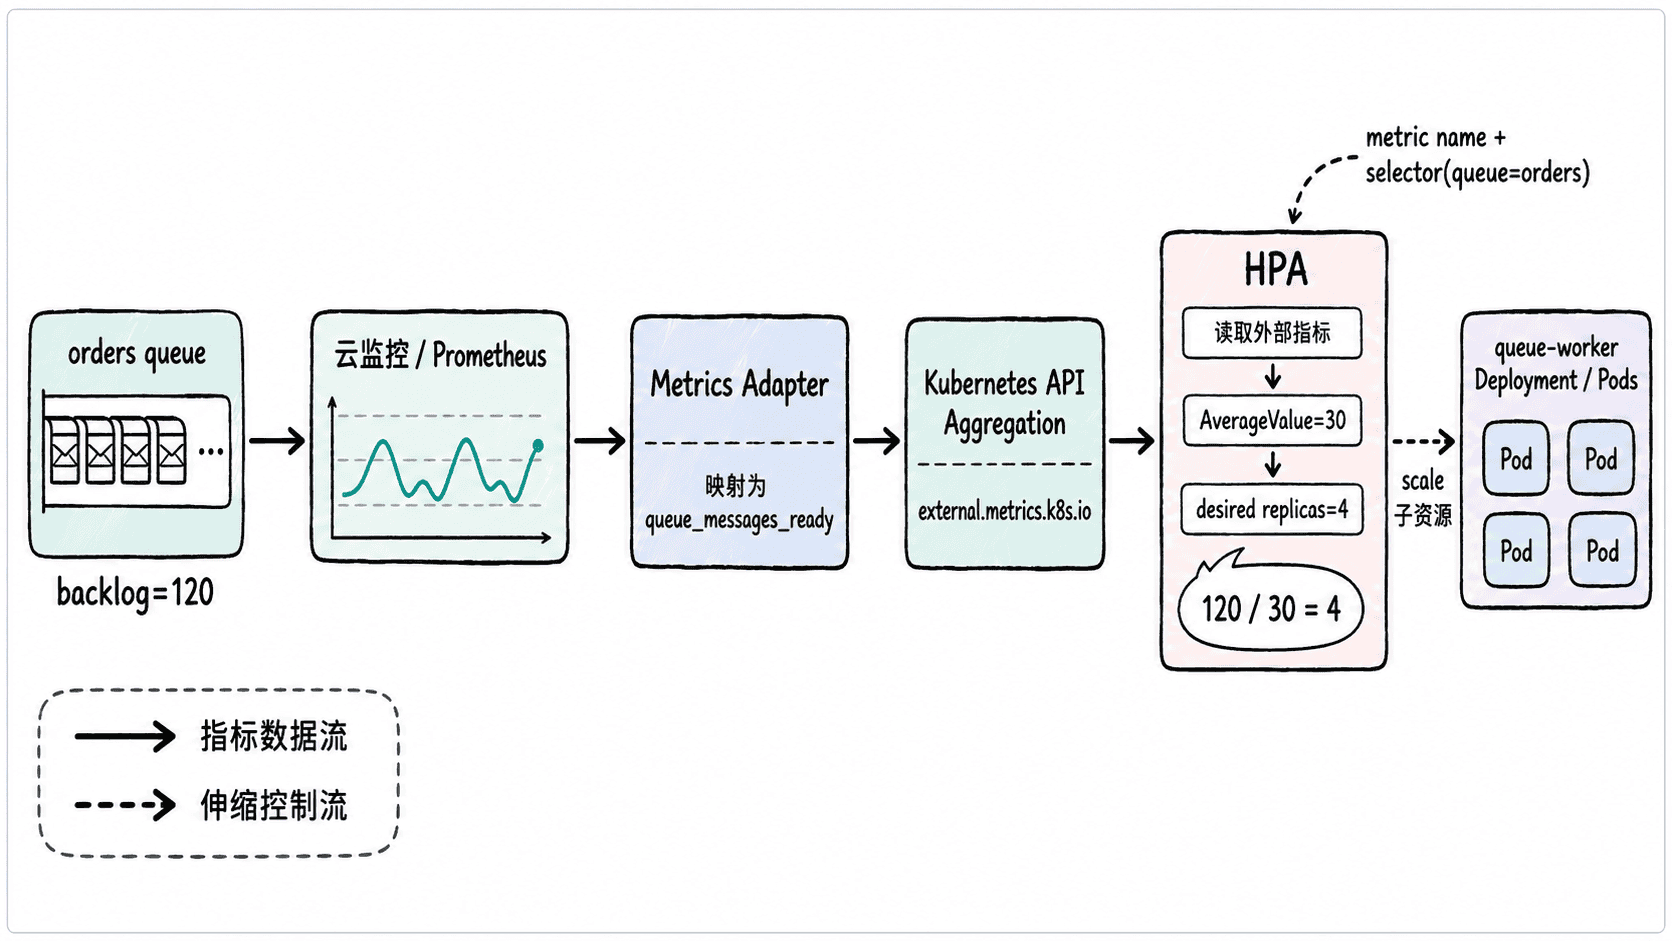
在配置 HPA 之前,先直接读取 API。下面假设适配器暴露的指标名为 queue_messages_ready,并用标签 queue=orders 区分队列。
kubectl get --raw '/apis/external.metrics.k8s.io/v1beta1/namespaces/default/queue_messages_ready?labelSelector=queue%3Dorders'预期结果应至少包含匹配的指标名、标签和当前值:
{
  "kind": "ExternalMetricValueList",
  "apiVersion": "external.metrics.k8s.io/v1beta1",
  "items": [
    {
      "metricName": "queue_messages_ready",
      "metricLabels": {
        "queue": "orders"
      },
      "timestamp": "<TIME>",
      "value": "120"
    }
  ]
}
不同适配器可能补充窗口或元数据字段;真正要验证的是 items 非空、指标名称与标签匹配、value 是当前可用值。若这里就返回 API 不存在或无数据,不要先调 HPA 参数,应先修复 APIService、适配器规则或上游监控查询。
用队列积压定义副本需求
假设一个消费者希望平均承担不超过 30 条待处理消息,可以使用 AverageValue: "30"。当外部指标返回总积压 120 时,HPA 的直觉目标就是约 4 个副本;积压下降后,所需副本也会随之回落。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: queue-worker
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: queue-worker
  minReplicas: 2
  maxReplicas: 30
  metrics:
    - type: External
      external:
        metric:
          name: queue_messages_ready
          selector:
            matchLabels:
              queue: orders
        target:
          type: AverageValue
          averageValue: "30"
将配置保存为 hpa-external.yaml 后创建 HPA,并读取关键字段确认名称和目标值没有写错。
kubectl apply -f hpa-external.yaml
kubectl get hpa queue-worker -o jsonpath='{.spec.metrics[0].external.metric.name}={.spec.metrics[0].external.target.averageValue}{"\n"}'
预期输出(首次创建时):
horizontalpodautoscaler.autoscaling/queue-worker created
queue_messages_ready=30
若对象已经存在,第一行可能显示 configured 或 unchanged。
选择能被扩容真正改善的指标
外部指标最重要的不是“能不能接进来”,而是扩容后它是否会朝正确方向变化。队列积压通常适合消费者扩容,因为增加消费者会提高处理能力并最终压低 backlog;相反,如果指标主要受上游故障、第三方限流或固定批处理窗口影响,多加 Pod 可能无法改善它,HPA 只会一路逼近 maxReplicas。
Value 与 AverageValue 的含义也不同。Value 直接把一个全局指标与目标值比较;AverageValue 会把外部指标按当前副本数折算成每 Pod 平均值,因此更适合表达“每个 worker 承担多少积压”这一容量模型。选择目标值时应从单 Pod 的稳定处理能力倒推,而不是凭当前副本数拍一个阈值。
按链路定位接入失败
外部指标伸缩失败时,按数据链路从前往后检查最快:先确认外部系统真的有新数据,再确认适配器能查询到它,然后直接请求 external.metrics.k8s.io,最后才检查 HPA 的 metric name、selector 与 target。这样可以把“上游没有数据”和“HPA 配错字段”快速分开。
kubectl get hpa queue-worker -o jsonpath='{range .status.currentMetrics[*]}{.type}{"="}{.external.metric.name}{"\n"}{end}{range .status.conditions[*]}{.type}{"="}{.status}{"\n"}{end}'预期结果(外部指标已经成功采样后):
External=queue_messages_ready
AbleToScale=<VALUE>
ScalingActive=<VALUE>
ScalingLimited=<VALUE>
<VALUE> 会随运行状态变化。只要 currentMetrics 能持续出现 External=queue_messages_ready、外部 API 能返回新鲜指标,并且扩容确实能降低单位副本压力,这条伸缩链路才算完成;否则应先修指标语义或数据链路,而不是继续放大 maxReplicas。