
容器与云原生 / 系统课时
治理节点缩容与工作负载中断
治理节点缩容与工作负载中断
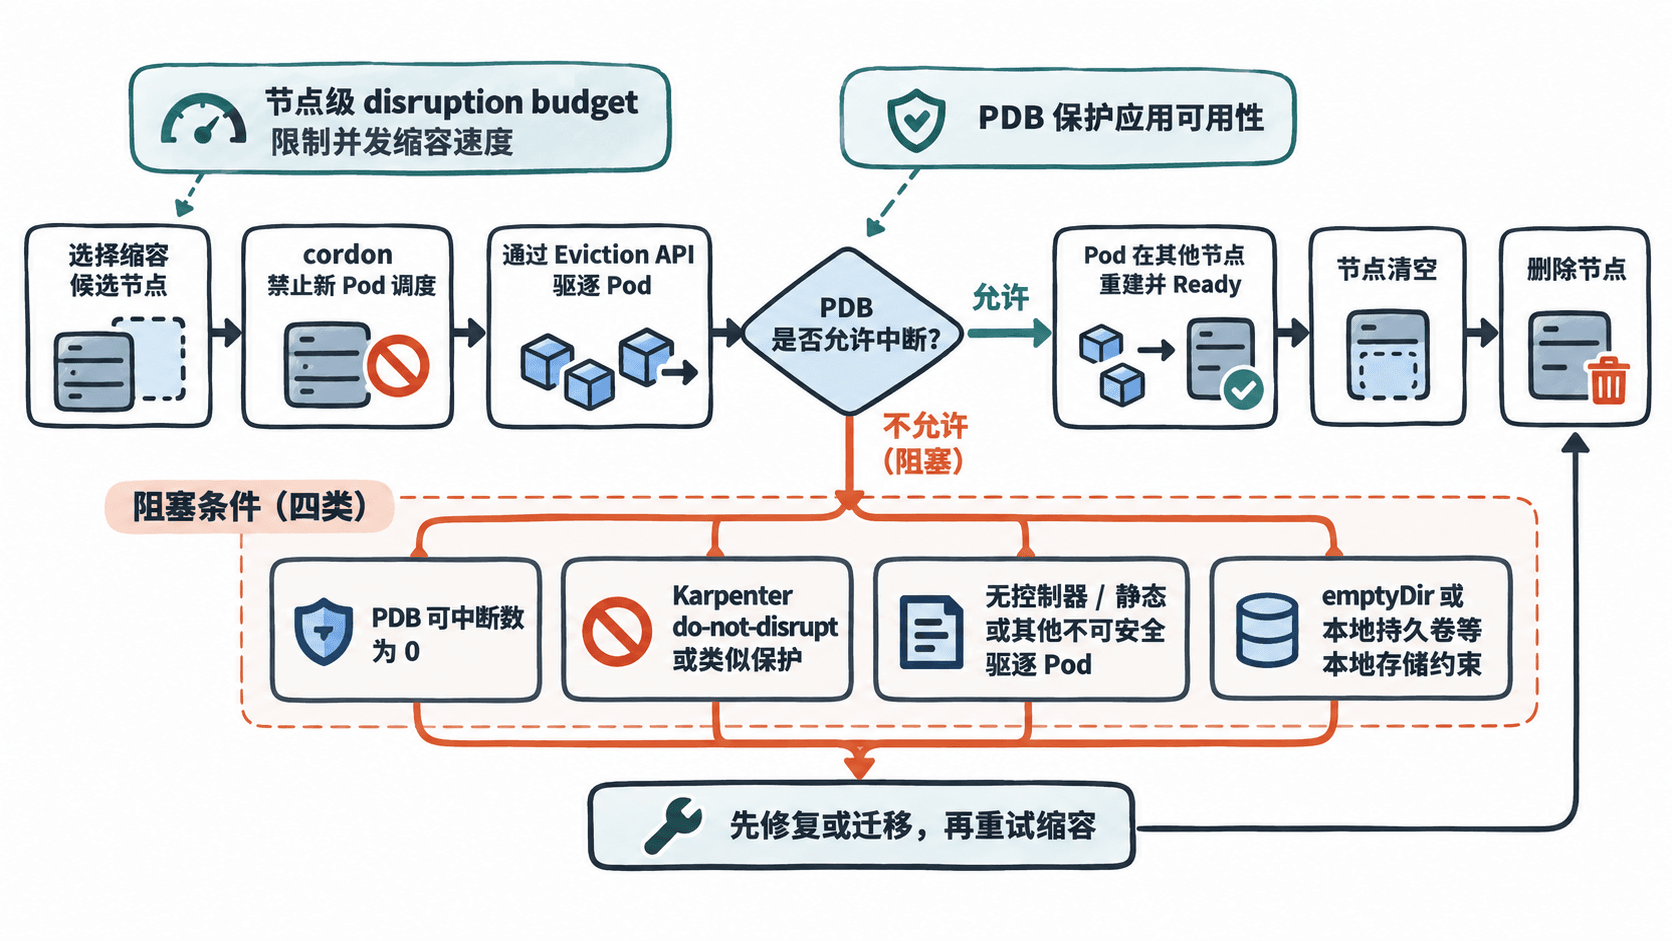
节点缩容的难点不在于删除虚拟机,而在于先把节点上的 Pod 安全迁走。正确的治理顺序是识别缩容候选节点、停止继续调度、通过驱逐机制检查可中断预算,再处理 PDB、不可驱逐 Pod 与本地存储等阻塞条件。
学习目标
- 理解节点缩容中 cordon、eviction、重新调度与删除节点的顺序
- 能用 PodDisruptionBudget 判断一次自愿中断是否会破坏可用性
- 能定位 PDB、本地存储和特殊工作负载导致的缩容阻塞
缩容先做驱逐,再做删除
安全缩容通常先把节点标记为不可调度,防止新 Pod 继续进入,然后逐个驱逐由控制器管理的普通 Pod。Eviction API 会让 Kubernetes 检查对应工作负载当前是否还有中断预算;驱逐成功后,Deployment、StatefulSet 等控制器再在其他节点创建替代 Pod。
这条链路的关键点是:节点删除是最后一步。如果直接删除云实例,工作负载会遭遇非预期中断,PDB 也来不及为这次节点级操作把关。
用 PDB 把可用性写成约束
PDB 适合保护有副本的应用免受自愿中断一次性带走过多副本。例如一个 3 副本 API 服务可以要求至少 2 个 Pod 在驱逐过程中保持可用。PDB 不会增加副本数,也不会保证新 Pod 一定能在别处调度,因此它必须与足够的剩余容量和正确的拓扑分布一起使用。
下面的配置要求选中的工作负载在自愿驱逐期间至少保留 2 个可用 Pod。unhealthyPodEvictionPolicy: AlwaysAllow 可避免一个长期不健康的 Pod 永久卡住节点排空,但健康 Pod 仍然受预算约束。
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: api-pdb
  namespace: prod
spec:
  minAvailable: 2
  unhealthyPodEvictionPolicy: AlwaysAllow
  selector:
    matchLabels:
      app: api
应用后可直接查看当前还能允许多少次驱逐:
kubectl apply -f api-pdb.yaml
kubectl get pdb api-pdb -n prod
预期输出
poddisruptionbudget.policy/api-pdb configured
NAME      MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS   AGE
api-pdb   2               N/A               <VALUE>               <TIME>
ALLOWED DISRUPTIONS 是此刻最值得关注的字段。若它为 0,节点排空中的相关 Eviction 请求会被拒绝或持续重试;此时应先恢复副本健康、增加副本或补足可调度容量,而不是绕过 PDB 强删 Pod。
缩容卡住时按阻塞类型定位
遇到节点长时间无法删除,不要先扩大超时或使用强制参数。先看节点上还剩哪些 Pod,再判断它们为什么不能被安全迁移:
kubectl get pods -A --field-selector spec.nodeName=<NODE> -o wide
kubectl get pdb -A
预期输出
NAMESPACE   NAME        READY   STATUS    RESTARTS   AGE      IP       NODE
<VALUE>     <VALUE>     <VALUE> <VALUE>   <VALUE>    <TIME>   <IP>     <NODE>

NAMESPACE   NAME        MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS   AGE
<VALUE>     <VALUE>     <VALUE>         <VALUE>           <VALUE>               <TIME>
定位时可以按以下顺序判断:
- 先确认剩余 Pod 是否被某个 PDB 选中,以及该 PDB 的允许中断数是否已经耗尽。
- 再确认 Pod 是否有控制器接管。孤立 Pod、静态 Pod或其他不能安全重建的工作负载不能按普通 Deployment 的思路处理。
- 检查是否存在节点供给器专用的“不要中断”保护。例如 Karpenter 环境中的
karpenter.sh/do-not-disrupt: "true"会让自动化缩容把该 Pod 视为显式保护对象。 - 最后检查存储。
emptyDir会随 Pod 离开节点而丢失;基于本地磁盘的 PersistentVolume 还可能通过节点亲和性把数据固定在原节点,必须先确认数据迁移策略。
只有明确知道数据可以丢弃时,才应在人工 kubectl drain 中考虑 --delete-emptydir-data。这个参数解决的是“允许删除临时本地数据”,不是把有状态工作负载自动迁成高可用。
把节点级预算与应用级预算分开治理
自动节点供给器通常还能配置节点级 disruption budget,用来限制同一时间允许多少节点被合并、替换或缩容。它控制的是基础设施变化速度;PDB 控制的是某组 Pod 能承受多少自愿中断。两者同时存在时,实际缩容速度会被更严格的一侧限制。
一个可靠的容量治理策略通常满足三个条件:工作负载有足够副本并分散到多个故障域,PDB 与真实可用性目标一致,节点缩容自动化对本地存储和显式保护 Pod 保持保守。这样做可能让某些低利用率节点多保留一段时间,但这正是用少量容量冗余换取服务可用性的合理成本。
当节点迟迟缩不掉时,正确问题不是“怎样强制删掉它”,而是“哪个安全条件还没有满足”。只要把驱逐预算、可重建性和数据位置逐项查清,缩容阻塞就会从随机现象变成可解释、可治理的容量决策。