
容器与云原生 / 系统课时
排查指标缺失与异常
排查指标缺失与异常
HPA 不扩缩容时,先别急着改阈值。真正需要确认的是指标在哪一层消失、变旧或被筛掉。本篇按 Metrics API、聚合 API、指标适配器和 HPA 事件逐层取证,最终把“没有指标”定位成可修复的具体故障。
学习目标
- 区分资源指标、自定义指标和外部指标的故障边界
- 用 APIService、原始 Metrics API 与 HPA Conditions/Events 建立证据链
- 识别指标为空、时间戳过期、标签不匹配和适配器查询失败
先把指标故障切成几层
资源指标路径通常是 Kubelet → metrics-server → metrics.k8s.io → HPA;自定义或外部指标则是监控后端 → 指标适配器 → custom.metrics.k8s.io / external.metrics.k8s.io → HPA。排障时应从 HPA 能看到的 API 往下追,而不是先重启任意组件。
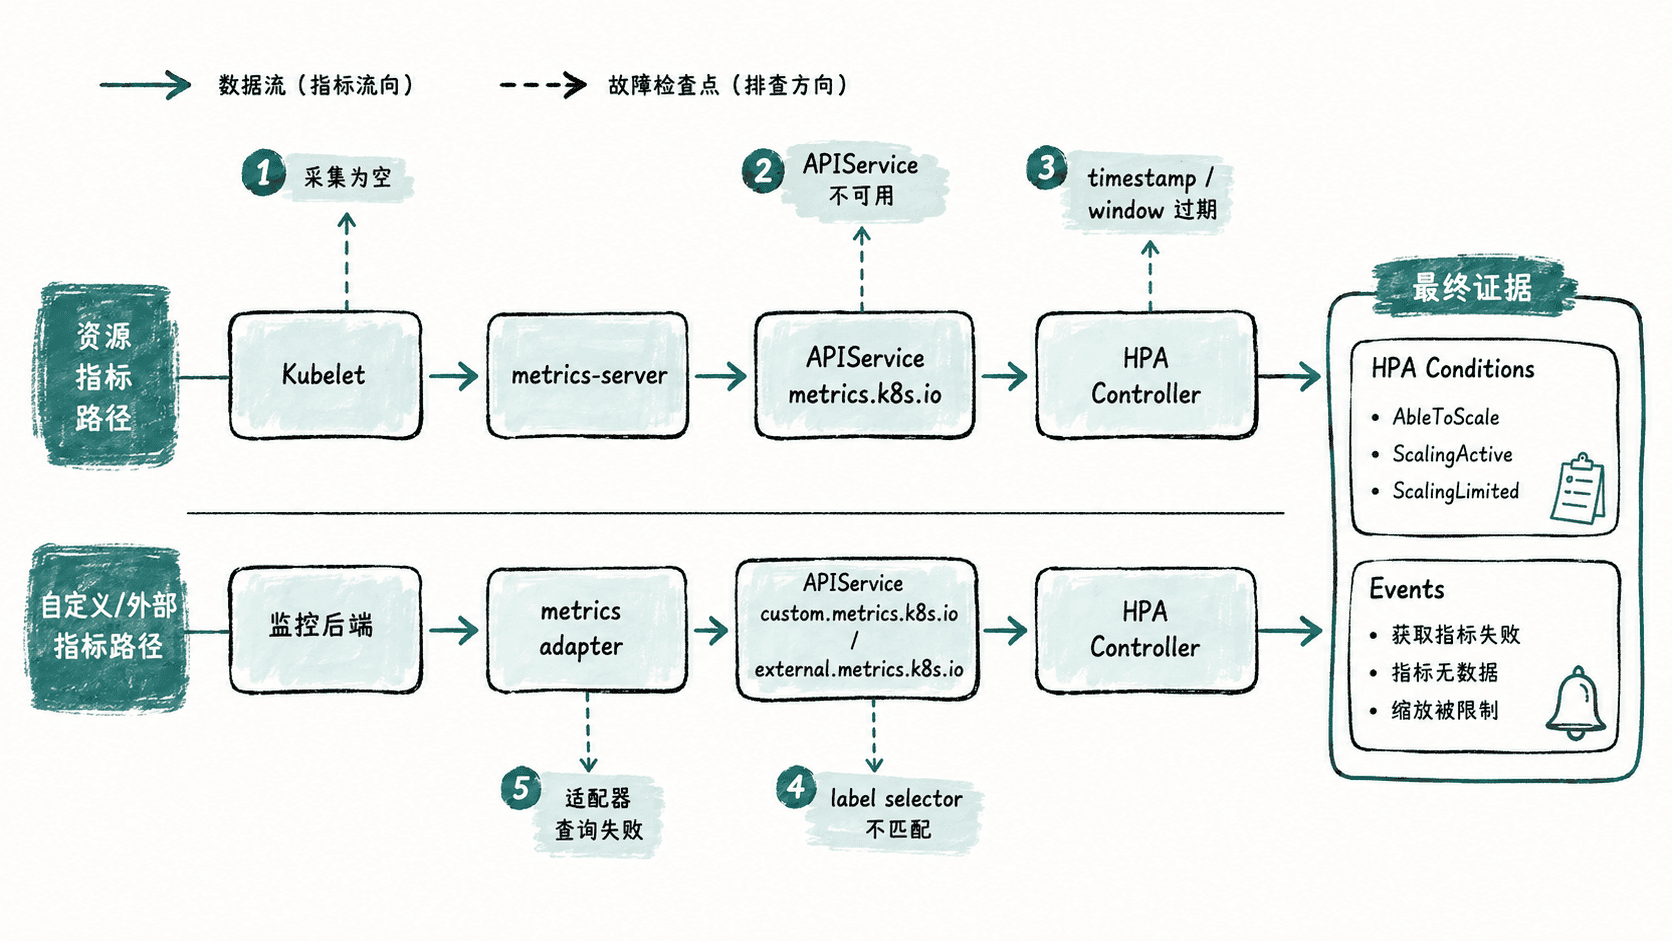
如果 kubectl top 已经失败,优先处理资源指标链;如果 kubectl top 正常而 HPA 的自定义指标仍是 <unknown>,就把注意力转到对应 adapter、metric name、selector 与后端查询。
从聚合 API 往下取证
下面假设 HPA 名为 hpa-example,位于 default,工作负载 Pod 带有 app=hpa-example 标签。命令会同时检查 API 注册、资源指标时间戳以及 HPA 自身事件。
NS=default
HPA=hpa-example
APP_SELECTOR='app=hpa-example'

echo '== aggregated metrics APIs =='
kubectl get apiservice | grep -E 'metrics.k8s.io|custom.metrics.k8s.io|external.metrics.k8s.io' || true

echo '== resource metrics API =='
kubectl get --raw /apis/metrics.k8s.io/v1beta1 >/dev/null \
  && echo 'metrics.k8s.io: reachable'

echo '== custom/external API discovery =='
for GROUP in custom.metrics.k8s.io external.metrics.k8s.io; do
  if kubectl get --raw "/apis/${GROUP}/v1beta1" >/dev/null 2>&1; then
    echo "${GROUP}: reachable"
  else
    echo "${GROUP}: not registered or unreachable"
  fi
done

POD=$(kubectl -n "$NS" get pod -l "$APP_SELECTOR" \
  -o jsonpath='{.items[0].metadata.name}')
test -n "$POD" || { echo 'no matching pod'; exit 1; }

echo '== one PodMetrics object =='
kubectl get --raw \
  "/apis/metrics.k8s.io/v1beta1/namespaces/${NS}/pods/${POD}"

echo '== HPA conditions and events =='
kubectl -n "$NS" describe hpa "$HPA"
预期输出(健康的资源指标链;自定义/外部 API 是否存在取决于集群是否安装适配器):
v1beta1.metrics.k8s.io      kube-system/metrics-server   True   <AGE>
metrics.k8s.io: reachable
custom.metrics.k8s.io: <reachable|not registered or unreachable>
external.metrics.k8s.io: <reachable|not registered or unreachable>
{
  "kind": "PodMetrics",
  "metadata": {"name": "hpa-example-<ID>"},
  "timestamp": "<TIME>",
  "window": "<DURATION>",
  "containers": [...]
}
Conditions:
  AbleToScale     True
  ScalingActive   True
ScalingLimited False<AGE>、<ID>、<TIME>、<DURATION> 和资源值会随环境变化。若 metrics.k8s.io 的 APIService 为 False,继续 kubectl describe apiservice v1beta1.metrics.k8s.io,重点看 MissingEndpoints、FailedDiscoveryCheck、TLS、网络超时等原因;再检查 metrics-server 日志中是否出现抓取 Kubelet 失败。
识别空值、过期与标签不匹配
指标为空通常有两种形态:API 本身不可达,或 API 可达但缺少目标 Pod/对象的数据。前者查 APIService、Service/Endpoints、证书和网络;后者查 Kubelet 抓取、Pod 是否刚启动、容器是否具备 HPA 所需的 requests,以及适配器是否真的暴露了目标指标。
指标过期要看原始指标对象的 timestamp 和 window,并与 HPA 事件发生时间比较。不要只看 Grafana 上“有曲线”:HPA 使用的是聚合 API 返回的样本,监控后端有数据并不代表 adapter 返回给 Kubernetes 的样本足够新。
标签不匹配常见于自定义指标。HPA 的 metric selector、工作负载 selector、adapter 规则和后端时序标签必须能对上。最有效的办法是从 HPA 的 spec.metrics 抄出 metric name 与 selector,再直接查询适配器 API;如果裸指标存在、带 selector 后为空,问题就在标签映射而不是 HPA 算法。
把错误映射到修复动作
| 证据 | 更可能的根因 | 修复方向 |
|---|---|---|
metrics.k8s.io APIService 为 False |
聚合层、Service/Endpoints、TLS 或网络问题 | 修复 APIService 后再看 HPA |
APIService 为 True,部分 Pod 没有 PodMetrics |
Kubelet 抓取失败、Pod 太新或节点异常 | 查 metrics-server 日志与对应节点 |
| 资源指标正常,自定义指标 API 不可达 | adapter 未注册、Service 无端点或聚合层失败 | 修复 adapter/APIService |
| 自定义 API 可达,但 selector 后结果为空 | metric name 或标签映射不一致 | 对齐 HPA selector、adapter rule 与后端标签 |
| HPA 出现查询超时/后端错误 | adapter 到监控后端的查询失败 | 查 adapter 日志、查询表达式与后端可用性 |
不要用“把 HPA 阈值调高”掩盖取数错误。指标链未恢复时,阈值变化只会改变一个没有可靠输入的控制器。
用 HPA 自身完成闭环验收
修复后至少确认三件事:原始 API 能返回新鲜样本,HPA 的 ScalingActive 为 True,并且 Events 中不再持续出现获取指标失败。若配置了多个指标,HPA 会分别计算建议副本数并取最大值;当某个指标报错而其他指标只建议缩容时,HPA 会跳过缩容,因此“副本一直降不下来”也可能是指标故障的结果。
最终验收应从“指标后端有数据”提升为“聚合 API 可查询、selector 能命中、HPA 能计算并执行建议副本数”。只有这条链完整,自动伸缩才真正恢复。