
容器与云原生 / 系统课时
交付弹性容量治理方案
交付弹性容量治理方案
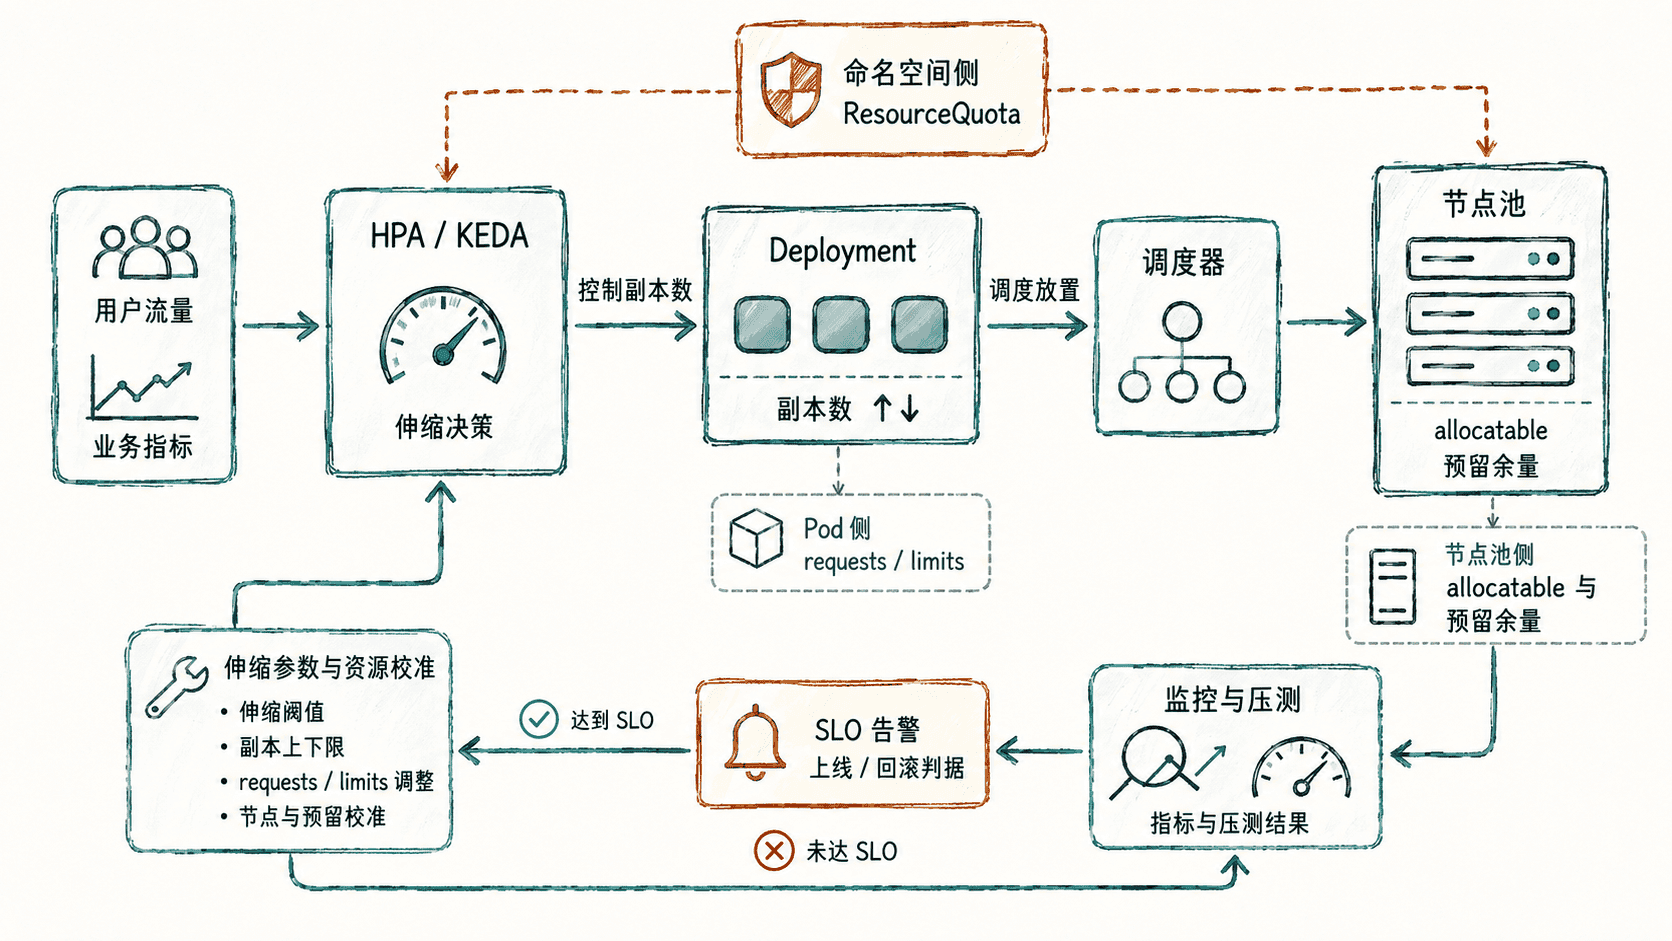
本篇把弹性从“能自动扩缩”提升为可交付的容量治理方案:以一个无状态 HTTP 服务为例,确定伸缩信号、资源基线、节点与配额边界、SLO 告警、压测验收,以及上线后的变更与回滚条件。
学习目标
- 能根据负载特征在 HPA 与 KEDA 之间做出选择,并给出可解释的伸缩参数。
- 能把 Pod 资源、节点容量与命名空间配额合并成一份可计算的容量预算。
- 能用 SLO、告警和压测结果定义上线门槛,并提前写清回滚触发条件。
先把交付边界写成容量合同
假设要交付的工作负载是 checkout-api:平时至少 4 个副本,促销时流量可能升到平时的 5 倍。先固定四类边界:最低可用副本、单 Pod 资源请求、最大副本数、节点可用容量。只有这些边界同时明确,自动伸缩才不会把压力从 Pod 转移成节点耗尽或配额失败。
CPU 或内存与吞吐近似相关、负载连续变化时,优先使用 HPA;当扩缩更直接由队列长度、消息积压、定时任务或外部事件触发时,KEDA 更合适。选择 KEDA 并不取消容量治理,requests、最大副本、节点余量、配额和 SLO 仍然必须保留。
配置 HPA 与资源基线
CPU 型 HPA 的前提是 Pod 已设置 CPU requests,否则利用率目标缺少分母。先确认目标 Deployment 和容器名,再把压测校准后的请求值写入工作负载。以下命令假设命名空间为 checkout、容器名为 app。
kubectl get deployment checkout-api -n checkout -o jsonpath='{.spec.template.spec.containers[*].name}'
kubectl set resources deployment/checkout-api -n checkout --containers=app --requests=cpu=500m,memory=512Mi --limits=cpu=1,memory=1Gi
kubectl top pods -n checkout
预期输出:
app
deployment.apps/checkout-api resource requirements updated
NAME                        CPU(cores)   MEMORY(bytes)
checkout-api-<ID>           <VALUE>      <VALUE>
<ID> 与 <VALUE> 会随集群和负载变化。若 kubectl top 不能返回指标,应先修复 metrics API,而不是继续调整 HPA 阈值。
下面的 HPA 配置片段依赖 checkout-api Deployment 已存在。它把副本控制在 4~30 之间,以 65% CPU 利用率为目标,并放慢缩容速度,避免短时低谷触发频繁回收。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: checkout-api
  namespace: checkout
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: checkout-api
  minReplicas: 4
  maxReplicas: 30
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 0
      policies:
        - type: Percent
          value: 100
          periodSeconds: 60
    scaleDown:
      stabilizationWindowSeconds: 300
      policies:
        - type: Percent
          value: 25
          periodSeconds: 60
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 65
保存为 hpa.yaml 后执行:
kubectl apply -f hpa.yaml
kubectl get hpa checkout-api -n checkout
预期输出:
horizontalpodautoscaler.autoscaling/checkout-api created
NAME           REFERENCE                 TARGETS          MINPODS   MAXPODS   REPLICAS
checkout-api   Deployment/checkout-api   <VALUE>%/65%     4         30        <VALUE>
把最大副本换算成节点与配额预算
最大副本不是一个孤立数字。以上方案在 30 个副本时,仅应用请求量就是 15 CPU 与 15 GiB 内存。节点池必须在扣除系统组件、DaemonSet、故障预留和其他工作负载后,仍能提供这部分可调度资源;否则 HPA 虽然要求扩容,Pod 仍会停在 Pending。
命名空间配额也要覆盖峰值,并给滚动发布和故障替换留余量。下面的完整 ResourceQuota 给 30 个峰值副本留出额外空间:
apiVersion: v1
kind: ResourceQuota
metadata:
  name: checkout-capacity
  namespace: checkout
spec:
  hard:
    requests.cpu: "18"
    requests.memory: 20Gi
    limits.cpu: "36"
    limits.memory: 40Gi
    pods: "40"
这是配置示例,不单独产生固定控制台输出。应用后用 kubectl describe resourcequota checkout-capacity -n checkout 验证 Used 与 Hard,同时检查节点 allocatable 的剩余量能覆盖峰值 Pod 请求与安全余量。
用 SLO 和告警约束“扩得动但扛不住”
伸缩成功不等于服务成功。交付时至少把延迟、错误率、饱和度和副本状态放在同一张验收表中。例如可暂定:P95 延迟小于 300 ms、5xx 小于 1%、HPA 不长期顶在 maxReplicas、Pending Pod 不持续出现。具体阈值应替换成业务已有的 SLO,而不是照搬示例值。
告警应覆盖三类失败:业务 SLO 已超标;HPA 长时间达到上限;调度或配额导致副本创建失败。这样能区分“需要更多副本”“节点不够”和“应用本身已经成为瓶颈”,避免只看 CPU 就继续扩容。
用压测完成验收
压测要验证的是整条弹性链路,而不是只证明接口能返回 200。使用固定脚本逐步抬高并保持流量,记录扩容开始时间、达到目标副本时间、P95、错误率、Pending Pod 和节点利用率;随后降压,观察稳定窗口结束后是否平滑缩容。
下面是一个完整的 k6 脚本,目标地址通过 BASE_URL 传入:
import http from 'k6/http';
import { check } from 'k6';

export const options = {
  stages: [
    { duration: '2m', target: 20 },
    { duration: '8m', target: 100 },
    { duration: '5m', target: 100 },
    { duration: '5m', target: 0 },
  ],
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(95)<300'],
  },
};

export default function () {
  const res = http.get(`${__ENV.BASE_URL}/health`);
  check(res, { 'status is 200': (r) => r.status === 200 });
}
确认 BASE_URL 指向可访问的真实服务端点后执行:
BASE_URL=https://<HOST> k6 run loadtest.js预期结果:
checks.........................: <VALUE>% ✓ <VALUE> ✗ <VALUE>
http_req_failed................: <VALUE>%  ✓
http_req_duration..............: p(95)=<VALUE>ms
只有当 k6 阈值通过,同时集群侧没有持续 Pending、配额拒绝或 HPA 顶格,才算完成弹性验收。实际主机名与指标值会不同。
明确变更与回滚条件
上线前把可调参数限制在少数几个:Pod requests、HPA 目标值、minReplicas、maxReplicas、扩缩稳定窗口和节点池最小容量。每次只调整一类变量,并保存压测前后的同一组指标,才能判断改动到底改善了什么。
回滚条件也应预先量化:新配置导致 SLO 连续超标、Pending Pod 持续出现、扩容速度明显不足、节点资源逼近安全余量,或成本超过约定预算时,立即恢复上一版配置;若瓶颈来自应用锁竞争、数据库或下游限流,则停止继续提高副本上限,转入对应组件排障。这样交付的不是一份“自动伸缩 YAML”,而是一套能计算、能验证、能告警、能回退的容量治理方案。