
容器与云原生 / 系统课时
搭建自动伸缩实验基线
搭建自动伸缩实验基线
后续验证 HPA、VPA 或节点伸缩前,需要一套可重复的实验基线。本篇搭建测试工作负载、可随时启停的负载发生器、metrics-server 和基础观测路径,并给出可直接验收的命令,确保伸缩实验从同一初始条件开始。
学习目标
- 部署一个带资源请求的测试工作负载和可控负载发生器。
- 安装并验证 metrics-server,使资源指标能被 Metrics API 消费。
- 用统一检查项确认 Pod、Service 与指标链路都已就绪。
检查实验前置条件
准备一个可用的 Kubernetes 集群,并确保当前 kubectl 上下文具有创建 Namespace、Deployment、Service 以及安装集群级组件的权限。节点还需要能够拉取 registry.k8s.io 与 Docker Hub 上的示例镜像。
先确认所有节点处于 Ready 状态。
kubectl wait --for=condition=Ready node --all --timeout=60s >/dev/null && echo "all nodes ready"预期输出
all nodes ready如果命令超时,先修复集群基础状态;否则后面的指标和伸缩现象会掺杂节点故障,无法作为可靠基线。
安装并验证 metrics-server
metrics-server 从 kubelet 获取资源使用数据,并通过 metrics.k8s.io API 暴露给 kubectl top 和 HPA。它不是长期监控系统,但足够支撑资源指标型自动伸缩实验。
set -e
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml >/dev/null
kubectl -n kube-system rollout status deployment/metrics-server --timeout=120s >/dev/null
echo "metrics-server ready"
预期输出
metrics-server ready在某些自建实验集群中,metrics-server 可能因 kubelet 服务端证书不被信任而无法采集指标。若出现 x509 相关错误,应优先修复 kubelet 证书;仅在隔离的临时实验环境中才考虑放宽证书校验,生产环境不要把它当作常规配置。
部署工作负载与负载发生器
创建 autoscaling-baseline.yaml。测试应用使用固定 CPU requests,这样后续 HPA 计算和调度行为有稳定基准;负载发生器初始副本为 0,需要时再开启,避免基线一创建就持续施压。
apiVersion: v1
kind: Namespace
metadata:
  name: autoscaling-lab
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: hpa-example
  namespace: autoscaling-lab
spec:
  replicas: 1
  selector:
    matchLabels:
      app: hpa-example
  template:
    metadata:
      labels:
        app: hpa-example
    spec:
      containers:
        - name: app
          image: registry.k8s.io/hpa-example:latest
          ports:
            - containerPort: 80
          resources:
            requests:
              cpu: 100m
              memory: 64Mi
            limits:
              cpu: 500m
              memory: 128Mi
---
apiVersion: v1
kind: Service
metadata:
  name: hpa-example
  namespace: autoscaling-lab
spec:
  selector:
    app: hpa-example
  ports:
    - port: 80
      targetPort: 80
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: load-generator
  namespace: autoscaling-lab
spec:
  replicas: 0
  selector:
    matchLabels:
      app: load-generator
  template:
    metadata:
      labels:
        app: load-generator
    spec:
      containers:
        - name: load-generator
          image: busybox:1.36
          command:
            - /bin/sh
            - -c
            - while true; do wget -q -O- http://hpa-example >/dev/null; done
这份配置形成两条独立链路:请求由负载发生器经过 Service 到测试 Pod;资源使用由 kubelet 被 metrics-server 汇总,再提供给 kubectl top 或后续 HPA。
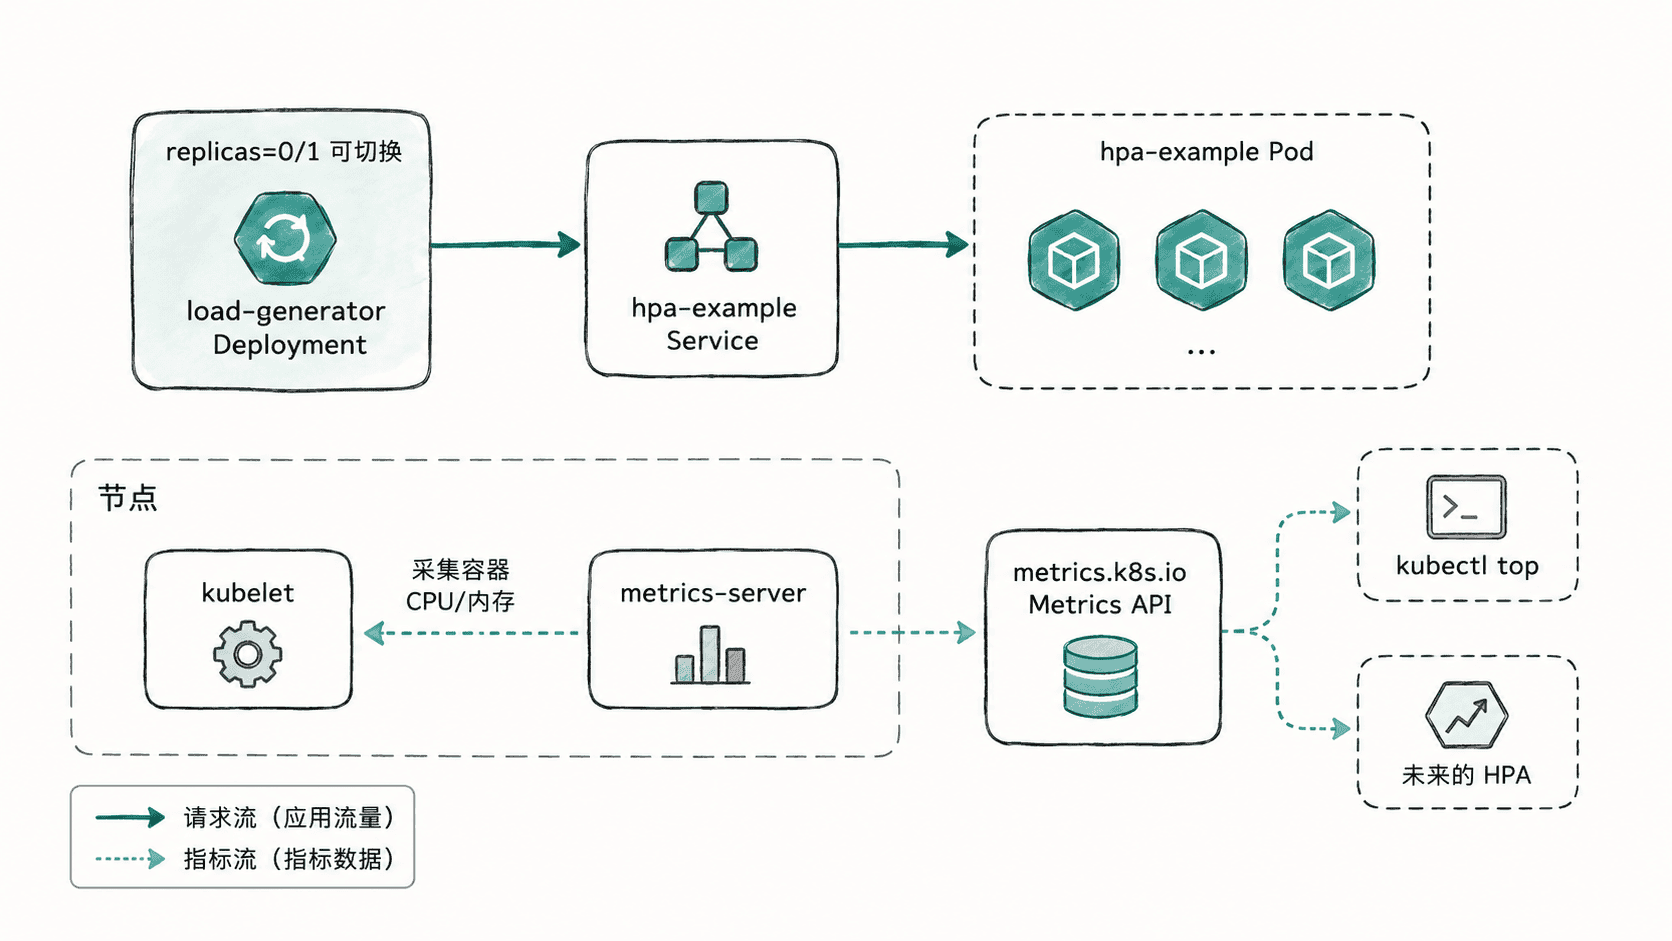
应用配置后等待测试 Pod 就绪。
kubectl apply -f autoscaling-baseline.yaml >/dev/null
kubectl wait --for=condition=Ready pod -l app=hpa-example -n autoscaling-lab --timeout=120s >/dev/null
echo "baseline workload ready"
预期输出
baseline workload ready验收指标与负载路径
metrics-server 刚启动时通常需要一个采集周期。下面的循环最多等待约 60 秒,直到测试 Pod 能返回资源指标。
for i in $(seq 1 12); do
  if output=$(kubectl top pod -n autoscaling-lab -l app=hpa-example 2>/dev/null); then
    printf '%s\n' "$output"
    exit 0
  fi
  sleep 5
done
exit 1
预期输出
NAME                           CPU(cores)   MEMORY(bytes)
hpa-example-<ID>               <VALUE>m     <VALUE>Mi
实际 Pod ID 和指标值会不同。能看到 CPU、内存数据,说明 kubelet、metrics-server 与 Metrics API 链路已经打通。
再启用负载发生器,确认请求路径可用。
kubectl scale deployment/load-generator -n autoscaling-lab --replicas=1 >/dev/null
kubectl rollout status deployment/load-generator -n autoscaling-lab --timeout=120s >/dev/null
echo "load generator running"
预期输出
load generator running等待几十秒后再次读取测试 Pod 的资源指标,CPU 使用通常会高于空闲基线。实验结束后把 load-generator 缩回 0,即可恢复统一起点。
基线不稳定时先停在这里
如果 Pod Ready 但资源指标查询一直没有数据,问题在指标链路,不应继续验证 HPA;如果指标正常但负载开启后 CPU 没有变化,应检查 Service 端点和负载发生器是否真的在请求;如果测试 Pod Pending,则先检查资源请求、节点可调度容量和污点容忍。
一套合格的实验基线只需要满足三个条件:工作负载可稳定运行、负载可控启停、资源指标可重复读取。把这三点固定下来,后续任何伸缩策略的差异才有可比较的起点。