
容器与云原生 / 系统课时
建立成本与容量反馈闭环
建立成本与容量反馈闭环
容量治理不是把利用率压到某个固定数字,而是持续比较资源成本与服务质量,再用可验证的小步调整改变 requests、HPA 目标值和节点容量边界。本课建立一套可周期执行的反馈闭环,让扩容速度、尾延迟、限流和闲置成本落到同一组决策上。
学习目标
- 用同一观察窗口关联资源利用率、扩容频率、延迟 SLO、限流事件与闲置容量
- 判断应该调整
requests、HPA 目标值还是节点容量边界,而不是同时改动所有参数 - 用变更前后对照验证成本下降没有以 SLO 退化为代价
先建立一条可比较的证据链
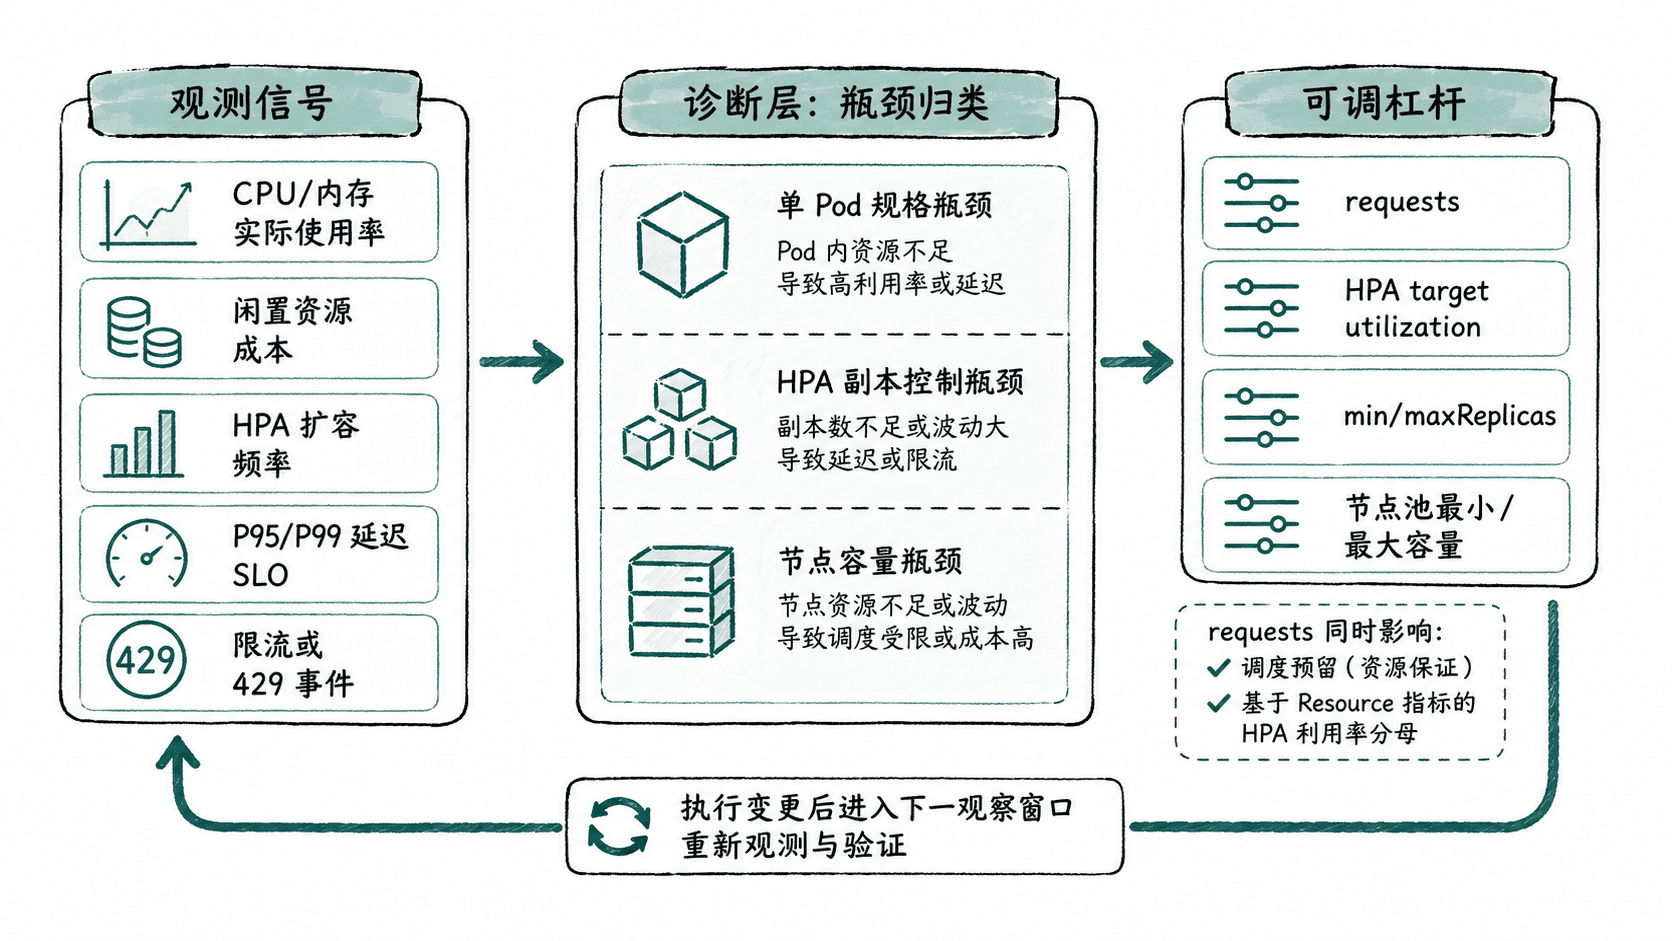
一次容量复盘至少要回答三类问题:业务是否真的繁忙、Pod 是否高效利用已申请资源、集群是否有足够空间兑现 HPA 的扩容结果。只看 CPU 利用率会漏掉排队与尾延迟,只看副本数又可能把低效 requests 当成真实容量需求。
下面的命令可以在一次复盘开始时采集工作负载和节点的即时快照。示例假设命名空间为 prod,HPA 和 Deployment 都叫 checkout,Pod 带有 app=checkout 标签。
NS=prod
APP=checkout

kubectl get hpa "$APP" -n "$NS"
kubectl top pod -n "$NS" -l app="$APP"
kubectl top node
预期输出
NAME       REFERENCE             TARGETS        MINPODS   MAXPODS   REPLICAS   AGE
checkout   Deployment/checkout   <VALUE>/<VALUE>  2         20        <VALUE>    <TIME>
NAME                    CPU(cores)   MEMORY(bytes)
checkout-<ID>            <VALUE>      <VALUE>
NAME        CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
<node> <VALUE> <VALUE> <VALUE> <VALUE><VALUE>、<ID>、<TIME> 和节点名会随环境变化。快照只说明“此刻”,真正做治理时应使用同一业务周期内的时序指标,例如最近 7 天的高峰、低谷和发布窗口。
把信号映射到正确的调节杠杆
requests 是调度器预留资源的依据,也是 Resource 类型 HPA 计算利用率时的分母。把它压得过低,会让 HPA 看见更高的利用率并更早扩容;设得过高,则会造成节点可分配容量被提前占住,也可能让 HPA 看起来“不够忙”。
HPA 目标值决定单 Pod 被推动到多高的利用水平。提高目标值通常能减少副本和成本,但也会增加单 Pod 压力;如果 P95/P99 延迟或限流事件同步恶化,就说明节省已经越过服务质量边界。目标值应来自负载测试和生产曲线,而不是照抄固定百分比。
节点容量边界决定 HPA 的扩容请求能否真正落地。即使 maxReplicas 很大,如果节点池上限容纳不了这些 Pod 的 requests 加系统和 DaemonSet 开销,最终只会得到 Pending Pod,而不是有效吞吐。
用症状组合做决策
| 观察组合 | 更可能的问题 | 优先动作 |
|---|---|---|
| 利用率长期低、SLO 充裕、扩容很少 | requests 或最小副本偏保守 |
下调 requests 或 minReplicas,一次只改一个 |
| 利用率高、扩容频繁、SLO 仍稳定 | HPA 目标偏低或 Pod 规格偏小 | 评估提高目标值,或重新校准单 Pod 规格 |
| 利用率高、P99 变差、出现限流 | 服务已接近饱和 | 降低 HPA 目标或提高最小容量,先保 SLO |
| HPA 想扩容但 Pod Pending | 节点侧容量不足 | 检查节点池上限、调度约束和可分配资源 |
| 节点长期低利用且空闲成本高 | 节点下限或 Pod 预留过高 | 收紧节点最小容量,并复核 requests |
成本目标不能单独成为变更依据。对于面向用户的在线服务,应先定义延迟、错误率或限流的不可退化边界,再在这个边界内压缩闲置资源。
按固定节奏完成闭环
一个稳定的治理周期可以按“观察—判断—改单一杠杆—验证”执行。日常只监控异常,周度或双周复盘再调整参数;发布、流量模型或实例类型发生明显变化时,应重新建立基线。
每次变更都保留变更前后的同窗口对照:峰值副本数、扩容次数、P95/P99、限流事件、Pod 与节点利用率,以及按 CPU/内存预留估算的闲置成本。若成本下降但尾延迟、错误率或排队显著变差,应回退而不是继续压缩。
最终目标不是追求最高利用率,而是让容量成本、伸缩速度和服务质量形成可解释、可回滚的控制回路;任何一次参数优化都必须能在下一观察窗口被数据证实。