
容器与云原生 / 系统课时
排查副本震荡与过度扩容
排查副本震荡与过度扩容
副本数频繁上下波动或快速冲到上限,通常不是“把阈值调高”就能解决,而是指标噪声、启动期高负载、扩缩容策略和真实业务变化共同作用的结果。本课按证据顺序定位 HPA 决策,并用 stabilization、policies、指标窗口和启动期设置消除错误反馈。
学习目标
- 从 HPA 状态、事件和指标变化定位副本震荡的触发点
- 区分真实负载增长、指标噪声与新 Pod 启动造成的误判
- 用
behavior和启动期配置限制过快扩缩容
先确认是谁在推动 desired replicas
先看 HPA 当前指标、期望副本、Conditions 和 Events,再对照 Deployment 的实际副本与 Pod Ready 时间。若 desired replicas 自己来回变化,重点查指标和 HPA 行为;若 desired 稳定但实际副本反复变化,则继续检查 Deployment、其他控制器或发布流程。
kubectl describe hpa api
kubectl get deployment api
kubectl get pods -l app=api -o wide
预期输出
Name:                     api
Reference:                Deployment/api
Metrics:                  <METRIC>: <VALUE> / <TARGET>
Min replicas:             <VALUE>
Max replicas:             <VALUE>
Deployment pods:          <VALUE> current / <VALUE> desired
Conditions:               <VALUE>
Events:                   <VALUE>

NAME   READY             UP-TO-DATE        AVAILABLE         AGE
api    <VALUE>/<VALUE>   <VALUE>           <VALUE>           <TIME>

NAME        READY   STATUS    RESTARTS   AGE      IP     NODE
<POD>       1/1     Running   <VALUE>    <TIME>   <IP>   <NODE>
实际字段会因指标类型和 Kubernetes 版本略有差异。要记录每次 desired 变化的时间,并与指标尖峰、新 Pod 启动、发布和流量变化对齐。
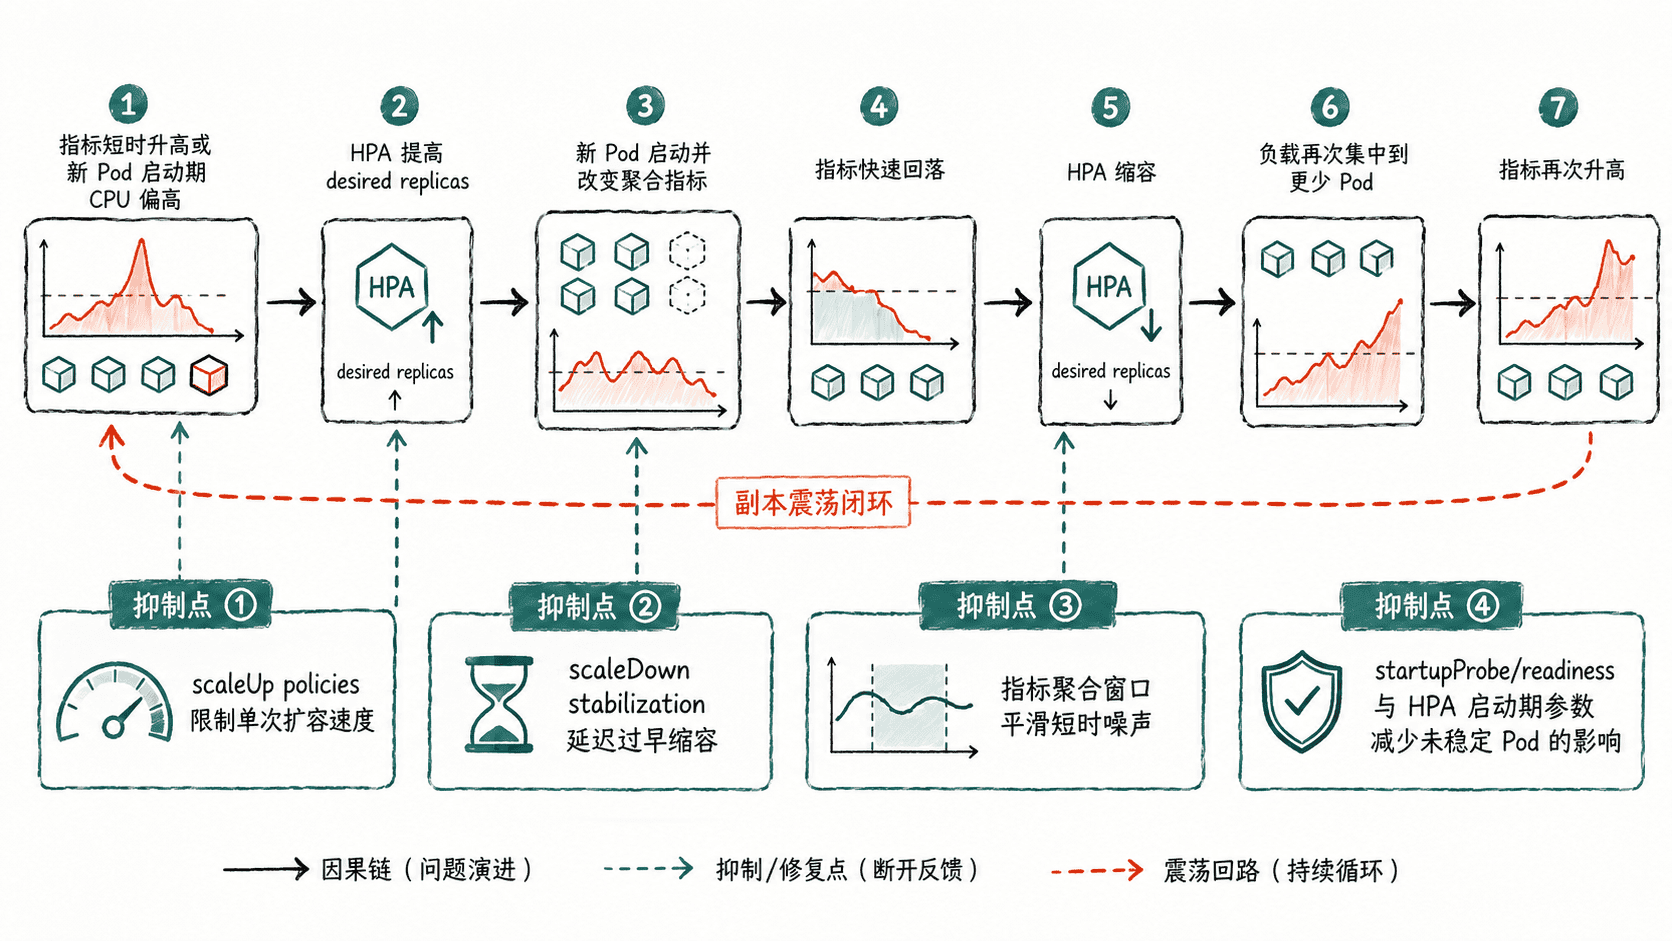
沿时间线找震荡根因
如果指标在几十秒内尖峰后快速回落,而业务请求量没有同样变化,先怀疑采集窗口过短、外部指标语义错误或单个异常 Pod 拉高平均值。对自定义或外部指标,应同时检查原始时序、聚合函数和查询窗口,避免把瞬时尖峰直接变成副本决策。
若每次扩容后,新 Pod 在启动阶段 CPU 很高,随后指标下降并触发缩容,就要检查启动探针和 Ready 时机。应用尚未完成缓存预热、JIT 或连接池建立时,不应过早被当作稳定样本或接收大量流量。
若指标变化合理,但副本一次增加过多或回落过快,则根因更可能在 behavior。这时应通过稳定窗口和速率策略限制控制器动作,而不是改变业务 SLO 来迁就错误的扩缩容节奏。
用 behavior 限制动作速度
下面的 HPA 配置把“扩得多快”和“缩得多快”分开控制。示例使用 selectPolicy: Min 选择两个扩容策略中更保守的允许值,并给缩容设置稳定窗口。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: api
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: api
  minReplicas: 4
  maxReplicas: 30
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 60
      selectPolicy: Min
      policies:
        - type: Percent
          value: 50
          periodSeconds: 60
        - type: Pods
          value: 4
          periodSeconds: 60
    scaleDown:
      stabilizationWindowSeconds: 300
      policies:
        - type: Percent
          value: 25
          periodSeconds: 60
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 65
这段配置的作用是限制变化速率并抑制短时反向决策,不会修复错误指标。若外部指标把累计值当成速率、把全局流量重复分摊到每个 Pod,HPA 仍可能持续要求扩容到 maxReplicas。
处理启动期与指标窗口
应用启动噪声应优先通过 startupProbe 和合理的 readinessProbe 表达真实就绪状态;资源指标 HPA 还受控制平面启动期相关参数影响,例如 CPU 初始化期与初始就绪延迟。托管集群未必允许修改这些控制器参数,因此先把应用探针配置正确通常更可控。
自定义或外部指标则应在指标系统中选择与业务反应时间匹配的聚合窗口。窗口太短会放大噪声,太长会拖慢真实扩容。应通过回放一次真实尖峰,比较“指标达到阈值的时间、HPA 决策时间、Pod Ready 时间、业务恢复时间”,再调整窗口。
验证修复是否消除反馈回路
修改后观察至少一个完整的升流量、稳定、降流量周期,并记录副本变化。重点不是让副本曲线完全平滑,而是保证扩容能及时跟上真实需求,缩容不会在新副本刚稳定时立刻反向。
kubectl get hpa api -w预期输出
NAME   REFERENCE        TARGETS          MINPODS   MAXPODS   REPLICAS   AGE
api    Deployment/api   <VALUE>/<VALUE>  4         30        <VALUE>    <TIME>
实际行会随着状态变化持续刷新。修复后的验收标准应同时满足:指标尖峰不会立刻触发大幅双向变化,扩容速度受 policy 控制,缩容至少经过稳定窗口,并且在真实高负载下仍能在 SLO 要求内增加足够副本。