
容器与云原生 / 系统课时
按队列积压触发伸缩
按队列积压触发伸缩
队列消费者最适合用“待处理消息量”而不是 CPU 作为主伸缩信号。本课以 RabbitMQ 的 QueueLength scaler 为例,把每个消费者期望承担的 backlog 转成副本目标,并通过生成的 HPA 验证队列增长、目标值和副本数之间的关系。
学习目标
- 为现有消费者配置 RabbitMQ 队列积压触发器和安全的认证引用。
- 根据 backlog 与单副本目标值估算所需副本数。
- 能观察扩容、回落到零以及最大副本上限是否符合预期。
先定义可验证的容量目标
假设同一命名空间中已有一个名为 worker 的 Deployment,它持续消费 RabbitMQ 队列 orders;KEDA 已安装,且集群网络可以访问 RabbitMQ。先用压测或历史数据估算单个消费者在可接受延迟内能处理的积压量,本例把目标设为每个副本 20 条待处理消息。
在默认 AverageValue 语义下,可以把稳定时的目标副本理解为:
因此 backlog 为 85 时,理论目标约为 5 个副本;随后还会受到 minReplicaCount、maxReplicaCount、HPA 稳定窗口以及队列持续生产和消费的影响。这个公式用于建立容量直觉,不意味着每次观测都会瞬时得到完全相同的副本数。
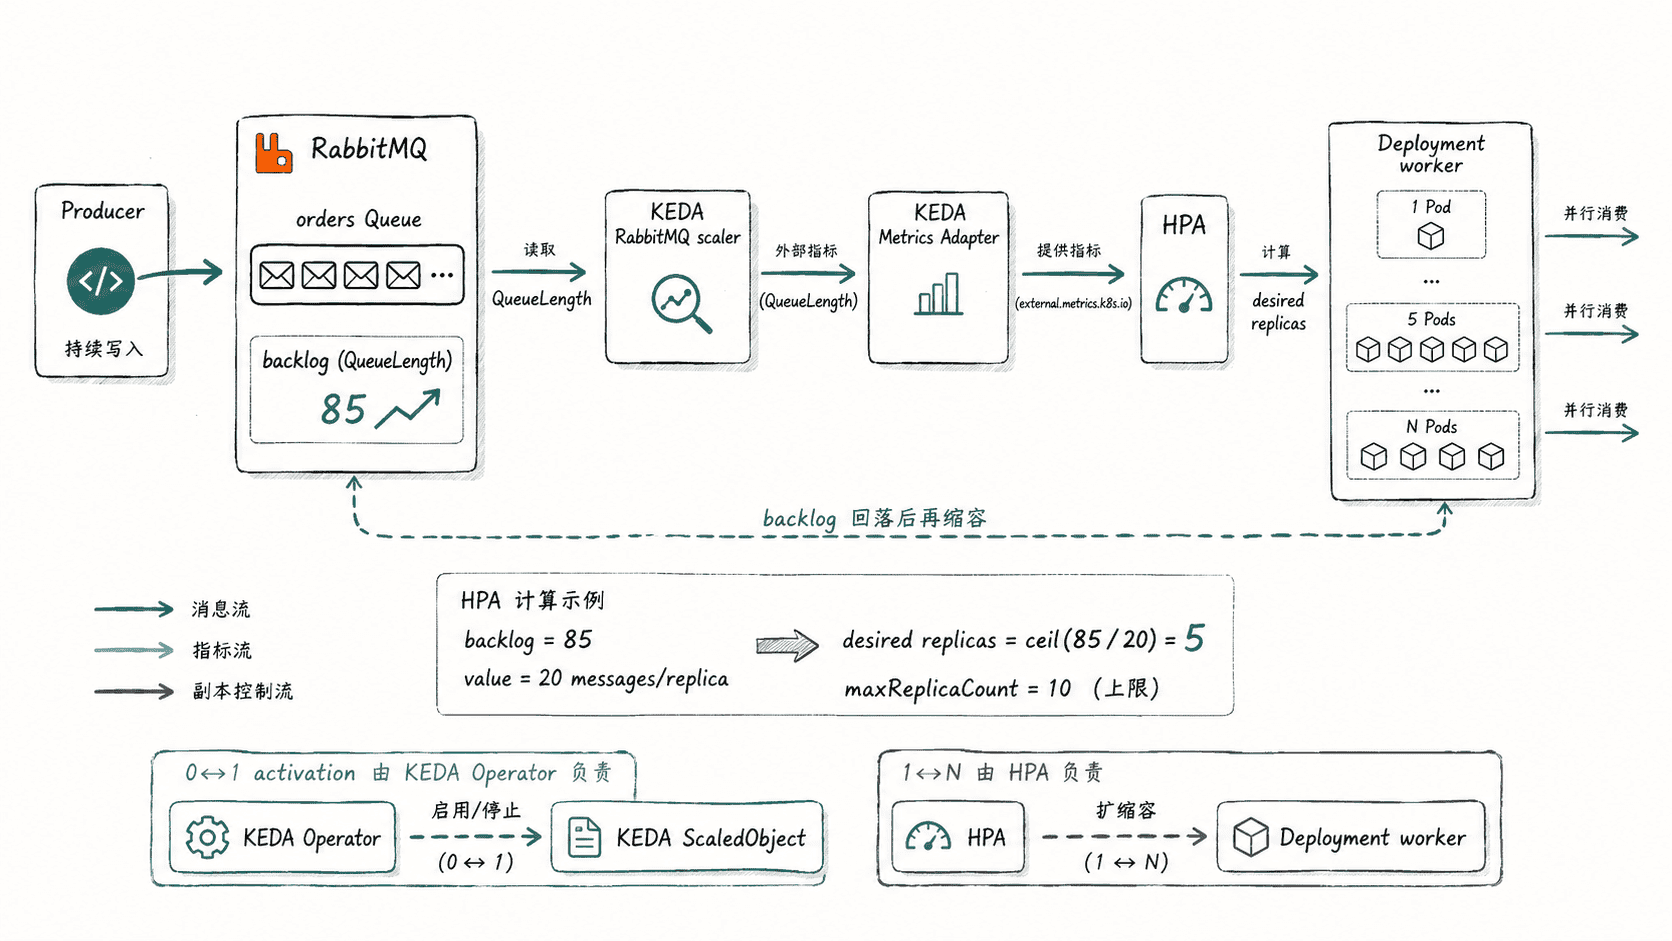
配置 RabbitMQ QueueLength scaler
下面的清单只创建 KEDA 所需的认证与伸缩对象,不创建 RabbitMQ 和 worker。把占位用户名、密码替换为测试环境凭据;生产环境应由 Secret 管理系统或工作负载身份注入,不要把真实密码提交到仓库。
apiVersion: v1
kind: Secret
metadata:
  name: rabbitmq-keda-credentials
type: Opaque
stringData:
  host: amqp://rabbitmq.default.svc.cluster.local:5672/
  username: <RABBITMQ_USERNAME>
  password: <RABBITMQ_PASSWORD>
---
apiVersion: keda.sh/v1alpha1
kind: TriggerAuthentication
metadata:
  name: rabbitmq-auth
spec:
  secretTargetRef:
    - parameter: host
      name: rabbitmq-keda-credentials
      key: host
    - parameter: username
      name: rabbitmq-keda-credentials
      key: username
    - parameter: password
      name: rabbitmq-keda-credentials
      key: password
---
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: worker-queue
spec:
  scaleTargetRef:
    name: worker
  pollingInterval: 10
  cooldownPeriod: 60
  minReplicaCount: 0
  maxReplicaCount: 10
  triggers:
    - type: rabbitmq
      metricType: AverageValue
      metadata:
        protocol: amqp
        queueName: orders
        mode: QueueLength
        value: "20"
        activationValue: "0"
      authenticationRef:
        name: rabbitmq-auth
value: "20" 是 1↔N 阶段的每副本目标;activationValue: "0" 表示队列指标大于 0 时即可从零激活。cooldownPeriod 只控制回到 0 的 KEDA 冷却过程,不等同于 HPA 在 1↔N 范围内的缩容稳定窗口。
应用配置并确认 HPA 已生成
把清单保存为 rabbitmq-scaler.yaml 后应用,并确认 KEDA 为 ScaledObject 创建了 HPA:
kubectl apply -f rabbitmq-scaler.yaml
kubectl get hpa -o name | grep keda-hpa-worker-queue
预期输出:
secret/rabbitmq-keda-credentials created
triggerauthentication.keda.sh/rabbitmq-auth created
scaledobject.keda.sh/worker-queue created
horizontalpodautoscaler.autoscaling/keda-hpa-worker-queue
如果 ScaledObject 已创建但 HPA 没出现,优先执行 kubectl describe scaledobject worker-queue 查看条件和事件。常见根因包括目标 Deployment 名称错误、认证引用缺失、RabbitMQ 地址不可达或 scaler 元数据字段写错。
用积压验证副本关系
先保证测试队列为空,观察 worker 最终能在冷却期后降到 0。然后通过现有生产者持续向 orders 写入测试消息,并在另一终端观察目标副本和实际 Pod 数:
kubectl get deployment worker -w当 backlog 在一段时间内维持在约 85 且消费速度不足以立即清空时,预期会看到 DESIRED 向约 5 收敛;实际输出中的时间和中间副本数会随 HPA 同步周期与消费速率变化:
NAME     READY   UP-TO-DATE   AVAILABLE   AGE
worker   0/0     0            0           <TIME>
worker   1/1     1            1           <TIME>
worker   5/5     5            5           <TIME>
继续提高 backlog 时,理论副本数仍按每 20 条约一个副本增加,但不会超过 maxReplicaCount: 10。停止生产并让消费者排空队列后,HPA 会先在 1↔N 范围内缩容;触发器持续不活跃并经过 cooldownPeriod 后,KEDA 再把工作负载从 1 缩到 0。
验收时不要只看“Pod 变多了”,而要同时确认三件事:backlog 上升时外部指标有效、理论副本与 HPA 目标量级一致、队列排空后副本能够按预期回落。这样才能证明伸缩策略与真实消费能力形成了闭环。