
容器与云原生 / 系统课时
设计从零启动与冷却策略
设计从零启动与冷却策略
本课把“从零启动”和“何时回到零”拆成可调参数。你将用一份 KEDA ScaledObject 配置控制唤醒延迟、活动期最低副本数与空闲回落速度,并区分 KEDA 冷却与 HPA 常规缩容的职责。
学习目标
- 解释
minReplicaCount、idleReplicaCount、pollingInterval与cooldownPeriod分别控制什么。 - 配置从 0 唤醒后直接进入活动基线的 scale-to-zero 策略。
- 根据冷启动成本、突发间隔与指标查询压力调整轮询和冷却时间。
四个参数如何组成状态机
对轮询型 scaler 来说,副本为 0 时由 KEDA 按 pollingInterval 检查触发源;一旦触发器变为 active,KEDA 负责把工作负载从 0 唤醒,随后 1 到 N 的伸缩主要交给 HPA。cooldownPeriod 只控制触发器最后一次 active 之后回到 0 的等待时间,不是通用的 N 到 1 缩容稳定窗口。:contentReference[oaicite:0]{index=0}
minReplicaCount 是活动期的最低副本数。若同时设置 idleReplicaCount: 0,空闲时可以保持 0,触发器重新活跃时则先跳到 minReplicaCount,再由 HPA 按指标继续扩容。当前 KEDA 对 idleReplicaCount 实际只支持值 0,而且它必须小于 minReplicaCount;如果希望始终保留 N 个 Pod,应省略该字段并直接把 minReplicaCount 设为 N。:contentReference[oaicite:1]{index=1}
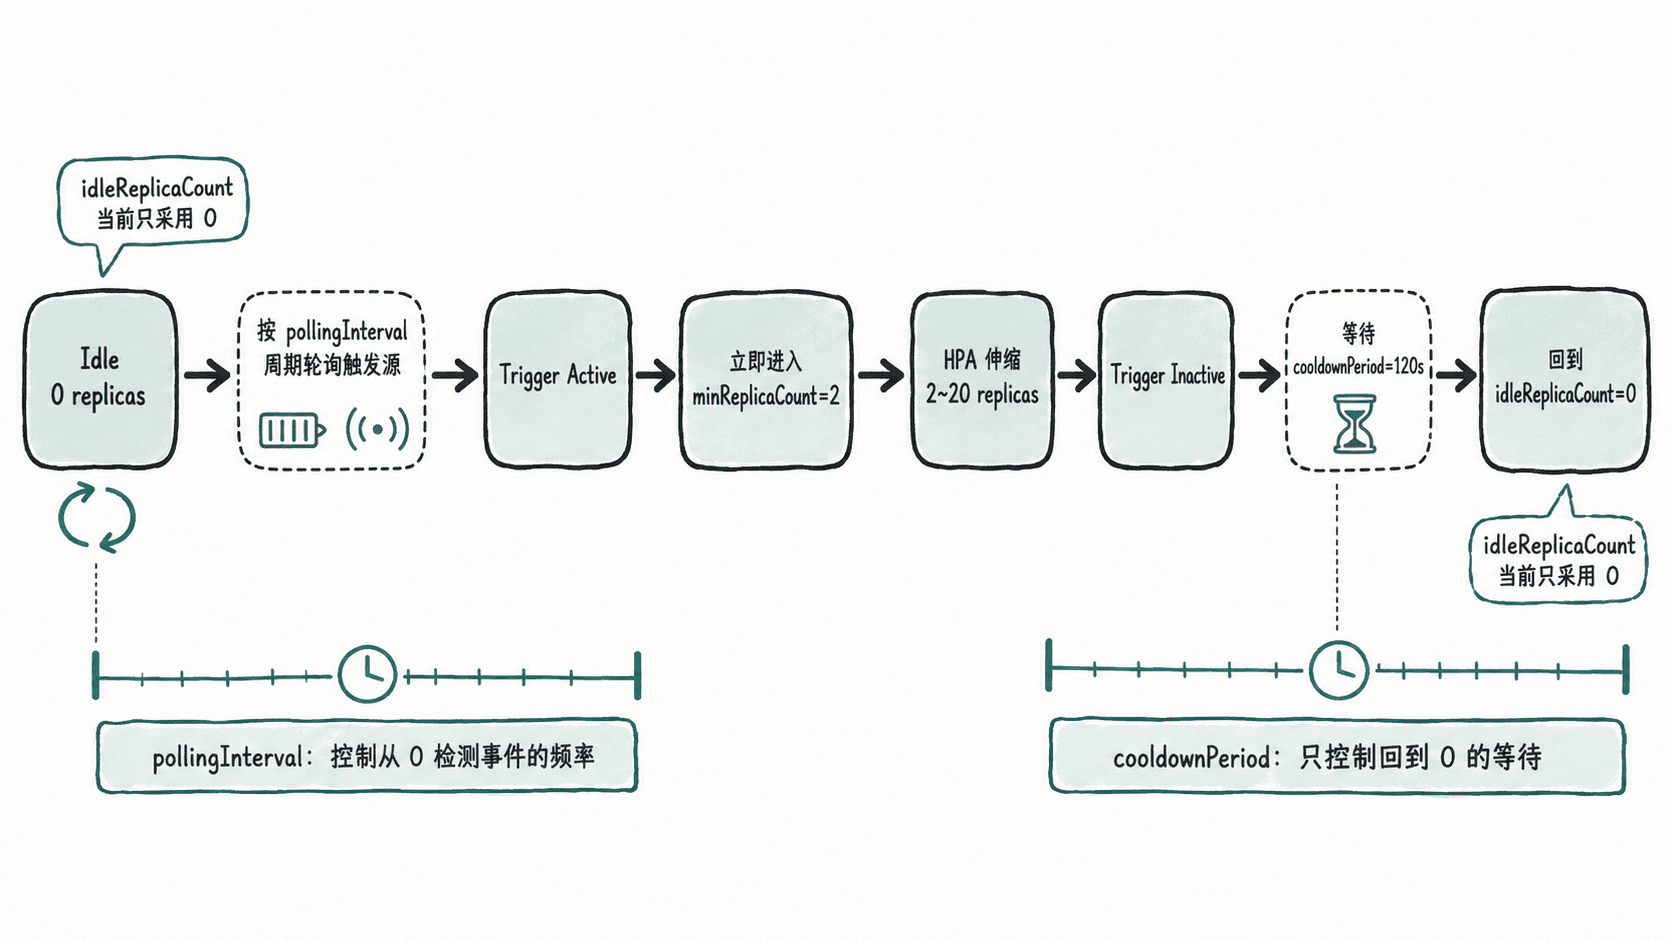
对于需要从 0 启动的轮询型触发器,冷启动总时间还包括调度、镜像拉取、进程启动和 Readiness。pollingInterval 只能压缩“发现事件”这一段,因此把它从 30 秒降到 5 秒并不能解决一个本身需要 40 秒启动的应用。
配置一条可控的 scale-to-zero 策略
下面假设集群已经安装 KEDA,存在名为 orders-worker 的 Deployment,并且 Prometheus 服务可通过示例地址访问,查询 sum(orders_backlog) 能返回单个数值。这里让空闲副本为 0,检测到积压后先拉到 2 个副本,再允许 HPA 扩到 20 个。
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: orders-worker
  namespace: default
spec:
  scaleTargetRef:
    name: orders-worker
  pollingInterval: 10
  cooldownPeriod: 120
  idleReplicaCount: 0
  minReplicaCount: 2
  maxReplicaCount: 20
  triggers:
    - type: prometheus
      metadata:
        serverAddress: http://prometheus-operated.monitoring.svc.cluster.local:9090
        query: sum(orders_backlog)
        threshold: "20"
        activationThreshold: "0"
activationThreshold: "0" 表示指标大于 0 才激活该 scaler;threshold: "20" 则是进入 HPA 阶段后的伸缩目标。配置文件本身不保证指标存在,部署前应先在 Prometheus 中确认查询返回单个标量或单元素向量。
验证启动与回落节奏
保存为 scaledobject.yaml 后应用,并回读四个关键字段,先确认控制参数没有被写错。
kubectl apply -f scaledobject.yaml
kubectl get scaledobject orders-worker -n default -o jsonpath='{.spec.pollingInterval}{"\n"}{.spec.cooldownPeriod}{"\n"}{.spec.idleReplicaCount}{"\n"}{.spec.minReplicaCount}{"\n"}'
预期输出
scaledobject.keda.sh/orders-worker created
10
120
0
2
如果对象已经存在,第一行可能显示 configured。随后让 orders_backlog 从 0 变为正数并观察 Deployment:处于 0 副本时,轮询型 scaler 最坏还要等待接近一个 pollingInterval 才能发现事件;激活后先进入 2 个副本。积压清零并持续不活跃 120 秒后,KEDA 才具备回到 0 的条件。
调参时先守住两个边界
pollingInterval 越短,0 副本时的发现延迟通常越低,但对 Prometheus、消息队列或云 API 的查询压力越高。它应由“允许多晚发现第一批请求”反推,而不是盲目设成最小值。
cooldownPeriod 太短会让短暂空闲触发反复冷启动,太长则会让零副本策略失去节省能力。实践中应至少覆盖常见的短空闲间隔,并结合 Pod 的 P95/P99 启动时间判断是否值得回到 0。若业务对首请求延迟非常敏感,最有效的手段通常不是继续缩短冷却,而是保留非零基线。