
容器与云原生 / 系统课时
处理调度约束与扩容冲突
处理调度约束与扩容冲突
节点数量增加并不等于 Pod 一定能调度。本课用一条固定证据链判断 Pending 到底是资源不足,还是 nodeSelector、Affinity、Taints、拓扑、PVC 与资源碎片共同造成的“有容量但不可用”,并建立扩容后的二次校验路径。
学习目标
- 区分真实容量不足与调度约束冲突,避免盲目继续加节点。
- 按调度器证据定位标签、污点、拓扑、PVC 与资源碎片问题。
- 在节点扩容后验证新增容量是否真正转化为可运行副本。
先判断“没容量”还是“容量不可用”
Pending 只说明当前没有可接受的放置结果。调度器会同时检查节点标签与 Affinity、Taints/Tolerations、拓扑分布、卷拓扑以及 CPU、内存等资源请求。节点自动扩容只有在某个可扩节点模板能够满足这些硬约束时才有意义;如果没有任何候选节点类型匹配,继续扩容不会改变结果。
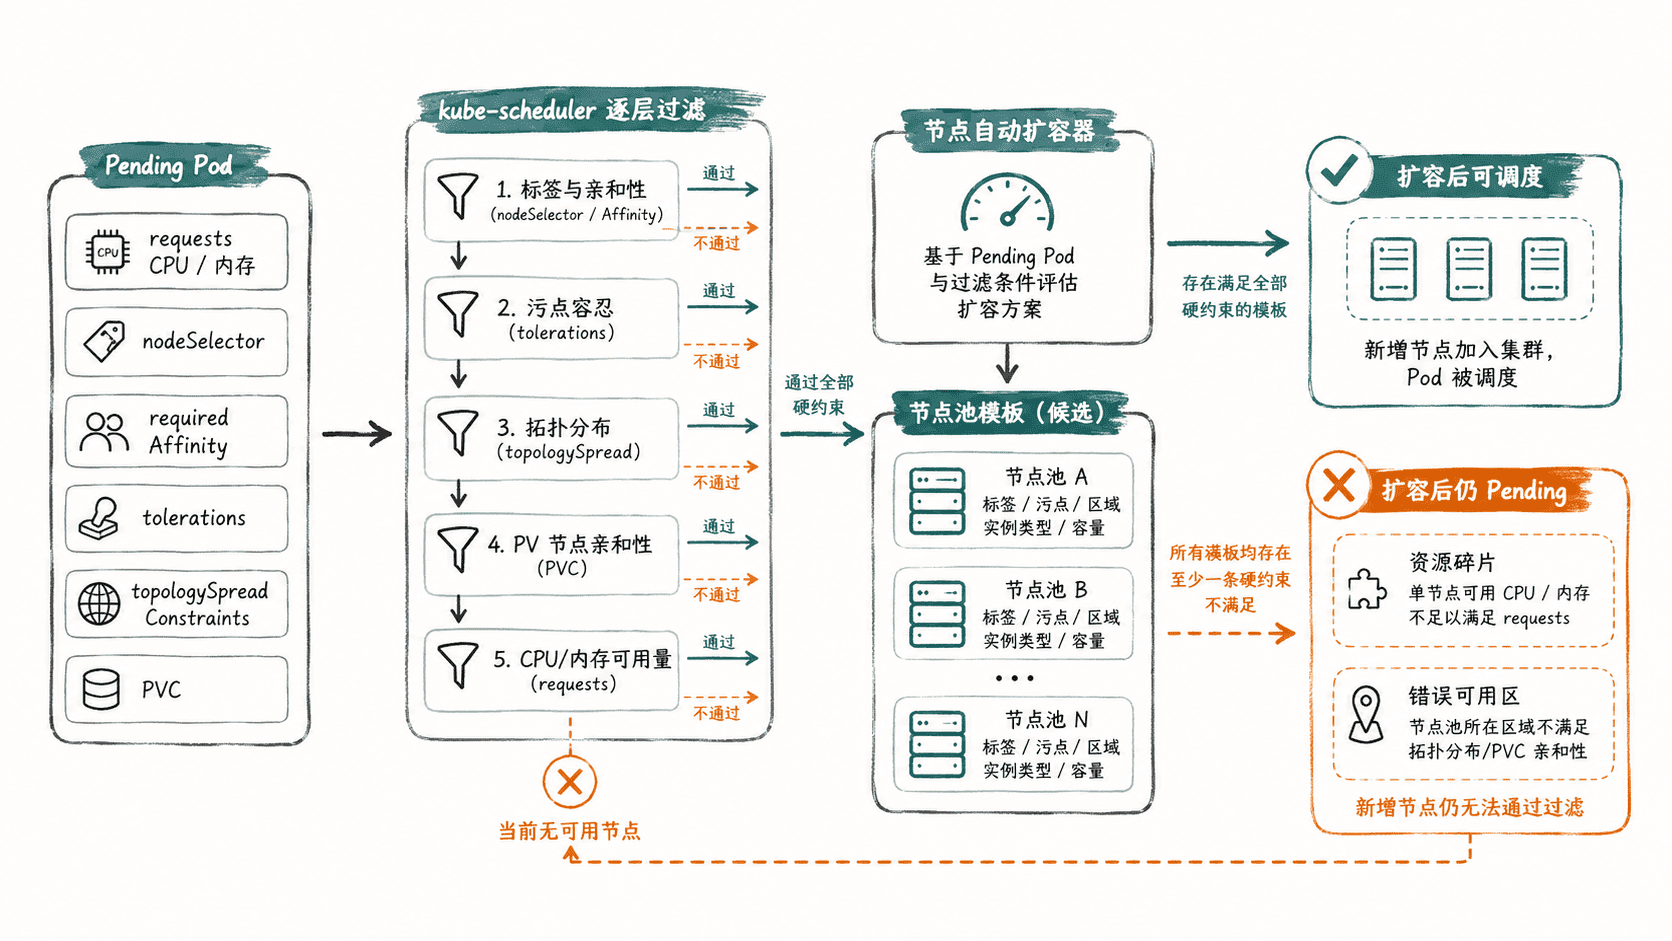
最容易误判的是“集群总资源还很多”。调度是按单个节点完成的:一个请求 3500m CPU 的 Pod,无法使用两台各剩 2000m 的节点。类似地,PVC 已绑定到某个可用区时,新增到其他可用区的节点对它等于不存在。
按固定顺序读取调度证据
先从 Pod 的调度事件开始,再核对节点与存储约束。下面的命令不修改资源,适合直接用于现场排查;将尖括号占位符替换为实际值。
kubectl get pod -A --field-selector=status.phase=Pending -o wide
kubectl describe pod -n <NAMESPACE> <POD>
kubectl get nodes -L topology.kubernetes.io/zone,<LABEL_KEY>
kubectl get node <NODE> -o jsonpath='{.spec.taints}{"\n"}'
kubectl get pvc -n <NAMESPACE> <PVC> -o wide
kubectl get pv <PV> -o yaml
预期输出会包含一条或多条调度失败原因,实际节点数、名称与顺序可能不同:
Warning  FailedScheduling  <TIME>  default-scheduler
0/6 nodes are available: 2 node(s) had untolerated taint {workload: batch},
2 node(s) didn't match Pod's node affinity/selector, 2 Insufficient cpu.
看到 didn't match Pod's node affinity/selector,优先检查 nodeSelector 与 requiredDuringSchedulingIgnoredDuringExecution;看到 untolerated taint,检查目标节点池的 Taint 与 Pod 的 Toleration 是否成对;看到 volume node affinity conflict,继续查看 PV 的 nodeAffinity 与目标可用区。Insufficient cpu 或 Insufficient memory 则要比较每个节点的剩余可分配量与 Pod 的 requests,而不是只看集群总和。
把扩容模型与硬约束对齐
需要先区分“硬条件”和“偏好”。nodeSelector、required Affinity、未被容忍的 Taint、whenUnsatisfiable: DoNotSchedule 的拓扑分布,以及已绑定 PV 的节点亲和性都会直接排除节点;preferred Affinity 与 ScheduleAnyway 通常只影响优先级,不会单独让 Pod 永久 Pending。
对节点自动扩容器而言,关键问题是:它能否创建一个同时满足这些条件的节点。如果工作负载要求 workload=gpu,但所有可扩节点池模板都没有该标签;或者 PVC 固定在 zone-a,而只有 zone-b 节点池允许扩容,那么“扩容器运行正常”与“这个 Pod 能被解决”是两回事。
资源碎片也要单独处理。大量小 Pod 可能把 CPU 与内存切成不连续余量,使新来的大 Pod 无处放置。此时更有效的动作通常是调整 requests、重新规划节点规格,或让节点池提供能承载该 Pod 的实例尺寸,而不是只提高节点数量上限。
扩容后做二次校验
节点变成 Ready 只是第一层成功。还要继续确认新增节点具有预期标签与 Taint、位于允许的拓扑域,Pending Pod 的调度事件是否消失,以及 PVC/PV 是否与新节点拓扑一致。最后检查 Pod 是否进入 Running 且就绪副本恢复到工作负载目标值。
如果节点已经增加而同一条 FailedScheduling 原因持续出现,说明问题仍属于约束不匹配;如果失败原因从 Insufficient cpu 变为其他约束,则说明扩容解决了容量问题,但暴露了下一层过滤条件。只有当调度失败事件消失、Pod 成功绑定节点并进入 Ready,新增容量才真正完成了从“节点数量”到“工作负载能力”的转化。