
容器与云原生 / 系统课时
排查扩容后 Pod 仍 Pending
排查扩容后 Pod 仍 Pending
HPA 已把工作负载副本数拉高,并不代表新增 Pod 一定能落到节点。本篇从 FailedScheduling 出发,串联 requests、节点选择约束与节点自动扩缩容,最终用可调度性验证修复是否真正闭环。
学习目标
- 区分 HPA 扩容成功、Pod 创建失败与 Pod 调度失败三种不同故障。
- 从
FailedScheduling反推出资源请求、标签、污点和拓扑约束。 - 判断节点自动扩缩容为何没有提供兼容容量,并完成闭环验证。
先确认故障停在哪一层
先确认 Deployment 的期望副本是否已经上升,再看新增 Pod 是否真的被创建。若 HPA 的期望副本增加、ReplicaSet 也创建了 Pod,而 Pod 处于 Pending 且没有 spec.nodeName,问题才进入调度链路。
下面的主示例假定工作负载位于 elastic-demo 命名空间,标签为 app=checkout。实际名称不同就替换变量。
NS=elastic-demo
APP=checkout
kubectl -n "$NS" get deploy "$APP"
kubectl -n "$NS" get hpa
kubectl -n "$NS" get pods -l app="$APP" -o wide
POD=$(kubectl -n "$NS" get pods -l app="$APP" --field-selector=status.phase=Pending -o jsonpath='{.items[0].metadata.name}')
kubectl -n "$NS" describe pod "$POD"
预期输出的关键形态如下,副本数、节点数与时间会因环境而不同。
NAME       READY   UP-TO-DATE   AVAILABLE   AGE
checkout   4/8     8            4           <TIME>

NAME       REFERENCE              TARGETS    MINPODS   MAXPODS   REPLICAS   AGE
checkout   Deployment/checkout    <VALUE>    2         10        8          <TIME>

NAME                         READY   STATUS    NODE
checkout-<ID>                0/1     Pending   <none>

Events:
  Type     Reason            Age      From               Message
  Warning  FailedScheduling  <TIME>   default-scheduler  0/<VALUE> nodes are available: <VALUE> Insufficient cpu, <VALUE> node(s) didn't match Pod's node affinity/selector.
如果没有任何 Pending Pod,而 ReplicaSet 事件是 FailedCreate,应先检查 ResourceQuota、准入策略或对象创建错误;这类故障不会通过增加节点解决。
从 FailedScheduling 反推真实约束
调度器判断的是 Pod 的资源请求和调度约束,不是容器此刻的 CPU、内存实际使用率。最常见的证据可分为四类:Insufficient cpu/memory 指向 requests 与节点可分配资源;didn't match node affinity/selector 指向标签约束;untolerated taint 指向污点与容忍;卷拓扑或跨区约束则需要继续检查 PVC、PV 与节点拓扑。
先把 Pending Pod 声明的 requests 与约束完整读出来,再与候选节点对照。
kubectl -n "$NS" get pod "$POD" -o jsonpath='{range .spec.containers[*]}{.name}{" cpu="}{.resources.requests.cpu}{" memory="}{.resources.requests.memory}{"\n"}{end}'
kubectl -n "$NS" get pod "$POD" -o jsonpath='nodeSelector={.spec.nodeSelector}{"\n"}affinity={.spec.affinity}{"\n"}tolerations={.spec.tolerations}{"\n"}'
kubectl get nodes -o custom-columns='NAME:.metadata.name,CPU:.status.allocatable.cpu,MEMORY:.status.allocatable.memory'
kubectl get nodes --show-labels
预期输出应能把“需要什么”和“节点有什么”放到同一证据链中。
app cpu=750m memory=768Mi
nodeSelector={"workload":"general"}
affinity=<VALUE>
tolerations=<VALUE>
NAME      CPU      MEMORY
<NAME>    <VALUE>  <VALUE>
<NAME>   Ready   <VALUE>   <TIME>   <VERSION>   workload=general,<VALUE>
如果 Pod 还包含 init container 或 Pod overhead,仅看业务容器的 requests 可能低估调度器看到的有效请求;此时还要检查 spec.initContainers 与 spec.overhead。节点的 Allocatable 也不是“当前空闲量”,必要时再用 kubectl describe node 对照已分配 requests。
判断新增节点为什么仍然不兼容
节点自动扩缩容通常依据“不可调度 Pod 的约束”与“允许创建的节点类型或节点池约束”决定是否扩容。即使集群还有扩容能力,只要允许的新节点没有所需标签、实例规格放不下该 Pod、节点池达到上限,或云侧配额与容量不足,Pending 仍会持续。
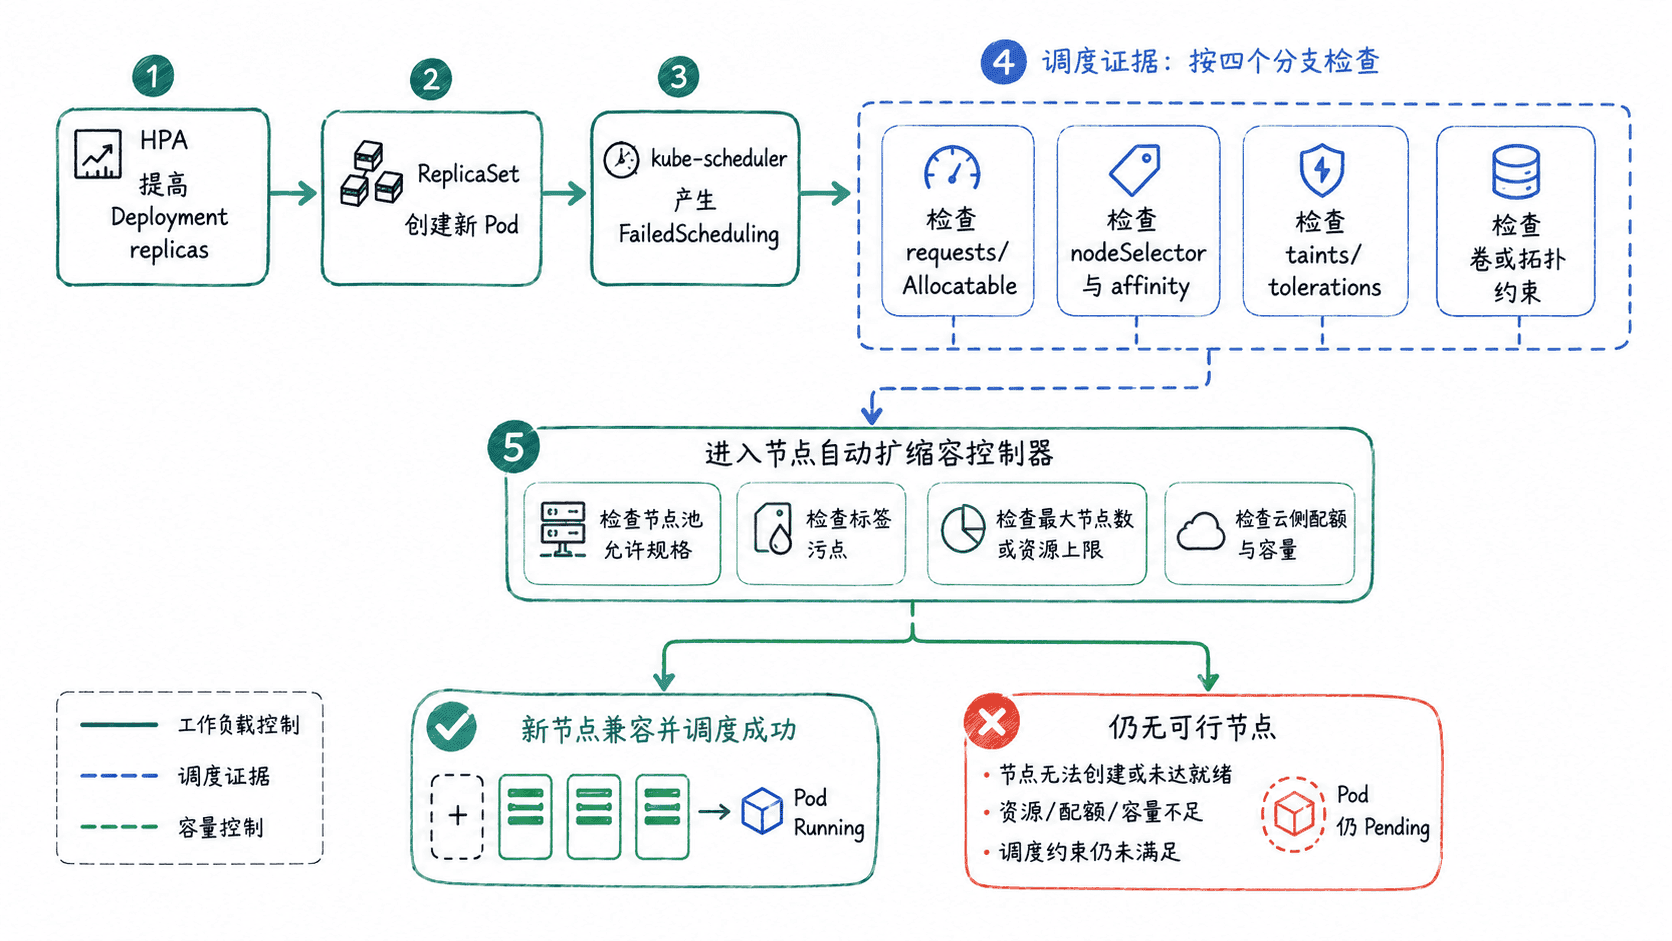
不同节点自动扩缩容实现的日志格式不同,因此先定位控制器,再读取与故障窗口一致的日志,不要凭固定字符串判断。
kubectl get deploy -A | grep -Ei 'cluster-autoscaler|karpenter'
AUTOSCALER_NAMESPACE="<AUTOSCALER_NAMESPACE>"
AUTOSCALER_DEPLOYMENT="<AUTOSCALER_DEPLOYMENT>"
kubectl -n "$AUTOSCALER_NAMESPACE" logs deploy/"$AUTOSCALER_DEPLOYMENT" --since=10m
预期结果至少应先确认控制器所在位置;日志正文以实际实现为准。
<AUTOSCALER_NAMESPACE>   <AUTOSCALER_DEPLOYMENT>   1/1   1   1   <TIME>
<VALUE>
把日志与 FailedScheduling 对齐后再修复:资源确实不足就增加能容纳该 Pod 的节点规格或节点数;标签、污点、可用区不匹配就调整节点池或工作负载约束;达到平台上限则先处理配额或上限。若单个 Pod 的 requests 大于所有可创建节点的可分配资源,单纯把节点数量加倍也不会成功。
用调度成功完成闭环验证
修复后不要只看“新增了一台节点”。真正的验收条件是:原 Pending Pod 获得 spec.nodeName 并进入 Running,Deployment 达到期望可用副本,新的 FailedScheduling 不再持续出现;同时 HPA 仍能读取指标,避免容量问题修好后又留下指标链路故障。
kubectl -n "$NS" rollout status deploy/"$APP" --timeout=5m
kubectl -n "$NS" get pods -l app="$APP" --field-selector=status.phase=Pending
kubectl -n "$NS" get hpa
预期结果如下;HPA 的实时指标值会随负载变化。
deployment "checkout" successfully rolled out
No resources found in elastic-demo namespace.
NAME       REFERENCE             TARGETS   MINPODS   MAXPODS   REPLICAS   AGE
checkout   Deployment/checkout   <VALUE>   2         10        <VALUE>    <TIME>
只要 Pending 原因仍在重复出现,就说明容量链路尚未闭环。最终应让调度约束、节点池能力和 HPA 最大副本三者互相兼容,而不是依赖临时手工扩节点兜底。