
容器与云原生 / 系统课时
保留容量余量与故障缓冲
保留容量余量与故障缓冲
容量治理的目标不是让集群“越满越好”,而是保证在流量突增、扩容尚未完成、节点失效或滚动发布时仍有可立即使用的资源。本课把这些风险拆成可计算的缓冲来源,并给出工作负载与节点两层的落地检查方法。
学习目标
- 区分流量、扩容延迟、节点故障和发布带来的容量缓冲
- 用最坏可接受场景反推副本与节点余量
- 用 Kubernetes 指标验证余量是否真实可用
先把“余量”分成两层
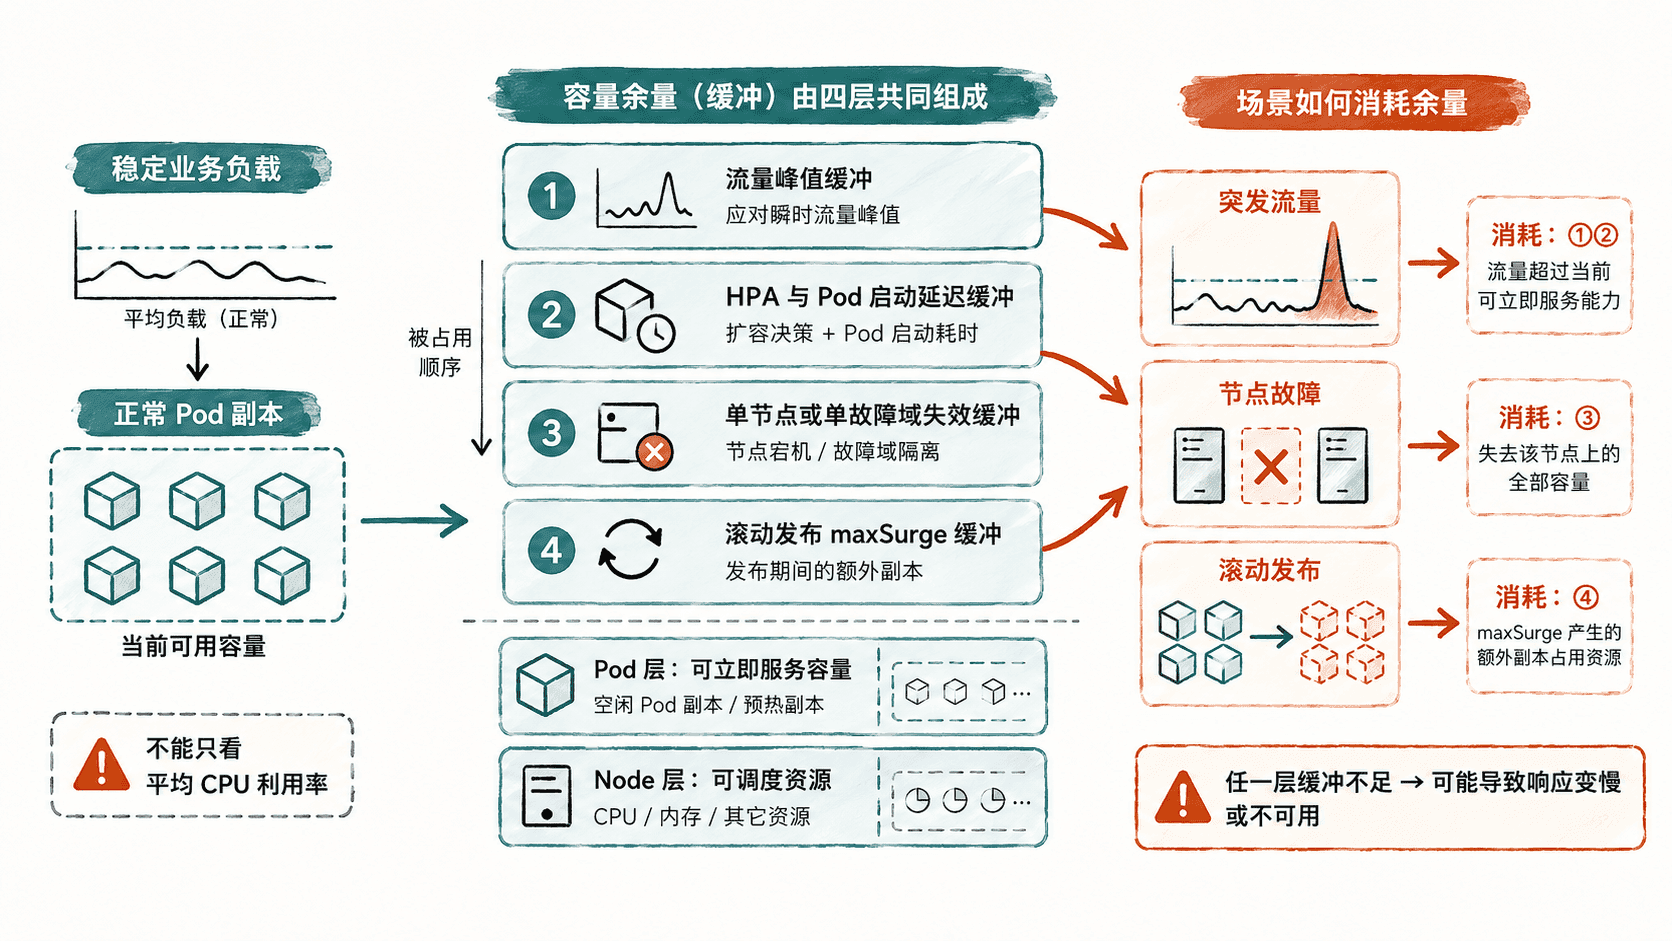
Pod 层余量解决的是“现在就能接流量”的问题。即使 HPA 可以把副本从 10 扩到 20,新 Pod 仍要经历指标采集、调度、拉镜像、启动和就绪,因此当前副本必须能够吸收这段延迟内的增长。
Node 层余量解决的是“新 Pod 有地方调度”的问题。若所有节点的可分配资源都已被 requests 占满,HPA 即使提高 desired replicas,也只会得到 Pending Pod,并把真正的恢复时间推迟到节点扩容完成之后。
用故障场景反推缓冲
不要先规定“集群保持 30% 空闲”再找理由,而要从恢复目标反推。至少分别估算四项:峰值期间在一次扩容完成前新增的负载、一个节点或故障域丢失后需要迁移的 requests、发布时 maxSurge 增加的临时副本,以及业务自身不可突降的最低副本数。
这些需求不一定机械相加。应选择组织能够接受的并发故障场景,再取其所需容量。例如“高峰期允许同时滚动发布,但不要求再承受一个完整可用区丢失”和“高峰期必须承受一个节点丢失”是两种不同的容量承诺。
把余量落实到工作负载
关键服务的 minReplicas 应覆盖正常流量和最小故障缓冲,maxReplicas 则必须落在集群能够实际承载的范围内。滚动发布还要把 maxSurge 算入瞬时容量,否则发布和自动扩容会同时争夺节点资源。
下面的片段示例展示一个保守的关键服务边界,具体数字必须用压测数据和故障演练校准。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: checkout
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: checkout
  minReplicas: 6
  maxReplicas: 20
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 60
生效后,HPA 不会把该服务缩到 6 个副本以下;当需求回落时,缩容还会受稳定窗口约束。验证时要继续检查这些副本是否都能在现有节点上调度,而不是只确认 HPA 对象已接受配置。
验证缓冲是否真的存在
先同时观察 HPA 和节点资源,再进行受控流量或故障演练。下面的命令适合做一次快速基线检查。
kubectl get hpa checkout
kubectl top nodes
kubectl get pods -l app=checkout -o wide
预期输出
NAME       REFERENCE             TARGETS          MINPODS   MAXPODS   REPLICAS   AGE
checkout   Deployment/checkout   <VALUE>/<VALUE>  6         20        <VALUE>    <TIME>
NAME       CPU(cores)   CPU%      MEMORY(bytes)   MEMORY%
<NODE>     <VALUE>      <VALUE>%  <VALUE>         <VALUE>%
NAME             READY   STATUS    RESTARTS   AGE      IP     NODE
<POD>            1/1     Running   <VALUE>    <TIME>   <IP>   <NODE>
实际数值会随负载变化。验收重点是:高峰或故障演练时新副本能及时调度并进入 Ready,节点仍保留满足恢复目标的 requests 空间,发布期间不会因为 maxSurge 把集群推到 Pending 边缘。容量余量只有在这些场景下能被立即消费并完成恢复,才算真正存在。