
容器与云原生 / 系统课时
理解动态节点供给
理解动态节点供给
动态节点供给解决的是“已有节点放不下 Pod 时,应该创建什么样的节点”。它不是简单把某个节点组的数量加一,而是把 Pod 的资源请求、架构、可用区和节点池约束一起求解,再创建能够真正承载这些 Pod 的节点。
学习目标
- 说清动态节点供给从 Pending Pod 到新节点 Ready 的关键链路
- 理解
requests、架构、可用区与实例约束如何共同缩小候选节点范围 - 能比较 Karpenter 式动态供给与传统固定节点组扩容的差异
从不可调度 Pod 反推节点需求
动态供给通常从“Pod 暂时无法被现有节点调度”开始。供给器读取 Pod 的 CPU、内存等 requests,同时考虑 nodeSelector、节点亲和性、污点容忍、拓扑约束,以及节点上需要预留给系统组件和 DaemonSet 的资源。
因此,决定新节点大小的是调度所需容量,而不是 Pod 最近一段时间的实际 CPU 使用率。一个容器即使当前几乎空闲,只要声明了较大的 requests,调度器和节点供给器就必须按这个请求预留空间。
下面的 Pod 用于制造一个明确的容量与位置需求。请把 <ZONE> 替换为集群实际可用区;如果现有节点已经满足这些条件,它会直接被调度,不一定触发新节点。
apiVersion: v1
kind: Pod
metadata:
  name: capacity-probe
spec:
  restartPolicy: Never
  nodeSelector:
    kubernetes.io/arch: amd64
    topology.kubernetes.io/zone: <ZONE>
  containers:
    - name: pause
      image: registry.k8s.io/pause:3.10
      resources:
        requests:
          cpu: "3500m"
          memory: "6Gi"
应用并观察状态:
kubectl apply -f capacity-probe.yaml
kubectl get pod capacity-probe -w
预期输出
pod/capacity-probe created
capacity-probe   0/1   Pending   0   <TIME>
capacity-probe   1/1   Running   0   <TIME>
如果出现从 Pending 到 Running 的变化,并且期间创建了新节点,说明供给链路已经完成。实际等待时间会受云 API、镜像启动和节点初始化影响。
约束如何合并成候选节点
Karpenter 一类方案不会只看“还缺多少 CPU”。它会把 Pod 要求与 NodePool 允许的范围取交集:Pod 要求 amd64,NodePool 就不能选择仅支持 arm64 的节点;Pod 被限制在某个可用区,新实例也必须能在该区域启动;NodePool 对容量类型、实例家族或代际的限制也会继续缩小候选集合。
下面是 AWS 场景中的 NodePool 片段示例,它依赖集群中已经存在名为 default 的 EC2NodeClass,用于说明约束边界而不是作为独立安装脚本。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: general
spec:
  template:
    spec:
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
      requirements:
        - key: kubernetes.io/arch
          operator: In
          values: ["amd64", "arm64"]
        - key: topology.kubernetes.io/zone
          operator: In
          values: ["<ZONE_A>", "<ZONE_B>"]
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["on-demand", "spot"]
        - key: karpenter.k8s.aws/instance-category
          operator: In
          values: ["c", "m", "r"]
该配置生效后,NodePool 只声明“哪些节点可以被创建”;Pod 再给出“当前工作负载必须满足什么”。云厂商相关的子网、安全组、镜像和实例身份等细节由 NodeClass 一侧承载。若两边约束没有交集,正确结果不是强行创建节点,而是 Pod 继续 Pending,并在供给器事件或日志中暴露不可满足的原因。
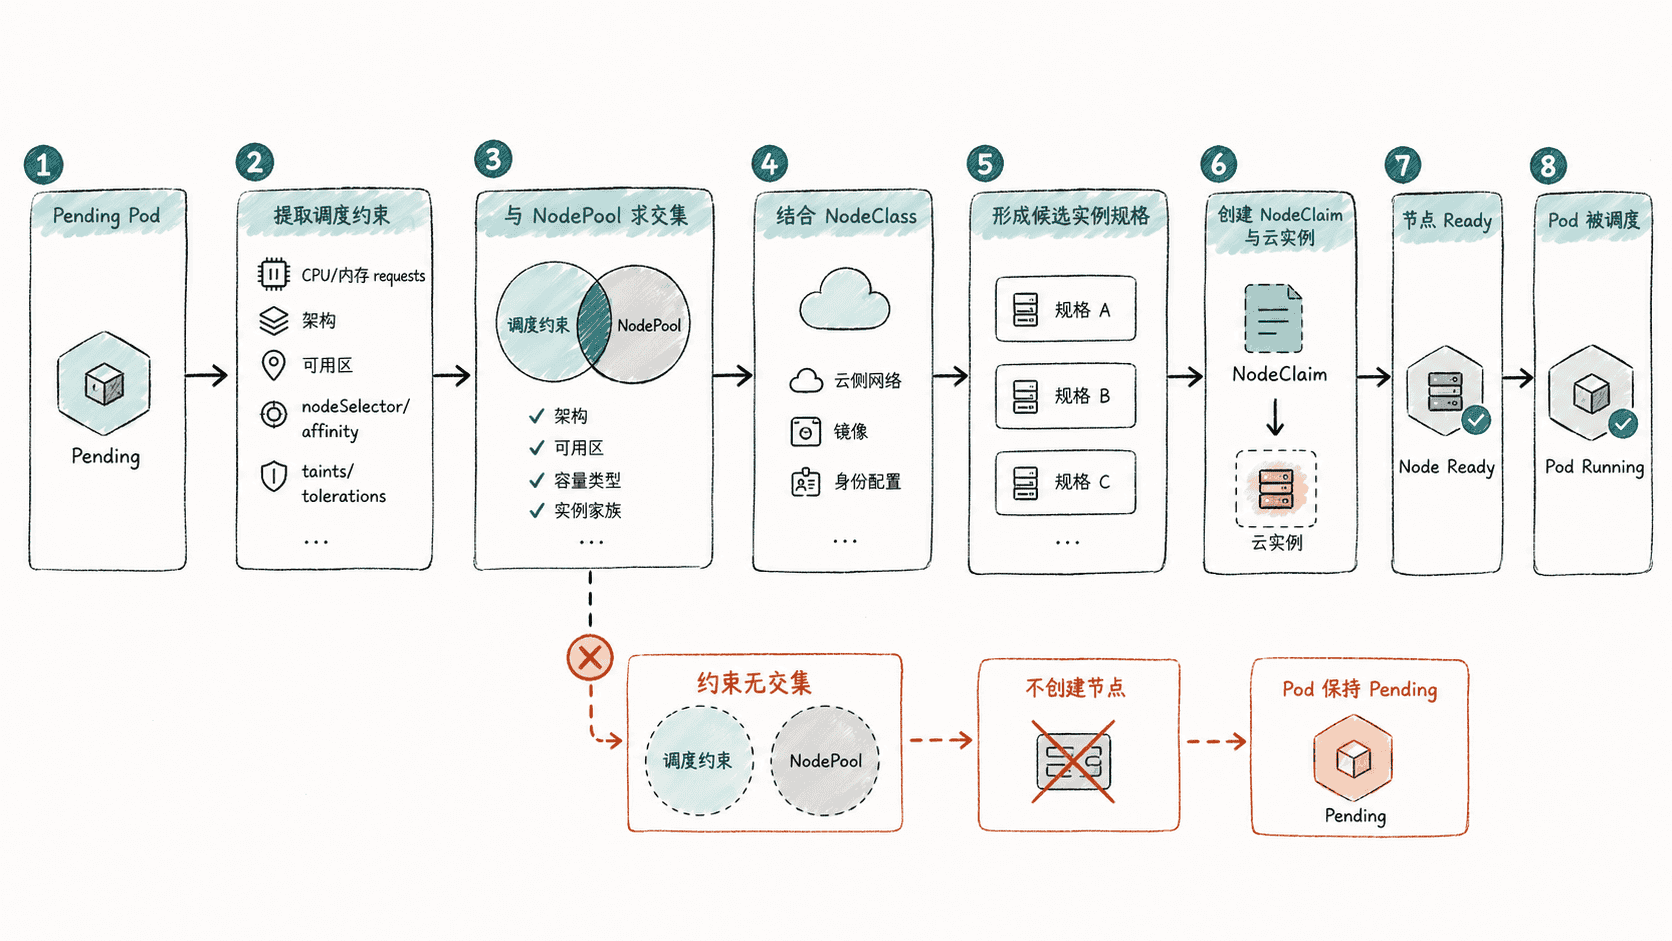
与传统节点组扩容的差异
传统节点组通常先定义一组相对固定的节点模板,再由节点自动伸缩器决定把某个组的期望节点数增加多少。动态供给则更接近“按当前 Pending Pod 现场选择节点”:它可以在允许范围内从更多实例规格、可用区和容量类型中挑选满足约束的组合。
| 维度 | 传统节点组 | 动态节点供给 |
|---|---|---|
| 扩容单位 | 已定义节点组中的节点 | 根据当前约束生成的节点 |
| 实例选择 | 主要受节点组模板限制 | 可在较宽候选集合内求解 |
| 适合场景 | 容量形态稳定、治理边界明确 | 工作负载差异大、容量变化快 |
| 主要风险 | 节点组过多、模板碎片化 | 约束写得过窄导致无可用候选 |
这并不意味着动态方案天然更省钱。若 Pod 的 requests 明显高估、可用区被锁死、实例家族限制过窄,供给器只能在一个很差的候选集合中做选择,甚至完全无法供给。
验证供给结果而不是只看 Pod Running
Pod 变成 Running 只能证明“最终有地方可放”,不能证明创建出的节点符合预期。供给后应同时检查架构、可用区和实例类型:
kubectl get nodes -L kubernetes.io/arch,topology.kubernetes.io/zone,node.kubernetes.io/instance-type预期输出
NAME        STATUS   ROLES   AGE      VERSION   ARCH    ZONE      INSTANCE-TYPE
<ID>        Ready    <none>  <TIME>   <VALUE>   amd64   <ZONE>    <VALUE>
实际列值会因集群和云厂商不同而变化。只要新节点满足 Pod 与 NodePool 的交集约束,且没有为了单个工作负载引入不必要的过大实例,就说明动态供给的基本决策是合理的。
动态节点供给的核心不是“自动加机器”,而是把调度需求转换成基础设施选择。容量治理真正要优化的,也是这条链路中的输入约束:先让 requests 可信,再给架构、区域和实例范围保留足够弹性,供给器才有空间做出更好的节点选择。