
容器与云原生 / 系统课时
按内存指标配置 HPA
按内存指标配置 HPA
内存可以直接作为 HPA 的资源指标,但它与 CPU 不同:很多应用的内存不会随负载下降而快速归还。本篇配置一个按平均内存利用率伸缩的 HPA,并说明 requests、指标口径与不适用边界。
学习目标
- 使用
autoscaling/v2为工作负载配置内存资源指标。 - 解释
averageUtilization与 Pod 内存requests的关系。 - 判断缓存、泄漏等场景为什么不应只依赖内存 HPA。
内存利用率实际在算什么
当指标类型是 Resource、目标类型是 Utilization 时,HPA 会读取目标 Pod 的内存使用量,并与这些 Pod 对应容器声明的内存 requests 比较,再根据平均利用率计算期望副本数。因此,requests 不只是调度依据,也是百分比目标的分母。
例如一个 Pod 的内存 request 为 128Mi,当前内存指标约为 96Mi,则该 Pod 的利用率约为 75%。如果把目标设置为 70%,HPA 会倾向于扩容;如果请求值写得过小,同样的实际使用量会得到更高的百分比,导致更激进的扩容。
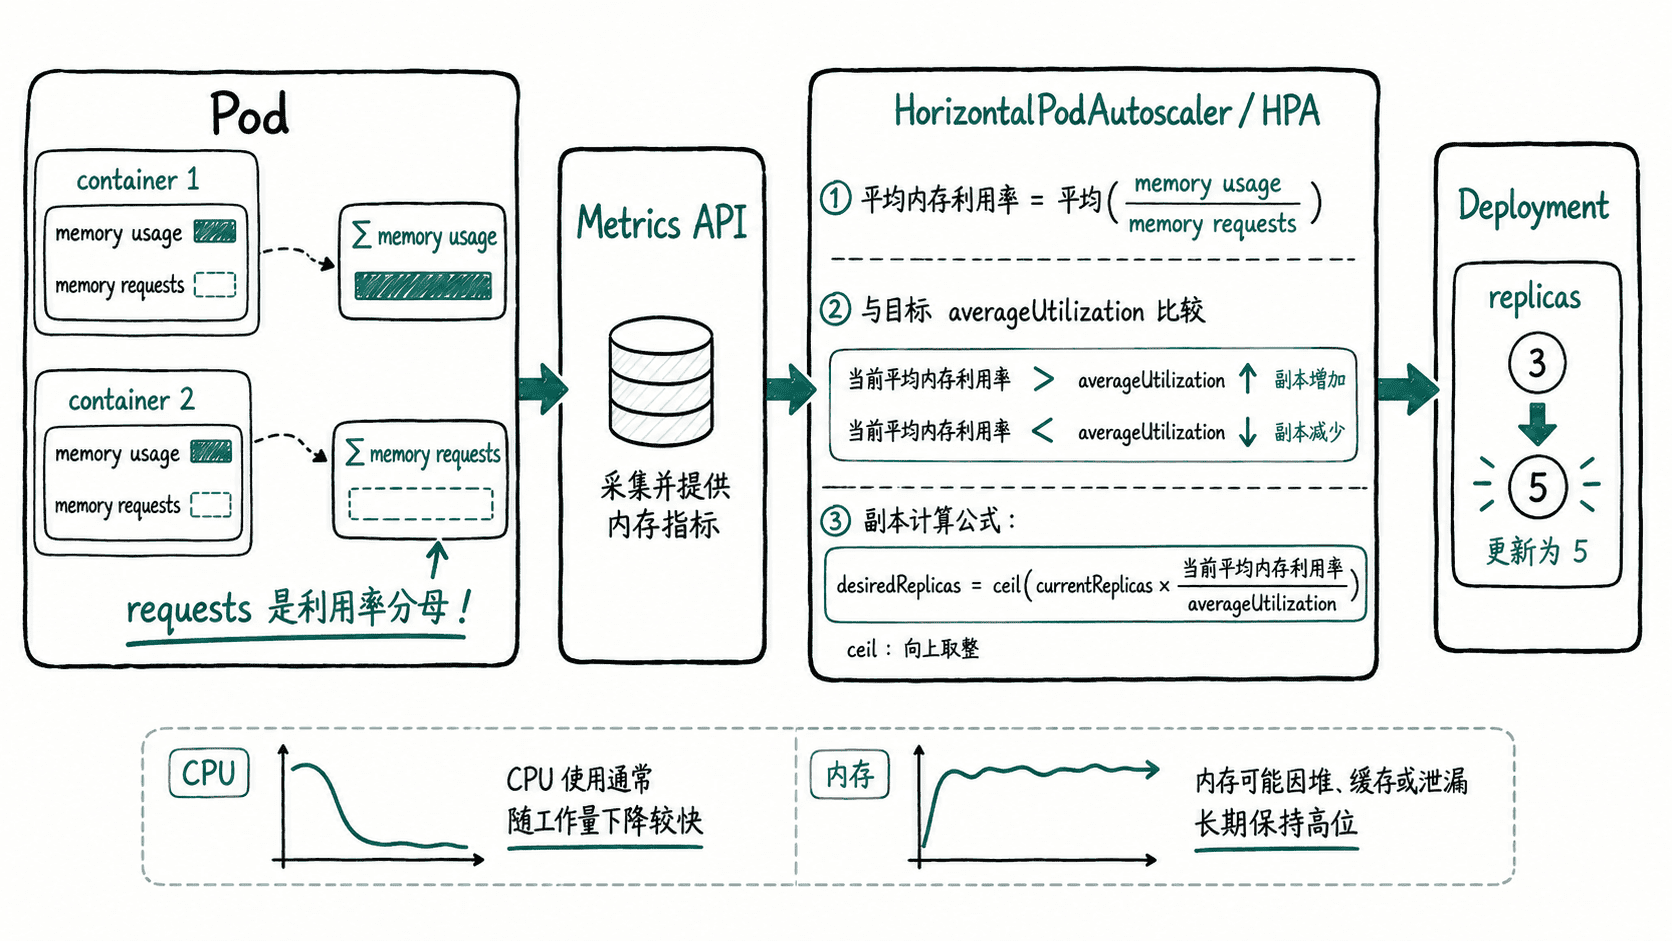
配置一个内存 HPA
下面的清单创建两个 Nginx Pod,并为每个容器声明 128Mi 内存 request。HPA 把平均内存利用率目标设为 70%,副本范围限制在 2~10。集群需要已经提供 metrics.k8s.io 资源指标。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: memory-web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: memory-web
  template:
    metadata:
      labels:
        app: memory-web
    spec:
      containers:
        - name: web
          image: nginx:1.27-alpine
          resources:
            requests:
              cpu: 50m
              memory: 128Mi
            limits:
              memory: 256Mi
---
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: memory-web
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: memory-web
  minReplicas: 2
  maxReplicas: 10
  metrics:
    - type: Resource
      resource:
        name: memory
        target:
          type: Utilization
          averageUtilization: 70
把清单保存为 memory-hpa.yaml 后执行:
kubectl apply -f memory-hpa.yaml
kubectl get hpa memory-web -o jsonpath='{.spec.metrics[0].resource.name}{" "}{.spec.metrics[0].resource.target.averageUtilization}{"\n"}'
首次创建时,预期输出类似:
deployment.apps/memory-web created
horizontalpodautoscaler.autoscaling/memory-web created
memory 70
这只能证明对象配置正确。还要确认资源指标能被读取,否则 HPA 的当前指标可能显示为 <unknown>。可以直接检查目标 Pod:
kubectl top pods -l app=memory-web预期输出类似,实际 Pod 名称和数值会不同:
NAME                          CPU(cores)   MEMORY(bytes)
memory-web-<ID>               <VALUE>m     <VALUE>Mi
memory-web-<ID>               <VALUE>m     <VALUE>Mi
CPU 与内存不能等价看待
CPU 是可压缩资源:需求下降后,CPU 使用通常会较快回落,扩容也常能把并行请求分摊到更多 Pod。内存则可能被堆、缓存、页缓存或对象池长期占用,即使请求量已经下降,进程也未必立即把内存归还给操作系统。
因此,内存高并不总等于“需要更多副本”。如果根因是内存泄漏,HPA 只会不断增加 Pod,直到 maxReplicas;如果应用依赖大缓存,新增副本甚至会复制缓存并增加总内存占用。此时应先修正泄漏或容量模型,而不是提高最大副本数。
判断是否该只用内存指标
内存 HPA 更适合“单 Pod 内存随并发或任务数近似增长,并且扩容后负载能够被均匀分摊”的工作负载。对 JVM 大堆、强缓存服务、进程内状态明显或内存泄漏场景,单独使用内存指标通常不够可靠。
更稳妥的做法是把内存作为容量保护信号,同时用请求率、并发数、队列长度等更接近业务压力的指标驱动伸缩,并为内存异常设置告警。这样可以避免把“内存没有回收”误判成“业务持续增长”。