
容器与云原生 / 系统课时
协调 HPA 与 VPA
协调 HPA 与 VPA
HPA 和 VPA 都能提升资源利用率,但如果两者同时围绕同一项 CPU 或内存利用率调节,就会互相改变对方看到的信号。本课把冲突拆成可观察的反馈链,并给出分离指标、固定资源维度和分阶段校准三种可落地组合。
学习目标
- 解释 HPA 与 VPA 共用资源利用率指标时为什么会形成反馈冲突
- 根据工作负载特点选择分离指标、固定维度或分阶段校准方案
- 用配置约束 VPA 只调整内存,让 HPA 的 CPU 利用率分母保持稳定
冲突来自同一个分母
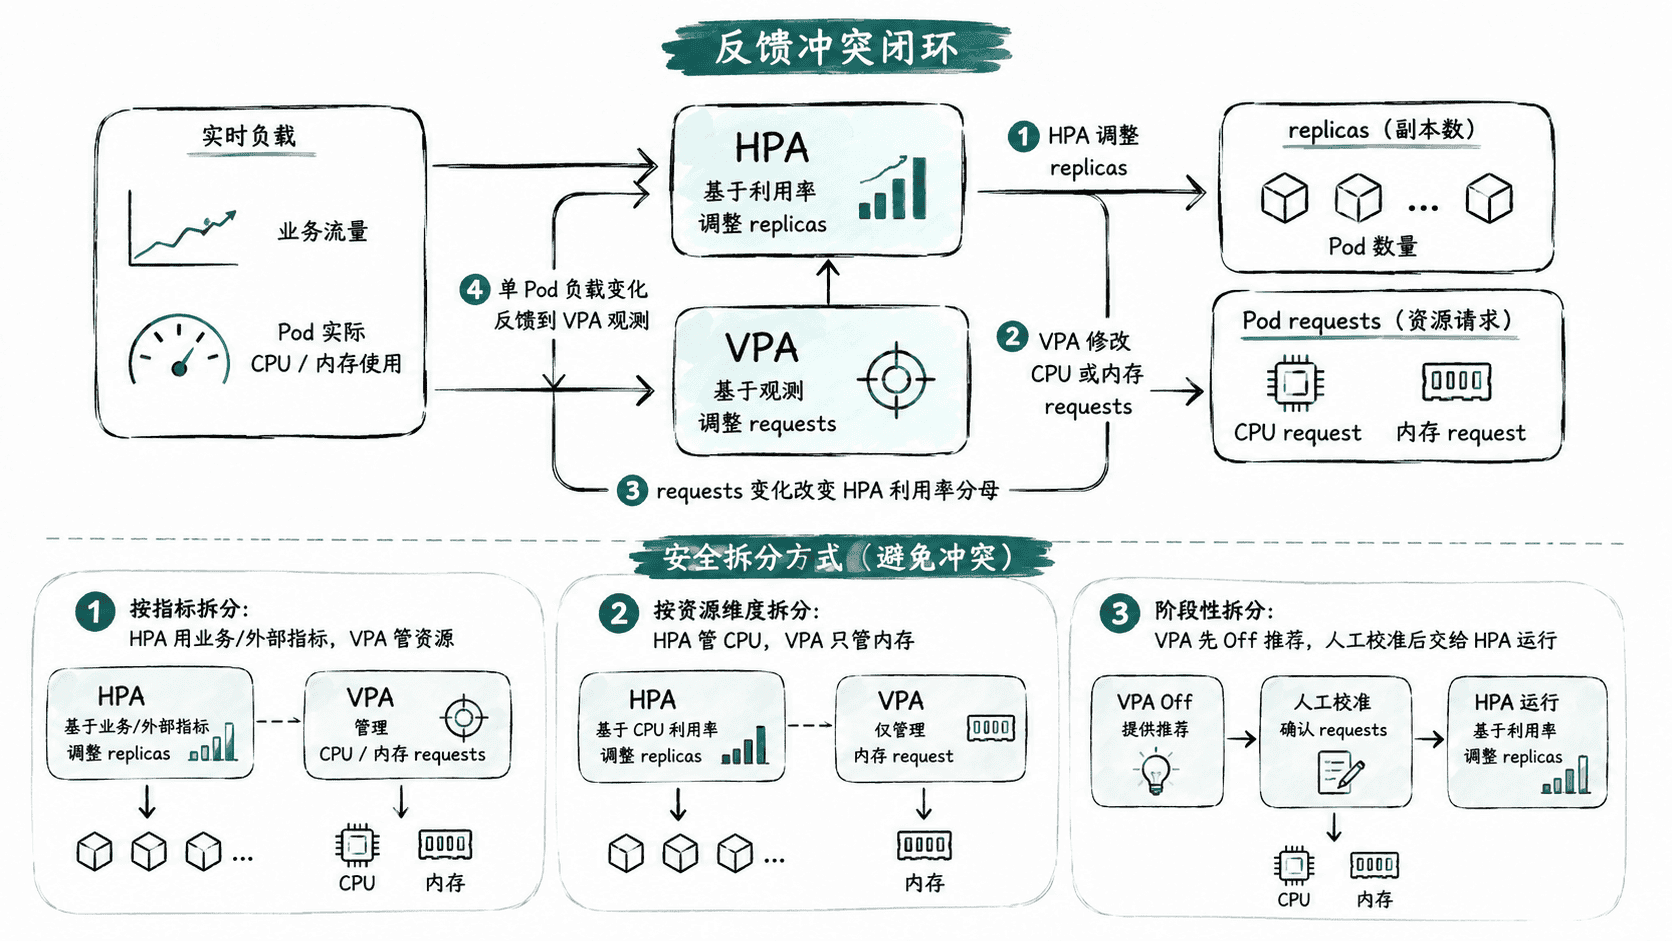
HPA 使用 CPU 或内存“利用率”时,核心不是直接比较绝对使用量,而是比较当前使用量与 Pod requests 的比例。以 CPU 为例,某个容器实际使用 300m、requests.cpu 为 300m 时,利用率约为 100%;如果 VPA 把请求值提高到 600m,而负载没有变化,HPA 看到的利用率会立即降到约 50%。
这意味着 VPA 改请求值会改变 HPA 的输入;HPA 改副本数又会改变单 Pod 分摊的负载,进而影响 VPA 的历史观测和推荐。若两者都自动围绕同一资源维度调整,系统可能出现“请求值上调—HPA 缩容—单 Pod 压力增大—再次推荐”的耦合,而不是两个独立控制器各自收敛。
选择不会互相改写的控制变量
最稳妥的组合是让两个控制器不要竞争同一个变量。常见做法有三类:
| 组合方式 | HPA 负责 | VPA 负责 | 适用情况 |
|---|---|---|---|
| 分离指标 | QPS、队列长度、延迟等业务或外部指标 | CPU、内存 requests |
业务负载信号稳定、可观测性较完善 |
| 固定维度 | CPU 利用率 | 仅内存请求,或反过来 | CPU 与内存压力来源相对独立 |
| 分阶段校准 | 线上副本数 | Off 模式只给推荐,定期人工更新请求值 |
变更审慎、希望避免两个自动控制环同时生效 |
如果 HPA 已经使用 CPU 利用率,最需要避免的是让 VPA 同时自动修改 requests.cpu;HPA 使用内存利用率时同理。若必须让 VPA 同时控制 CPU 和内存,更合适的 HPA 输入通常是不会因 requests 改变而瞬间跳变的业务指标。
用固定维度组合 HPA 与 VPA
下面的主示例让 HPA 只按 CPU 利用率调整副本,而 VPA 只允许修改内存请求。这样 requests.cpu 固定为 200m,HPA 的 CPU 利用率分母不会被 VPA 改写。示例要求集群已提供 Resource Metrics API,并已安装 VPA CRD 与控制器。
apiVersion: v1
kind: List
items:
  - apiVersion: v1
    kind: Namespace
    metadata:
      name: autoscale-demo
  - apiVersion: apps/v1
    kind: Deployment
    metadata:
      name: web
      namespace: autoscale-demo
    spec:
      replicas: 2
      selector:
        matchLabels:
          app: web
      template:
        metadata:
          labels:
            app: web
        spec:
          containers:
            - name: web
              image: registry.k8s.io/pause:3.10
              resources:
                requests:
                  cpu: 200m
                  memory: 128Mi
                limits:
                  cpu: "1"
                  memory: 512Mi
  - apiVersion: autoscaling/v2
    kind: HorizontalPodAutoscaler
    metadata:
      name: web
      namespace: autoscale-demo
    spec:
      scaleTargetRef:
        apiVersion: apps/v1
        kind: Deployment
        name: web
      minReplicas: 2
      maxReplicas: 10
      metrics:
        - type: Resource
          resource:
            name: cpu
            target:
              type: Utilization
              averageUtilization: 60
  - apiVersion: autoscaling.k8s.io/v1
    kind: VerticalPodAutoscaler
    metadata:
      name: web
      namespace: autoscale-demo
    spec:
      targetRef:
        apiVersion: apps/v1
        kind: Deployment
        name: web
      updatePolicy:
        updateMode: Auto
      resourcePolicy:
        containerPolicies:
          - containerName: web
            controlledResources:
              - memory
            controlledValues: RequestsOnly
            minAllowed:
              memory: 64Mi
            maxAllowed:
              memory: 512Mi
配置生效后,VPA 可以更新 requests.memory,但不会修改 CPU 请求。RequestsOnly 还会避免 VPA 联动改写示例中的内存 limit;生产环境仍要结合应用的 OOM 行为和节点内存余量设置上下界。
应用配置:
kubectl apply -f hpa-vpa.yaml预期输出:
namespace/autoscale-demo created
deployment.apps/web created
horizontalpodautoscaler.autoscaling/web created
verticalpodautoscaler.autoscaling.k8s.io/web created若对象已经存在,kubectl apply 可能显示 configured 或 unchanged,这不影响后续验证。
验证两个控制器没有争用 CPU 请求
不要只看对象是否创建成功,还要检查 HPA 的指标维度和 VPA 的受控资源。下面的命令直接读取规格,避免把动态利用率误当成配置验证。
kubectl get hpa web -n autoscale-demo -o jsonpath='{.spec.metrics[0].resource.name}{"\n"}{.spec.metrics[0].resource.target.averageUtilization}{"\n"}'
kubectl get vpa web -n autoscale-demo -o jsonpath='{.spec.resourcePolicy.containerPolicies[0].controlledResources}{"\n"}'
预期输出:
cpu
60
["memory"]
这组结果说明 HPA 的 CPU 目标是 60%,而 VPA 只控制内存。实际运行时还应观察 HPA 的副本变化、VPA 推荐值和 Pod 重建情况;updateMode: Auto 可能为了应用新的请求值而触发 Pod 更新,因此要同时配置合理的副本数、滚动发布策略和可用性预算。
什么时候改用分阶段校准
如果工作负载对重启敏感,或者 CPU 与内存都希望由 VPA 给出建议,可先把 VPA 设为 Off,连续观察一个有代表性的业务周期,再把推荐值人工写回 Deployment。完成基线校准后,让 HPA 独立负责在线副本伸缩,避免两个自动控制环在同一时间修改彼此的输入。
对延迟敏感或负载波动很快的服务,优先让 HPA 依据 QPS、队列长度或延迟等业务信号扩缩容,VPA 则负责较慢速的资源基线校准。核心原则只有一个:不要让两个自动控制器同时改写同一个反馈环里的输入和输出。