
容器与云原生 / 系统课时
配置 Cluster Autoscaler
配置 Cluster Autoscaler
Cluster Autoscaler(CA)解决的是“Pod 已经需要更多副本,但现有节点放不下”的容量问题。本课把节点组边界、扩容触发和缩容条件串成一条可验证链路,最终能够用不可调度 Pod 触发新节点加入集群。
学习目标
- 配置并解释 CA 的节点组最小值、最大值与关键缩容参数
- 验证
FailedScheduling如何触发节点扩容并让 Pending Pod 被重新调度 - 判断节点为什么不能缩容,以及 HPA 与 CA 的职责边界
先把节点组边界配置对
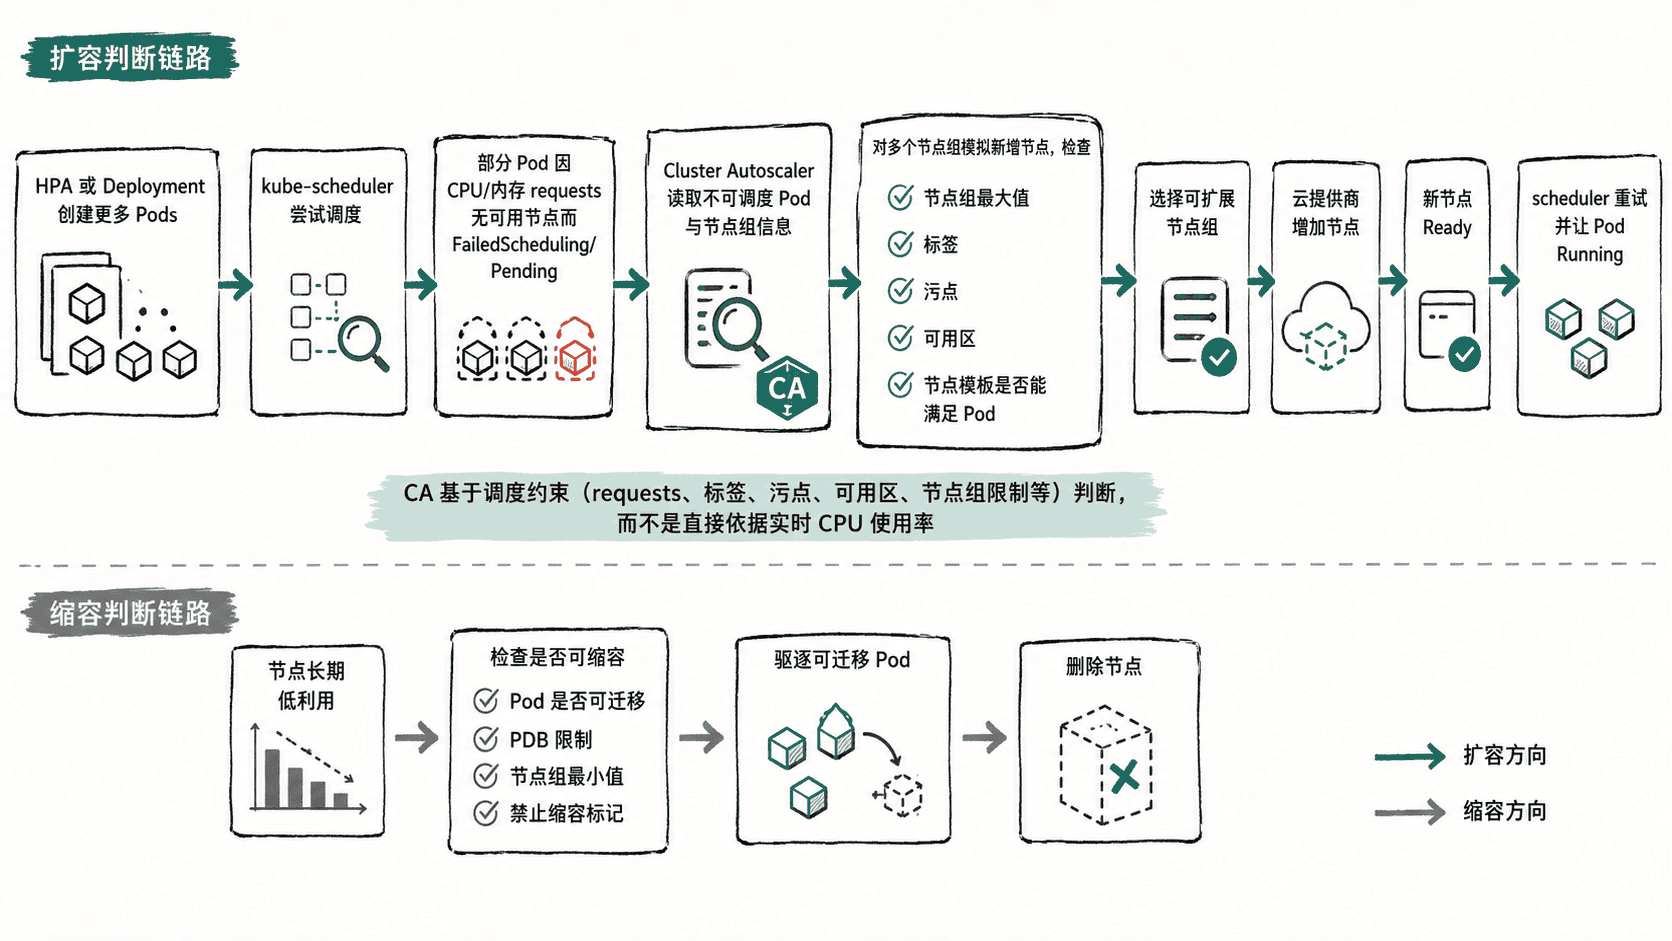
CA 不直接根据节点 CPU 曲线“补机器”,而是观察 Kubernetes 调度结果:当 Pod 因现有节点容量不足而不可调度时,它会模拟“给某个可扩展节点组再增加节点是否有帮助”。因此,云平台或基础设施层必须先提供可扩展节点组,并设置最小、最大节点数、节点模板和 CA 所需权限。
先确认控制器已经运行。下面假设 Deployment 名为 cluster-autoscaler;若安装时改过名称,请替换为实际值。
kubectl -n kube-system get deployment cluster-autoscaler预期输出:
NAME                 READY   UP-TO-DATE   AVAILABLE   AGE
cluster-autoscaler   1/1     1            1           <TIME>
节点组的最小值是缩容下限,最大值是扩容上限。即使仍有 Pending Pod,节点组达到最大值后也不会继续增长;反过来,即使节点空闲,CA 也不会把节点组缩到最小值以下。自动发现节点组的标签、API 和身份配置因云提供商而异,应按所用提供商适配。
CA Deployment 常见的核心参数可以按下面的片段配置。这里显式写出缩容阈值与等待时间,便于实验观察;生产值应结合节点启动耗时、业务抖动和成本目标确定。
args:
  - --cloud-provider=<PROVIDER>
  - --expander=least-waste
  - --scale-down-enabled=true
  - --scale-down-utilization-threshold=0.5
  - --scale-down-unneeded-time=10m
这段配置的生效行为是:CA 在可扩展节点组中选择能够容纳不可调度 Pod 的候选,并倾向减少扩容后的资源浪费;缩容时,节点还必须持续满足“低利用且工作负载可迁移”等条件,而不是一低于 50% 就立刻删除。
用不可调度 Pod 触发扩容
在隔离实验集群创建一个高副本工作负载,每个 Pod 请求 500m CPU 和 256Mi 内存。下面的 20 个副本适合小型实验集群;如果现有容量仍足够,可以继续增加副本,但单个 Pod 的 requests 必须能放进节点组中的某一种节点。
cat <<'EOF' | kubectl apply -f -
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ca-load
spec:
  replicas: 20
  selector:
    matchLabels:
      app: ca-load
  template:
    metadata:
      labels:
        app: ca-load
    spec:
      containers:
        - name: pause
          image: registry.k8s.io/pause:3.10
          resources:
            requests:
              cpu: 500m
              memory: 256Mi
EOF
预期输出:
deployment.apps/ca-load created随后检查 Pod。容量不足时,部分副本会先进入 Pending;调度事件中通常能看到 FailedScheduling 及资源不足原因。
kubectl get pods -l app=ca-load
kubectl get events --field-selector reason=FailedScheduling --sort-by=.lastTimestamp
预期输出示例:
NAME                      READY   STATUS    RESTARTS   AGE
ca-load-<ID>              1/1     Running   0          <TIME>
ca-load-<ID>              0/1     Pending   0          <TIME>

<TIME>   Warning   FailedScheduling   pod/ca-load-<ID>   0/<VALUE> nodes are available: <VALUE> Insufficient cpu
实际节点数、事件文本和资源名称会因集群状态而不同。此时观察节点列表,新节点完成创建并注册为 Ready 后,scheduler 会重新尝试这些 Pending Pod。
kubectl get nodes -w预期结果:
NAME        STATUS   ROLES    AGE      VERSION
node-<ID>   Ready    <none>   <TIME>   <VALUE>
继续执行 kubectl get pods -l app=ca-load,最终应看到原先因资源不足 Pending 的副本转为 Running。如果节点组已经达到最大值,或 Pod 的亲和性、污点容忍、存储拓扑等约束没有任何节点模板能够满足,增加节点也无法解决问题。
缩容要同时满足“空得下来”和“搬得走”
缩容判断通常使用 Pod requests 相对节点 Allocatable 的利用情况,并进一步模拟节点上的 Pod 能否迁移到其他节点。PodDisruptionBudget、节点组最小值、禁止缩容标记、无法安全驱逐的 Pod,都会让一个看似空闲的节点继续保留。
把实验工作负载缩到 0,可以制造一段可回收容量。
kubectl scale deployment ca-load --replicas=0预期输出:
deployment.apps/ca-load scaled在前面的配置下,节点需要持续约 10m 满足“不再需要”的条件后才有资格被回收;实际删除时间还受云平台操作、其他工作负载和 CA 保护条件影响。可以用 kubectl get nodes -w 观察节点数是否回落,但不要把“节点空闲”误判成“节点一定会被删除”。
把 HPA 和 CA 看成两段控制链
HPA 调整的是工作负载副本数,CA 调整的是承载这些 Pod 的节点容量。负载升高时,典型链路是“指标升高 → HPA 增加 Pod → scheduler 发现部分 Pod 放不下 → CA 增加节点 → Pending Pod 被调度”;负载下降时则先减少 Pod,再由 CA 判断多余节点是否可以安全回收。
排查“为什么没扩节点”时,应先确认 Pod 是否真的处于不可调度状态,再检查节点组是否到达上限、节点模板是否满足 Pod 约束以及云平台是否还有可用配额。只有这条证据链成立,调整 CA 参数才有意义。