
容器与云原生 / 系统课时
按时间窗口预热容量
按时间窗口预热容量
被动指标要等流量出现后才扩容,遇到固定早高峰、开售或批处理窗口时,启动与拉镜像延迟可能直接变成排队。本课用 KEDA Cron 提前抬高容量下限,同时保留 CPU 指标继续按真实负载扩容。
学习目标
- 用 Cron 时间窗口在高峰前建立预热副本
- 让定时容量与 CPU 等被动指标共同决定最终副本数
- 设计窗口结束后的平滑回落与验证方法
预热应该是容量下限而不是固定副本
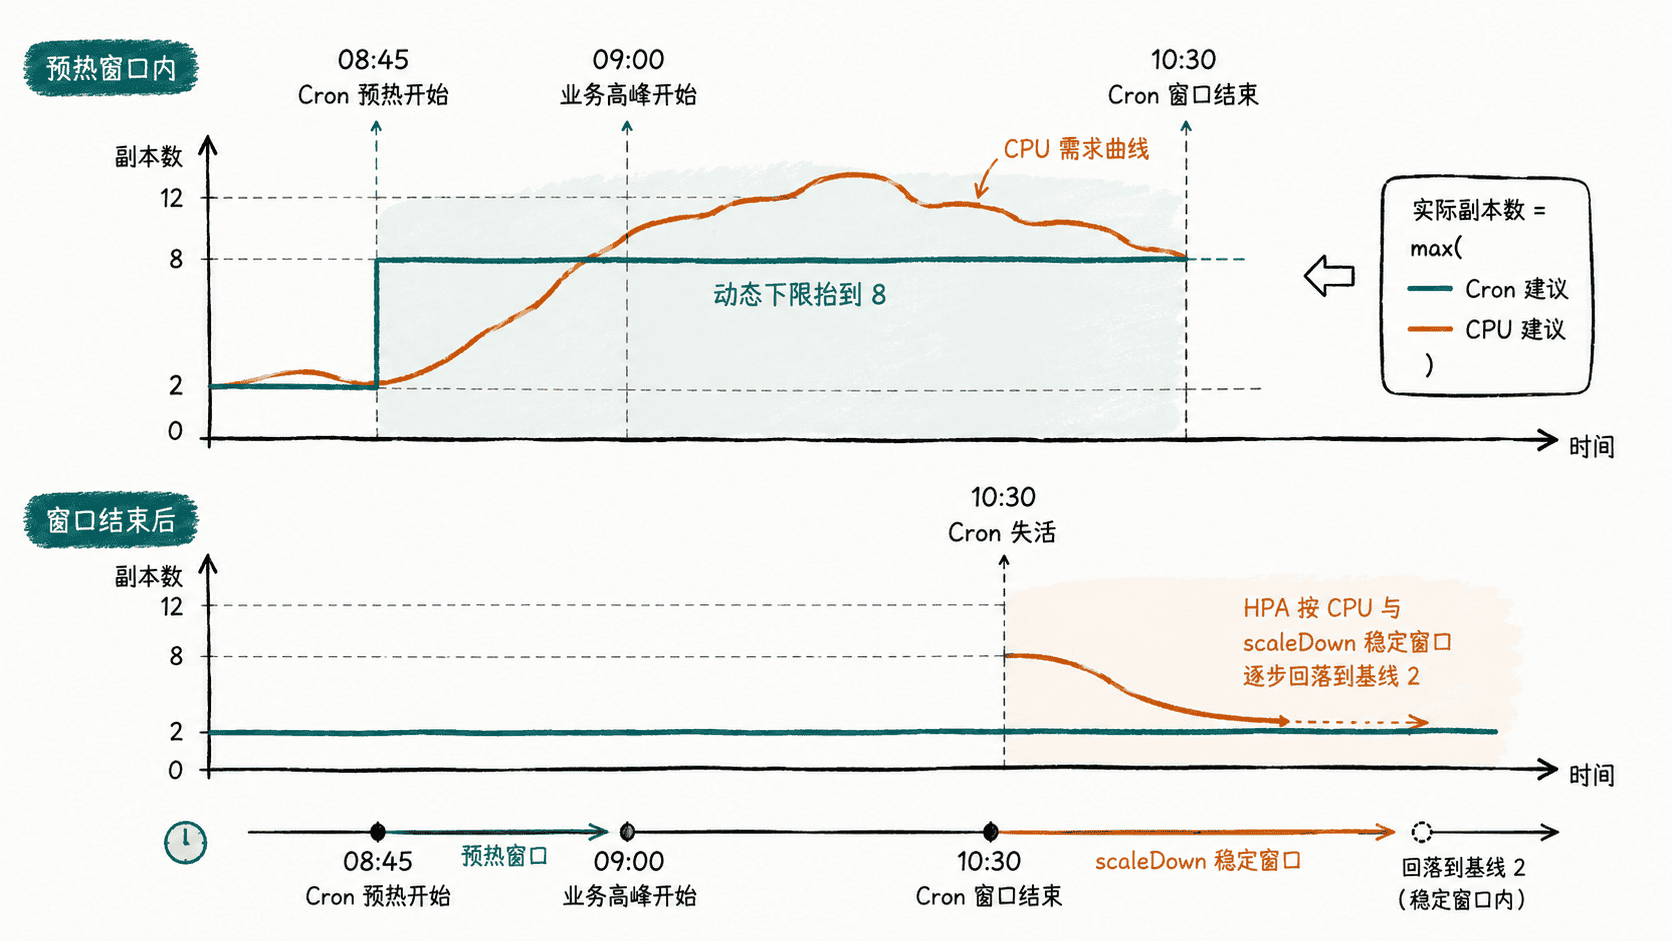
定时伸缩最稳妥的用法不是“高峰时强制等于 8 个副本”,而是“高峰时至少准备 8 个副本”。如果实际 CPU 压力需要 12 个副本,被动指标仍应继续把容量推高;如果窗口内负载很低,Cron 则负责避免副本低于预热线。
KEDA 的 Cron scaler 正好适合这个模型:在 start 到 end 之间,它给底层 HPA 提供一个副本建议,与其他触发器的建议一起参与最大值选择。窗口结束后 Cron 不再提供这条下限,容量重新由基础最小副本和实时指标决定。
用 KEDA 定义预热窗口
下面假设集群已安装 KEDA 与 Metrics Server,shop 命名空间存在 Deployment/checkout,并且 Pod 已设置 CPU requests。示例把工作日 09:00 的高峰提前 15 分钟预热,08:45 到 10:30 至少保持 8 个副本,平时基线为 2,最大允许 20。
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: checkout-capacity
  namespace: shop
spec:
  scaleTargetRef:
    name: checkout
  pollingInterval: 30
  minReplicaCount: 2
  maxReplicaCount: 20
  advanced:
    horizontalPodAutoscalerConfig:
      behavior:
        scaleDown:
          stabilizationWindowSeconds: 300
          policies:
            - type: Percent
              value: 50
              periodSeconds: 60
  triggers:
    - type: cron
      metadata:
        timezone: Asia/Shanghai
        start: "45 8 * * 1-5"
        end: "30 10 * * 1-5"
        desiredReplicas: "8"
    - type: cpu
      metricType: Utilization
      metadata:
        value: "65"
timezone 应使用业务所在地对应的 IANA 时区,避免把控制节点时区误当成业务时区。start 与 end 使用五段 Linux Cron 表达式;desiredReplicas: "8" 表示窗口内的预热目标,而不是限制 CPU 只能扩到 8。
保存为 checkout-scaledobject.yaml 后应用,并读取触发器确认配置已经进入集群:
kubectl apply -f checkout-scaledobject.yaml
kubectl get scaledobject checkout-capacity -n shop -o jsonpath='{.spec.triggers[0].type}{" "}{.spec.triggers[0].metadata.desiredReplicas}{" "}{.spec.triggers[1].type}{"\n"}'
预期输出
scaledobject.keda.sh/checkout-capacity <VALUE>
cron 8 cpu
<VALUE> 可能是 created、configured 或 unchanged。第二行应表明第一个触发器是 Cron、预热副本为 8,第二个触发器是 CPU。
让窗口结束后平滑回落
当时间到达 end 后,不要再创建一条“把副本设回 2”的 Cron 任务。Cron 触发器失活后,基础 minReplicaCount: 2 自然重新成为下限;若 CPU 仍高,副本可以继续保持在 8 以上,直到实时负载允许缩容。
示例中的 scaleDown.stabilizationWindowSeconds: 300 会让 HPA 在缩容时参考最近的较高建议,配合每分钟最多缩减 50% 的策略,避免 10:30 一到就快速回收大量 Pod。对于基线大于 0 的 1 到 N 缩放,主要应通过 HPA behavior 控制回落速度,而不是误以为 KEDA 的 cooldownPeriod 会承担同样作用。
用四个时刻验收策略
验收时不只检查对象是否创建成功,还要按时间与负载组合观察实际副本。高峰前,副本应从基线 2 向 8 预热;进入窗口后即使 CPU 很低,也不应低于 8;若 CPU 需要 12,容量应继续超过预热线;窗口结束且 CPU 回落后,副本应按照缩容稳定策略逐步回到 2。
预热时间应覆盖 Pod 调度、镜像拉取、应用启动、就绪探针和连接池升温的总耗时,并留出安全余量。窗口太晚,预热失去意义;窗口太早,则只是把空闲成本提前。最终应以真实启动耗时和峰值到达时间校准 Cron,而不是只凭整点习惯设置。