
容器与云原生 / 系统课时
排查 HPA 不扩容
排查 HPA 不扩容
当业务负载已经升高而副本数没有增加时,最有效的办法不是直接修改阈值,而是沿着“目标对象—指标—计算—限制—Pod 落地”逐层确认。这样可以区分 HPA 根本没有算出扩容、扩容被边界限制,还是副本已经被请求但 Pod 没有成功运行。
学习目标
- 用 HPA 状态、conditions 和指标值判断控制器是否正在正常计算副本数
- 定位指标缺失、
requests缺失、maxReplicas或behavior限制等常见原因 - 区分“desired replicas 没增加”和“desired 已增加但 Pod 没跑起来”两类故障
先确认故障发生在哪一段
HPA 的排查顺序应保持稳定:先看它是否能读取目标工作负载和指标,再看计算结果是否被最小/最大副本或伸缩策略限制,最后才检查 Deployment、调度和节点容量。跨层跳查很容易把“指标问题”误判成“集群没资源”。
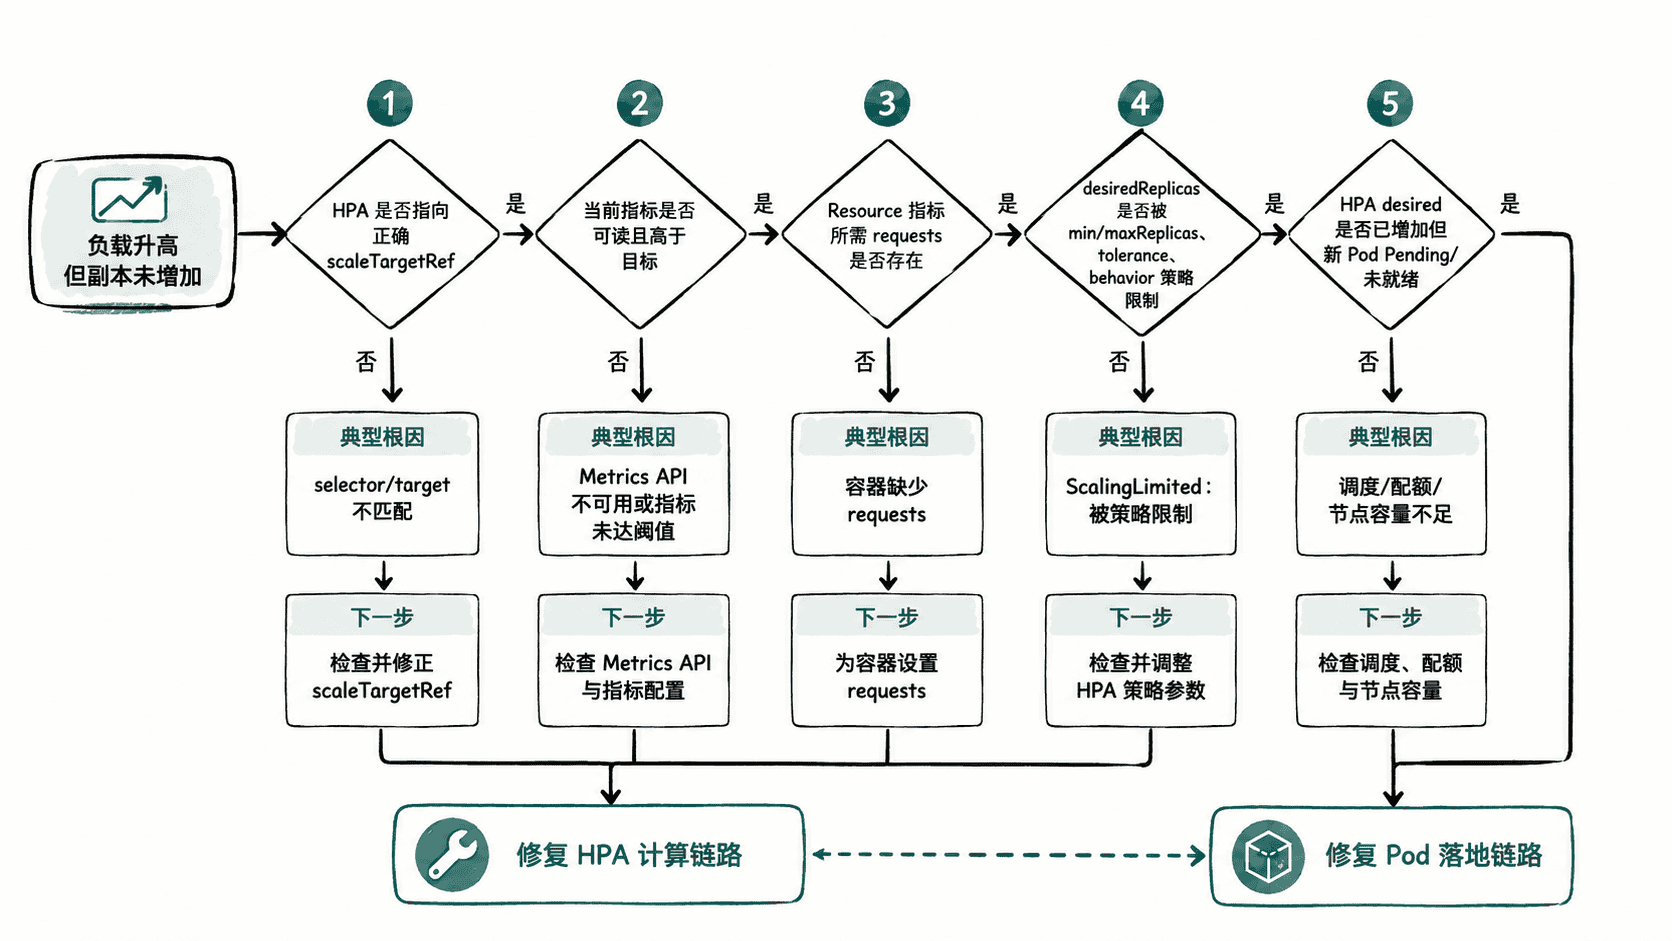
先执行一组不改配置的读取命令,收集 HPA、conditions、指标 API、目标 Deployment 和 Pod 状态。
NS=prod
HPA=checkout
APP=checkout

kubectl get hpa "$HPA" -n "$NS"
kubectl get hpa "$HPA" -n "$NS"   -o jsonpath='{range .status.conditions[*]}{.type}{" "}{.status}{" "}{.reason}{"\n"}{end}'
kubectl top pod -n "$NS" -l app="$APP"
kubectl get deploy "$APP" -n "$NS"   -o jsonpath='desired={.spec.replicas} ready={.status.readyReplicas} available={.status.availableReplicas}{"\n"}'
kubectl get pods -n "$NS" -l app="$APP" -o wide
预期输出
NAME       REFERENCE             TARGETS        MINPODS   MAXPODS   REPLICAS   AGE
checkout   Deployment/checkout   <VALUE>/<VALUE>  2         20        <VALUE>    <TIME>
AbleToScale    <VALUE>    <VALUE>
ScalingActive  <VALUE>    <VALUE>
ScalingLimited <VALUE>    <VALUE>
NAME                    CPU(cores)   MEMORY(bytes)
checkout-<ID>            <VALUE>      <VALUE>
desired=<VALUE> ready=<VALUE> available=<VALUE>
NAME                    READY   STATUS    RESTARTS   AGE      IP        NODE
checkout-<ID> <VALUE> <VALUE> <VALUE> <TIME> <IP> <VALUE><VALUE>、<ID>、<TIME>、<IP> 会随现场变化。若 kubectl top 本身报错,应优先修复 Resource Metrics 链路,而不是继续调 HPA 阈值。
读取 conditions 判断 HPA 有没有算出副本数
AbleToScale 关注 HPA 能否读取并更新目标对象的 scale 子资源;ScalingActive 反映是否存在可用指标并能据此计算副本数;ScalingLimited 则提示期望值是否受上下界等限制。conditions 的 reason 和事件通常比单看 TARGETS 更接近根因。
对于 Resource 指标,HPA 的核心关系可以写成:
当当前值与目标值非常接近时,控制器会在容差范围内避免无意义抖动;因此“略高于目标”不一定立刻扩容。若指标明显高于目标而 desiredReplicas 仍不增加,再检查缺失指标、未就绪 Pod 和伸缩策略。
检查指标与 requests
CPU 或内存 Resource 利用率不是“节点整体百分比”,而是按 Pod 资源使用量相对容器 requests 计算。目标容器缺少对应 requests 时,利用率无法正常计算,HPA 可能得到无效指标或采取保守处理。
可以直接查看 Deployment 模板中的资源申请:
kubectl get deploy checkout -n prod -o jsonpath='{range .spec.template.spec.containers[*]}{.name}{" cpu="}{.resources.requests.cpu}{" memory="}{.resources.requests.memory}{"\n"}{end}'预期输出
checkout cpu=<VALUE> memory=<VALUE>如果使用 CPU 利用率指标却看到 cpu= 为空,应先为相关容器设置合理的 CPU request,再等待新的指标样本。不要为了让 HPA “看见高利用率”而故意把 request 压得极低,这会同时改变调度预留和 HPA 分母。
检查副本边界与 behavior
当当前副本已经达到 maxReplicas,HPA 即使计算出更高的期望值也不会继续增加。自定义 behavior.scaleUp 还可能通过策略或稳定窗口限制扩容速度;排障时应把“计算结果”和“允许执行的最大变更”分开看。
如果 conditions 显示 ScalingLimited=True,应对照 minReplicas、maxReplicas 和 behavior。修复时只调整确实阻塞的约束,并保留能保护下游系统的限速策略,避免一次解除所有保护。
区分 HPA 不扩容与 Pod 不落地
如果 Deployment 的 spec.replicas 已经变大,说明 HPA 到 scale 子资源的链路基本正常。此时 readyReplicas 没有同步增长,应转向 Deployment、ReplicaSet 和调度层检查,例如 ResourceQuota、节点资源不足、亲和性、污点容忍、镜像拉取或启动探针失败。
反过来,如果指标健康、负载明显高于目标,但 Deployment 的期望副本始终不变,就继续聚焦 HPA conditions、指标选择器、requests、上下界和 behavior,不要先扩节点。
修复后重新执行同一组只读命令,确认 ScalingActive=True、指标值可读、Deployment 期望副本随负载变化,并且新增 Pod 最终进入 Ready。只有“控制器算得出、目标对象接得住、Pod 真正运行起来”三件事同时成立,才算完成 HPA 不扩容故障的闭环验证。