
容器与云原生 / 系统课时
用 ResourceQuota 控制容量预算
用 ResourceQuota 控制容量预算
ResourceQuota 把命名空间的资源声明转换成可执行的容量预算。本课会配置 CPU、内存与 Pod 数量上限,并复现“扩容目标已经提高,但新 Pod 因配额不足被拒绝”的完整失败路径。
学习目标
- 配置并读取命名空间级 CPU、内存和对象数量配额
- 解释 HPA、工作负载控制器与 ResourceQuota 的职责边界
- 根据单 Pod requests 推算可支持的最大副本数并预留变更余量
配额限制的是声明预算
ResourceQuota 在命名空间范围内统计资源对象,并在准入阶段阻止会让 used 超过 hard 的创建或更新。对于容量治理,最常用的是 requests.cpu、requests.memory、limits.cpu、limits.memory 与 pods。
CPU 和内存配额统计的是 Pod 资源声明,不是节点上的实时使用量。例如单 Pod 的 requests.cpu 为 300m,命名空间的 requests.cpu 上限为 1200m,在没有其他工作负载占用该配额时,最多只能同时接纳 4 个这样的 Pod。
配置可复现的容量预算
下面的配置创建独立命名空间、配额和一个每副本请求 300m CPU 的 Deployment。CPU 配额会先于 Pod 数量配额成为扩容瓶颈。
apiVersion: v1
kind: Namespace
metadata:
  name: autoscale-budget
---
apiVersion: v1
kind: ResourceQuota
metadata:
  name: autoscale-budget-quota
  namespace: autoscale-budget
spec:
  hard:
    requests.cpu: "1200m"
    requests.memory: "768Mi"
    limits.cpu: "4"
    limits.memory: "2Gi"
    pods: "6"
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  namespace: autoscale-budget
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: web
          image: nginx:1.27
          resources:
            requests:
              cpu: "300m"
              memory: "128Mi"
            limits:
              cpu: "500m"
              memory: "256Mi"
实验集群还需要有足够的可调度资源运行 4 个请求 300m CPU 的 Pod。将内容保存为 quota-demo.yaml 后应用。
kubectl apply -f quota-demo.yaml预期输出
namespace/autoscale-budget created
resourcequota/autoscale-budget-quota created
deployment.apps/web created
等待初始 Deployment 达到可用状态。
kubectl -n autoscale-budget wait --for=condition=Available deployment/web --timeout=120s预期输出
deployment.apps/web condition met读取当前 CPU requests 配额占用。
kubectl -n autoscale-budget get resourcequota autoscale-budget-quota -o jsonpath='{.status.used.requests\.cpu}{" / "}{.status.hard.requests\.cpu}{"\n"}'预期输出
600m / 1200mstatus.used 由控制面更新,刚创建资源时可能短暂滞后;稍后重试即可看到稳定值。
看懂 HPA 扩容失败路径
当 HPA 计算出更高的 desiredReplicas 时,它只是通过工作负载的 scale 子资源提高目标副本数。随后 Deployment/ReplicaSet 控制器创建 Pod,每个新 Pod 都必须重新经过 ResourceQuota 准入检查。
为了只复现这段下游失败路径,可以直接把副本数改为 5;这与 HPA 把 Deployment 目标副本提高到 5 之后的 Pod 创建过程相同。
kubectl -n autoscale-budget scale deployment web --replicas=5预期输出
deployment.apps/web scaled等待控制器完成创建与重试后查看目标数和可用数。
kubectl -n autoscale-budget get deployment web -o jsonpath='{.spec.replicas}{" desired / "}{.status.availableReplicas}{" available\n"}'预期输出
5 desired / 4 available前 4 个 Pod 合计请求 1200m CPU;第 5 个 Pod 再请求 300m 时会被拒绝。查看 FailedCreate 事件可以确认失败发生在准入阶段,而不是调度阶段。
kubectl -n autoscale-budget get events --field-selector reason=FailedCreate -o jsonpath='{range .items[*]}{.message}{"\n"}{end}'预期输出类似
pods "web-<ID>" is forbidden: exceeded quota: autoscale-budget-quota, requested: requests.cpu=300m, used: requests.cpu=1200m, limited: requests.cpu=1200m<ID> 是 ReplicaSet/Pod 的动态标识,实际值会不同。
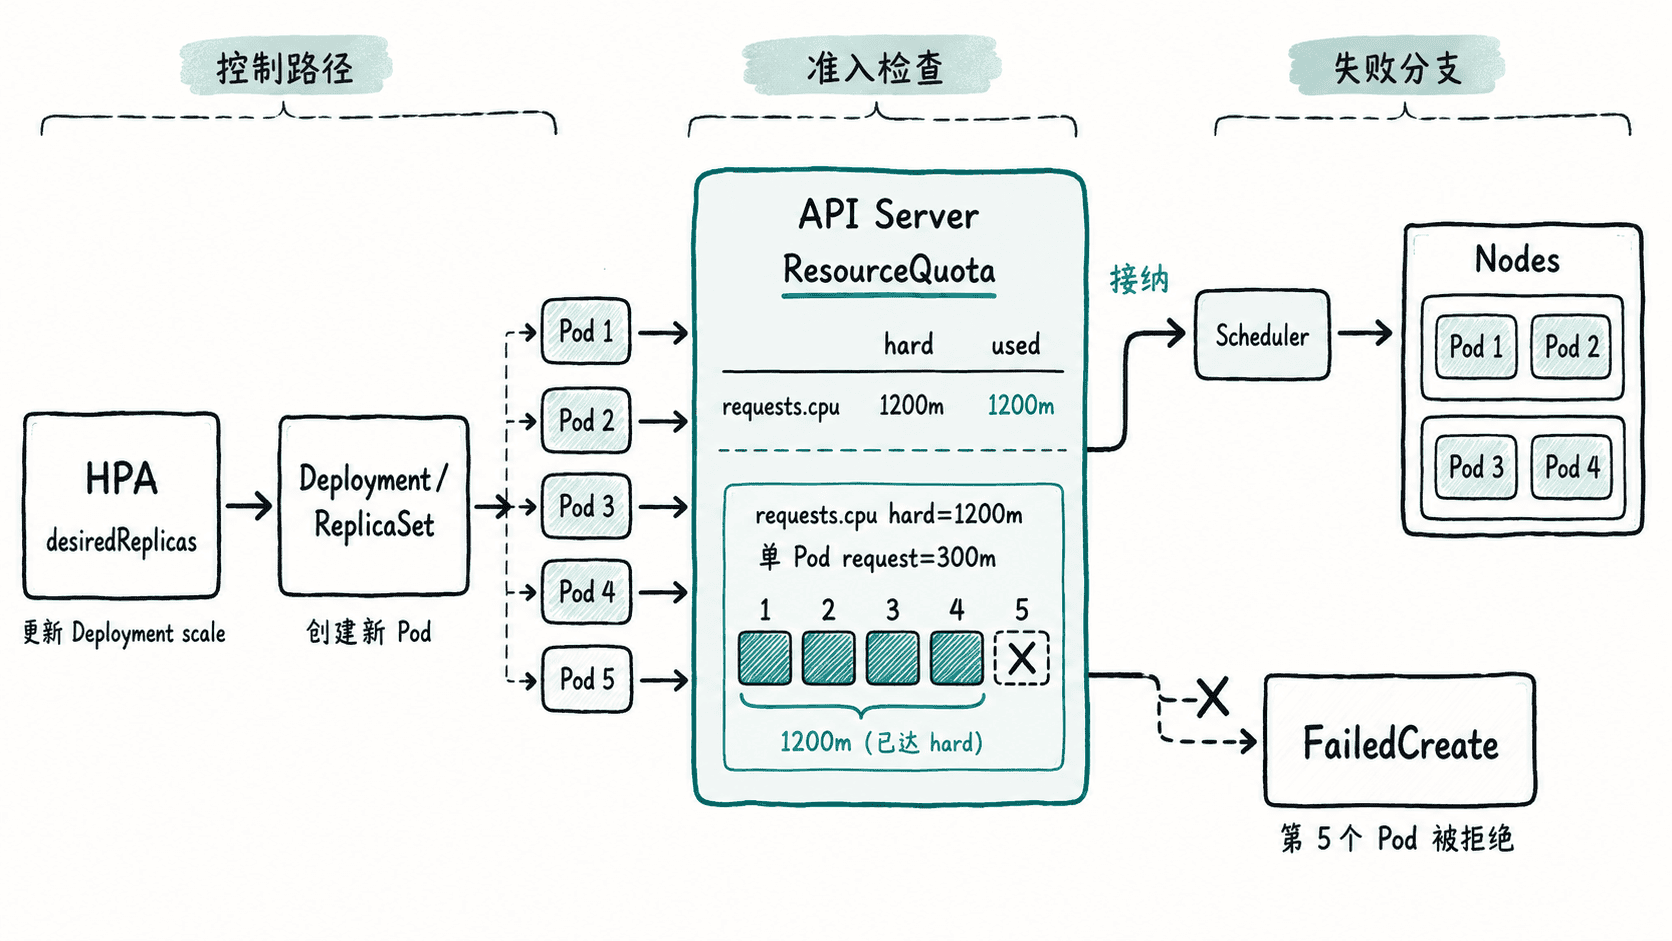
真正使用 HPA 时,现象通常是目标副本数已经升高,但实际 Pod 数长期达不到目标,同时 Deployment 事件持续出现 FailedCreate。HPA 不会绕过配额,也不会自动降低它自己的 maxReplicas。
让配额和伸缩上限对齐
容量预算不能只按稳态副本数计算。除了业务 Pod,还要给滚动发布的 maxSurge、故障重建和同命名空间中的其他工作负载保留余量,否则正常变更也可能被配额卡住。
可以先用每 Pod requests 推算理论上限,再取 CPU、内存和 Pod 数量三种约束中的最小值。例如本例 CPU 上限只能容纳 4 个副本,因此把 HPA 的 maxReplicas 设为 5 就存在结构性冲突。生产环境应把配额、HPA 上限和发布峰值一起评审,并对 ResourceQuota 接近耗尽以及 FailedCreate 事件建立告警。