
容器与云原生 / 系统课时
设计优先级与容量抢占边界
设计优先级与容量抢占边界
当集群容量不足时,真正需要回答的不是“哪个 Pod 更重要”,而是“谁先排队、谁可以抢占、谁绝不能依赖抢占获得保障”。本节用 PriorityClass 把业务等级翻译成可验证的调度规则,并明确抢占能做什么、不能做什么。
学习目标
- 区分 Pod 优先级、调度顺序与抢占行为,理解它们不是同一个概念。
- 为关键、常规和可让渡工作负载设计少量稳定的 PriorityClass。
- 用配置和演练验证容量紧张时的抢占边界,避免把 PriorityClass 当成容量预留。
先把“优先”拆成两个动作
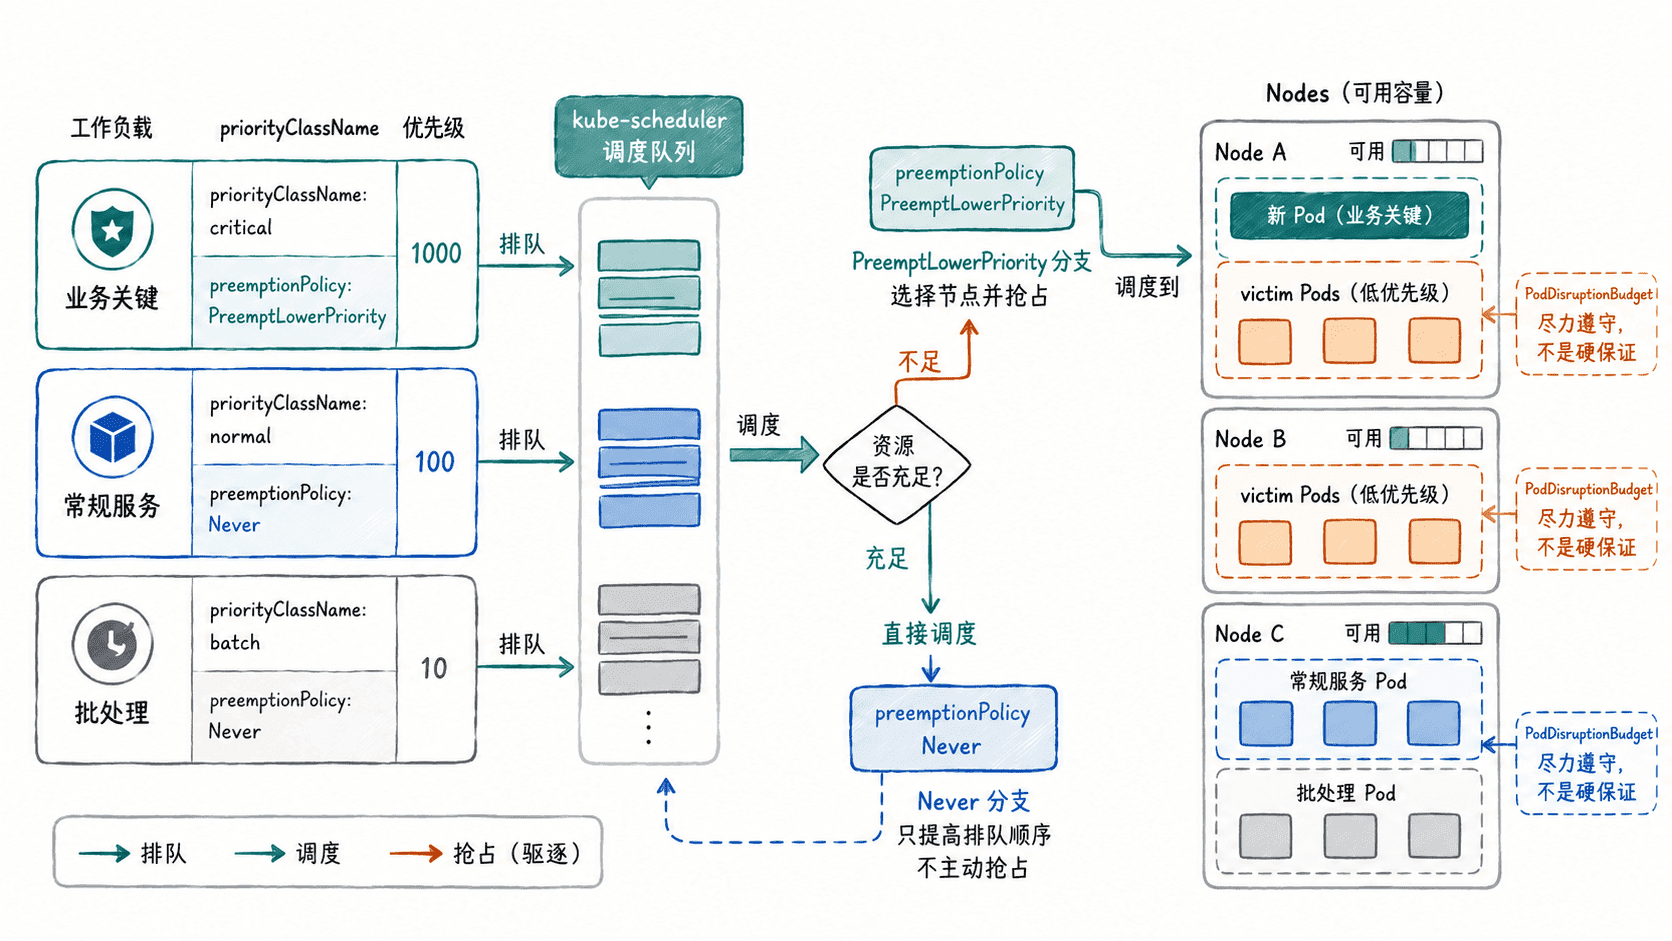
PriorityClass 是集群级对象,value 越大,Pod 的调度优先级越高。高优先级 Pod 通常会在调度队列中先于低优先级 Pod 被尝试调度,但它仍必须满足资源请求、亲和性、污点容忍、拓扑等约束。
当高优先级 Pod 因资源不足无法调度时,如果对应 PriorityClass 的 preemptionPolicy 为默认的 PreemptLowerPriority,调度器可以选择一个节点并抢占更低优先级的 Pod,为它释放资源。若设置为 Never,该 Pod 仍有更高的排队优先级,但不会主动驱逐低优先级 Pod。
用少量等级表达业务边界
不要为每个服务发明一个优先级数值。更稳妥的做法是先定义 3~5 个平台级等级,再规定什么业务可以使用。数值之间留出间隔,方便以后插入新等级,而不是依赖连续整数。
| 等级 | 示例值 | 是否主动抢占 | 适合对象 |
|---|---|---|---|
business-critical |
100000 | 是 | 核心入口、关键控制面依赖 |
business-standard |
50000 | 否 | 常规在线服务 |
batch-low |
10000 | 否 | 可延迟批任务、离线计算 |
如果没有设置全局默认 PriorityClass,未声明 priorityClassName 的 Pod 优先级为 0。治理命名空间最好通过准入策略要求显式分类,避免“漏配”意外变成最低优先级 victim。
下面的主示例创建三个 PriorityClass,并让一个关键 Pod 使用最高等级。这里显式写出 preemptionPolicy,避免依赖默认值造成治理含义不清。
apiVersion: v1
kind: List
items:
  - apiVersion: v1
    kind: Namespace
    metadata:
      name: capacity-lab
  - apiVersion: scheduling.k8s.io/v1
    kind: PriorityClass
    metadata:
      name: business-critical
    value: 100000
    globalDefault: false
    preemptionPolicy: PreemptLowerPriority
    description: "Critical online workloads allowed to reclaim lower-priority capacity."
  - apiVersion: scheduling.k8s.io/v1
    kind: PriorityClass
    metadata:
      name: business-standard
    value: 50000
    globalDefault: false
    preemptionPolicy: Never
    description: "Standard online workloads: queue first, but do not preempt."
  - apiVersion: scheduling.k8s.io/v1
    kind: PriorityClass
    metadata:
      name: batch-low
    value: 10000
    globalDefault: false
    preemptionPolicy: Never
    description: "Delay-tolerant batch workloads."
  - apiVersion: v1
    kind: Pod
    metadata:
      name: checkout-api
      namespace: capacity-lab
      labels:
        app: checkout-api
    spec:
      priorityClassName: business-critical
      containers:
        - name: app
          image: nginx:1.27-alpine
          resources:
            requests:
              cpu: 500m
              memory: 256Mi
把内容保存为 priority-boundary.yaml 后应用并读取实际解析出的优先级:
kubectl apply -f priority-boundary.yaml >/dev/null
kubectl get priorityclass business-critical business-standard batch-low -o custom-columns='NAME:.metadata.name,VALUE:.value,PREEMPTION:.preemptionPolicy'
kubectl get pod checkout-api -n capacity-lab -o custom-columns='NAME:.metadata.name,CLASS:.spec.priorityClassName,PRIORITY:.spec.priority'
预期输出:
NAME                VALUE    PREEMPTION
business-critical   100000   PreemptLowerPriority
business-standard   50000    Never
batch-low           10000    Never
NAME           CLASS               PRIORITY
checkout-api   business-critical   100000
这一步验证的是“策略已经被 API 接受并解析”,不是“已经发生抢占”。抢占只有在高优先级 Pod 无法正常放置、且移除一组更低优先级 Pod 后确实能够满足调度条件时才会发生。
不把 PDB 当成抢占防火墙
PodDisruptionBudget 主要用于限制自愿中断时同时不可用的副本数。调度器在选择抢占 victim 时会尽量避免违反 PDB,但这是尽力行为:如果找不到不违反 PDB 的 victim 组合,低优先级 Pod 仍可能被抢占。
因此,真正的“不能由该等级主动驱逐别人”应由发起方 PriorityClass 的 preemptionPolicy: Never 表达;“服务需要维持多少可用副本”再交给副本数、PDB、拓扑分散和容量余量共同保障。两者解决的问题不同。
用故障场景验收治理策略
上线前至少验证三种容量紧张场景:关键服务与批任务同时等待时,关键服务应先被调度;节点资源不足时,只有允许抢占的高优先级类可以驱逐低优先级 Pod;当节点上只有同级或更高优先级 Pod,或者调度约束仍不满足时,高优先级 Pod 应保持 Pending,而不是无限扩大破坏范围。
一套可维护的容量边界应该让“谁可以牺牲谁”在 PriorityClass、资源请求和工作负载等级表中都能被读出来。对于要求立即可用的关键服务,还必须保留真实可调度余量或专用容量;PriorityClass 只能决定容量不足时的选择顺序,不能替代容量本身。