
HTTP 与 Web 标准 / 系统课时
理解 Body 的传输边界
理解 Body 的传输边界
HTTP/1.1 允许在同一条 TCP 连接上连续传输多个消息,因此接收方必须准确知道当前 Body 在哪里结束。关键不是“等连接断开”,而是按报文语义和首部确定边界:有些响应根本没有消息体,有些按长度读取,有些按分块终止标记读取。
学习目标
- 判断 HTTP/1.1 请求或响应是否存在消息体
- 区分
Content-Length、Transfer-Encoding: chunked与连接关闭定界 - 识别边界首部冲突带来的解析和安全风险
为什么连接关闭不是默认边界
持久连接下,一个响应结束后连接通常还会继续承载下一次请求或响应。如果客户端把“连接断开”当作唯一结束信号,就无法可靠复用连接,也可能把后续字节误认为当前消息体的一部分。
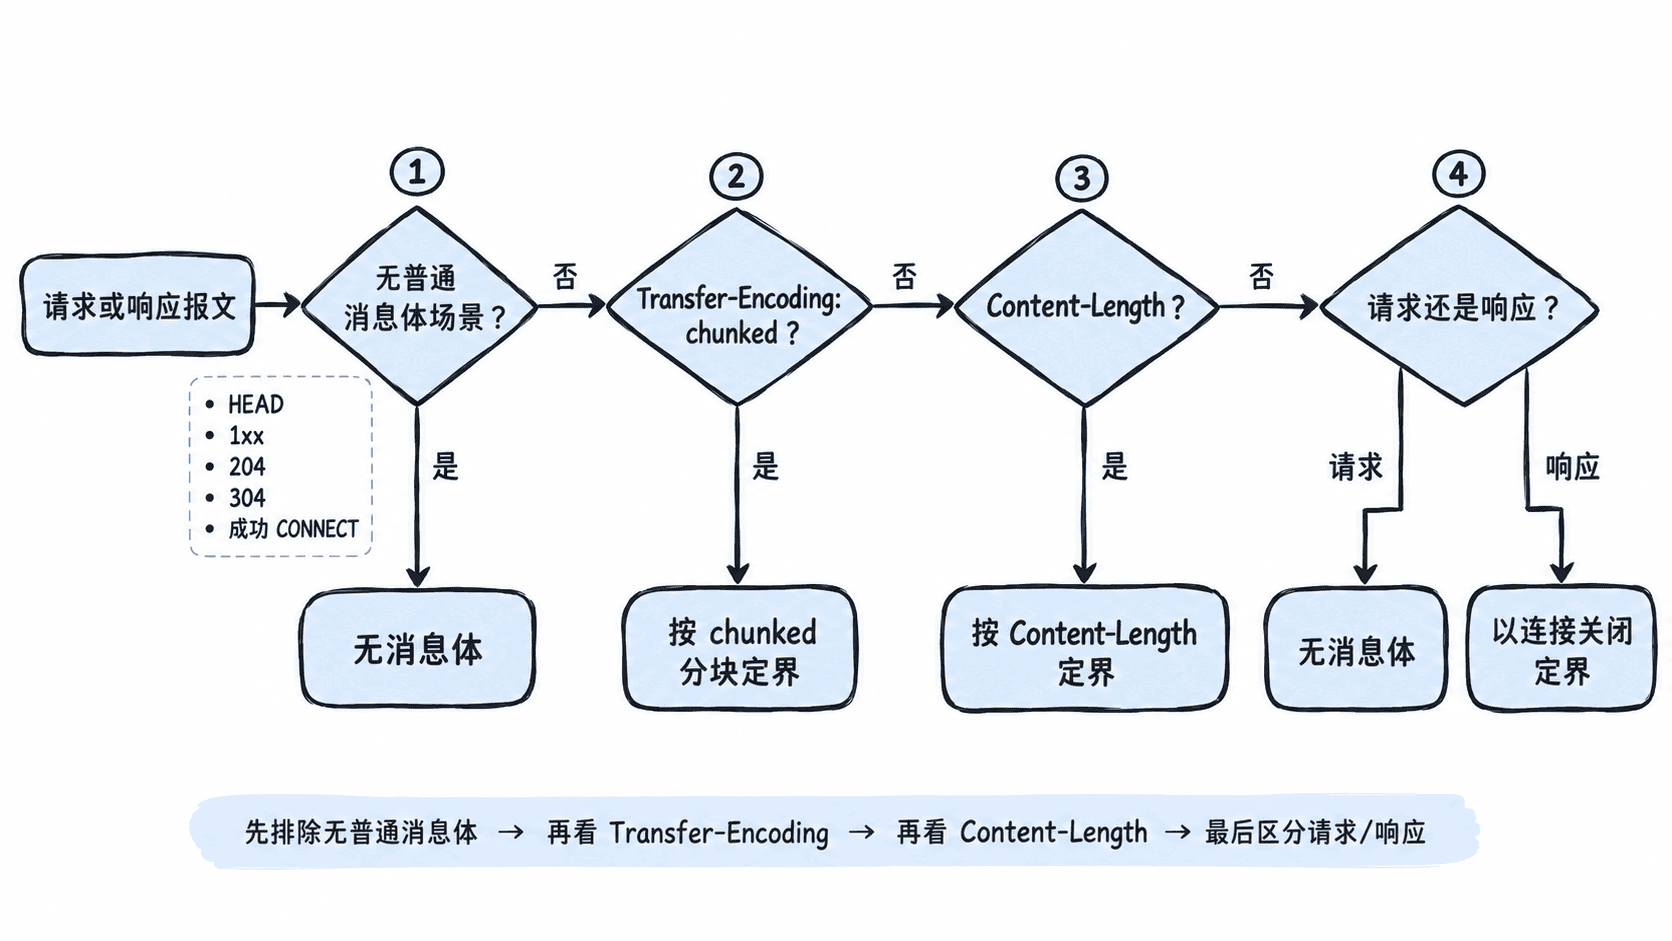
这套顺序很重要:先判断消息语义,再看传输边界首部。不能看到一个 Content-Length 就直接认定后面一定有同样长度的 Body。
Content-Length 按字节数定界
Content-Length 表示消息体的十进制字节数。接收方读满这些字节后,当前 Body 就结束;连接本身可以继续保持。
片段示例:下面省略了每行结尾的 CRLF。
POST /echo HTTP/1.1
Host: example.test
Content-Type: text/plain; charset=utf-8
Content-Length: 5

hello
这里的 Body 恰好是 5 个字节。对于 UTF-8 中文,字符数通常不等于字节数,因此不能用字符串长度随意填写 Content-Length。
如果声明长度大于实际发送字节数,接收方可能继续等待;小于实际长度时,多出的字节可能被当成下一条消息的开头。代理与源站若采用不同解析规则,还会放大请求走私等风险。
chunked 用终止块定界
HTTP/1.1 的分块传输不预先声明总长度,而是把 Body 拆成多个块。每块先给出十六进制长度,长度为 0 的块表示主体结束,之后还可能出现 trailer 字段。
片段示例:为便于阅读,仍未显式展示 CRLF。
HTTP/1.1 200 OK
Transfer-Encoding: chunked
Content-Type: text/plain

5
hello
6
 world
0
接收方不能把某个网络包、某次 read() 返回值或 TCP 分段当成 HTTP 块边界;真正的边界由 chunked 编码自身定义。
HTTP/2 和 HTTP/3 不使用 HTTP/1.1 的 chunked 文本编码,它们通过帧和流结束信号描述数据边界。
哪些响应没有普通消息体
并不是所有响应状态后都能继续读取 Body。对 HEAD 请求的响应,以及 1xx、204、304 响应,都按规则没有普通消息体;成功的 CONNECT 响应之后则进入隧道数据,而不是继续按普通 HTTP Body 解析。
其中 HEAD 或 304 中出现的某些长度元数据可以描述“若实际传输对应表示时会有多大”,但不能据此强行读取 Body。先看请求方法和状态码,再解释首部,能避免把下一条消息或隧道数据读错。
什么时候才用连接关闭定界
对于某些没有显式长度、也没有最终 chunked 定界的 HTTP/1.1 响应,关闭连接仍可作为主体结束信号。这是一种兜底方式,不适合被理解成所有响应的通用规则。
请求则不能依赖“客户端关连接”来表达正常消息体结束;缺少可识别的消息体边界时,服务器无法安全地区分请求结束与连接生命周期。实际排查抓包时,应先按“特殊无 Body 语义 → Transfer-Encoding → Content-Length → 必要时连接关闭”的思路判断。