
HTTP 与 Web 标准 / 系统课时
拆解 HTTP 响应报文
拆解 HTTP 响应报文
当你用浏览器开发者工具、curl -i 或抓包工具看到一段响应时,关键不是记住字段,而是先把它切成状态行、Header、空行和 Body,再判断状态码说明了什么、Header 如何描述正文,以及正文是否真的存在。
学习目标
- 能按顺序识别 HTTP/1.1 响应中的版本、状态码、原因短语、Header 与 Body。
- 能根据状态码和 Header 判断响应是否成功、正文如何解释以及是否应有 Body。
- 能用
curl查看真实响应,并区分协议结构与工具展示结果。
响应报文先按边界拆开
HTTP/1.1 的文本响应最容易从结构上理解:第一行是状态行,随后是一组 Header,Header 结束后有一个空行,空行之后才是 Body。只要先找到这个空行,报文的“控制信息”和“实际内容”就不会混在一起。
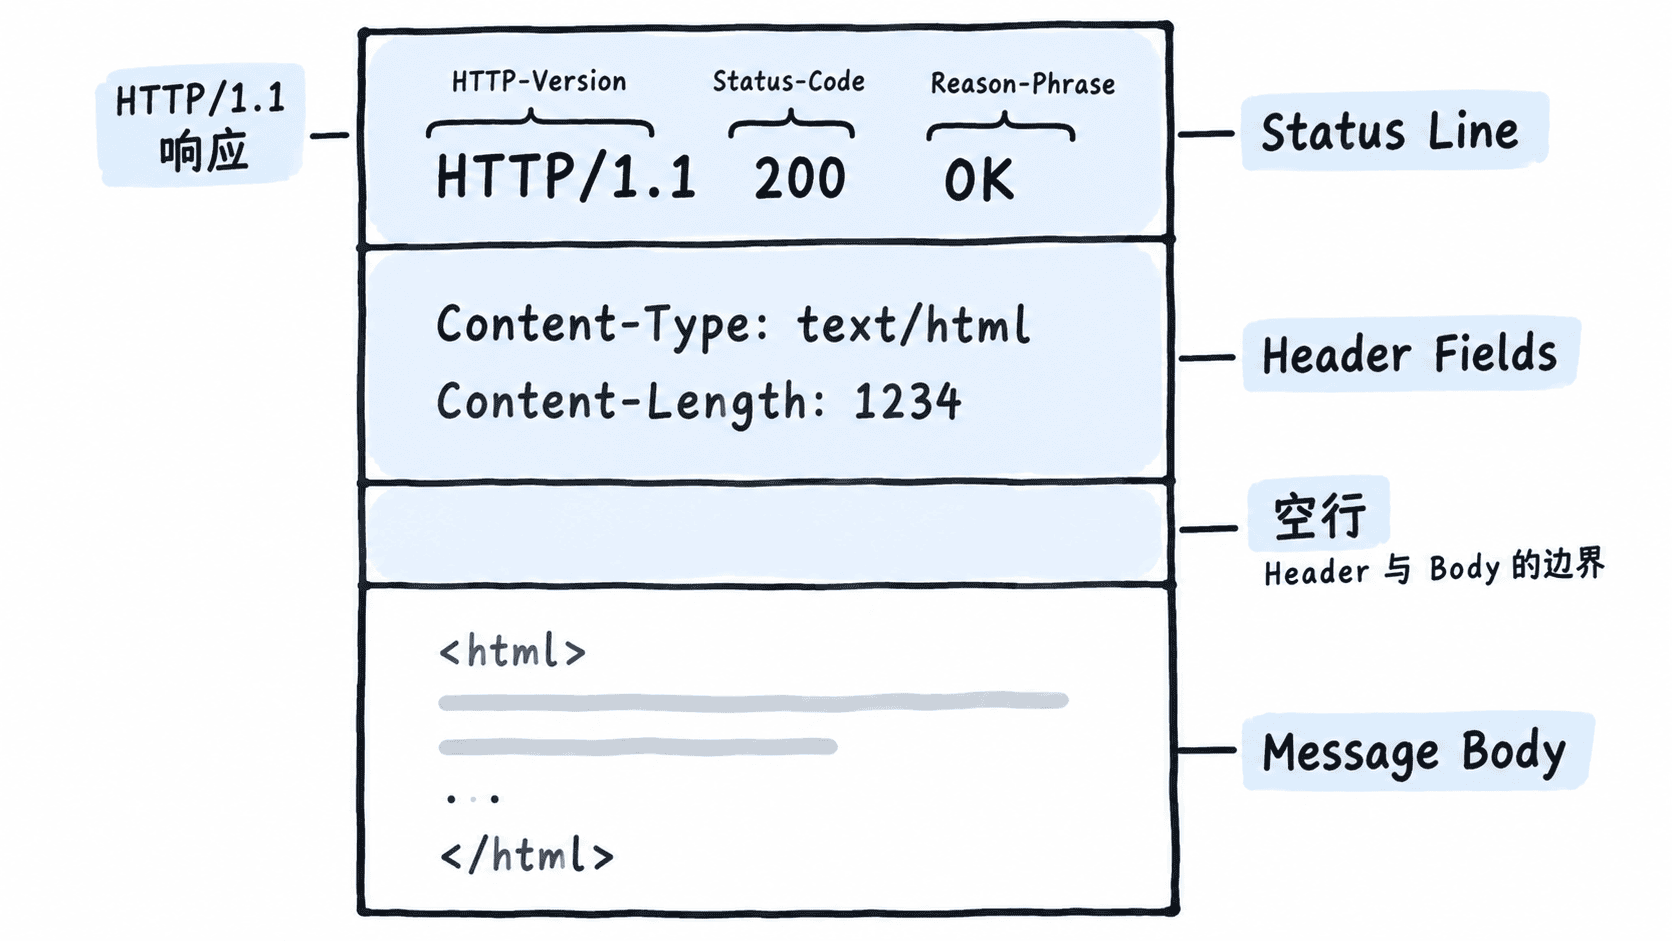
片段示例:下面是为了观察结构而简化的 HTTP/1.1 响应,不代表某个固定网站的完整输出。
HTTP/1.1 200 OK
Content-Type: application/json
Content-Length: 25
Cache-Control: no-store

{"message":"hello world"}
第一行决定“这次响应是什么结果”,Header 决定“接下来如何解释和处理”,Body 才承载具体资源内容。Body 可以为空,例如 204 No Content 响应就不应携带消息内容。
状态行分别回答三个问题
以 HTTP/1.1 200 OK 为例,三个部分的职责不同。
HTTP/1.1表示这段文本报文使用的 HTTP 版本语法。200是状态码,客户端应主要依据它判断处理分支。OK是原因短语,主要用于人类阅读,不应作为程序逻辑判断条件。
状态码的第一位表示类别:2xx 表示请求已成功处理,3xx 表示还需要重定向或缓存相关处理,4xx 表示客户端侧请求存在问题,5xx 表示服务端处理失败。实际代码应判断具体状态码,而不是解析原因短语文本。
Header 决定怎样解释 Body
Header 是响应的元数据和处理指令。例如 Content-Type: application/json 告诉客户端 Body 应按 JSON 解释,Content-Length 表示消息内容长度,Cache-Control 则影响缓存能否保存和复用响应。
不能仅凭“看见状态码 200”就假设 Body 一定存在,也不能仅凭文件扩展名决定正文类型。对于 HEAD 请求,服务器返回的 Header 应描述如果执行对应 GET 时会得到的表示,但响应本身不包含消息 Body;对于 204 和 304,协议也限制了消息内容。
解析时应先确认状态码是否允许 Body,再结合 Content-Type 等 Header 决定如何处理。如果传输使用分块编码等机制,消息边界也不能简单依赖 Content-Length。
用命令验证报文边界
为了只练结构、不受公网服务器和代理差异影响,可以在终端构造一份固定的 HTTP/1.1 响应。这里的 \r\n 表示协议中的 CRLF 行结束符。
printf '%s\r\n' \
  'HTTP/1.1 200 OK' \
  'Content-Type: application/json' \
  'Content-Length: 25' \
  'Cache-Control: no-store' \
  ''
printf '%s' '{"message":"hello world"}'
预期输出
HTTP/1.1 200 OK
Content-Type: application/json
Content-Length: 25
Cache-Control: no-store

{"message":"hello world"}
这个命令没有发起网络请求,只用于把报文边界直观打印出来。真正使用 curl -i <URL> 时,还会看到服务器实际返回的字段;分析方法仍然相同:先看状态行,再看 Header 与空行,最后读取协议允许存在的 Body。
读响应报文时,最稳定的顺序是:先看状态码确定处理结果,再看 Header 确定正文语义和缓存等规则,最后在协议允许的前提下读取 Body。