
HTTP 与 Web 标准 / 系统课时
理解 HTTP1 并发限制
理解 HTTP1 并发限制
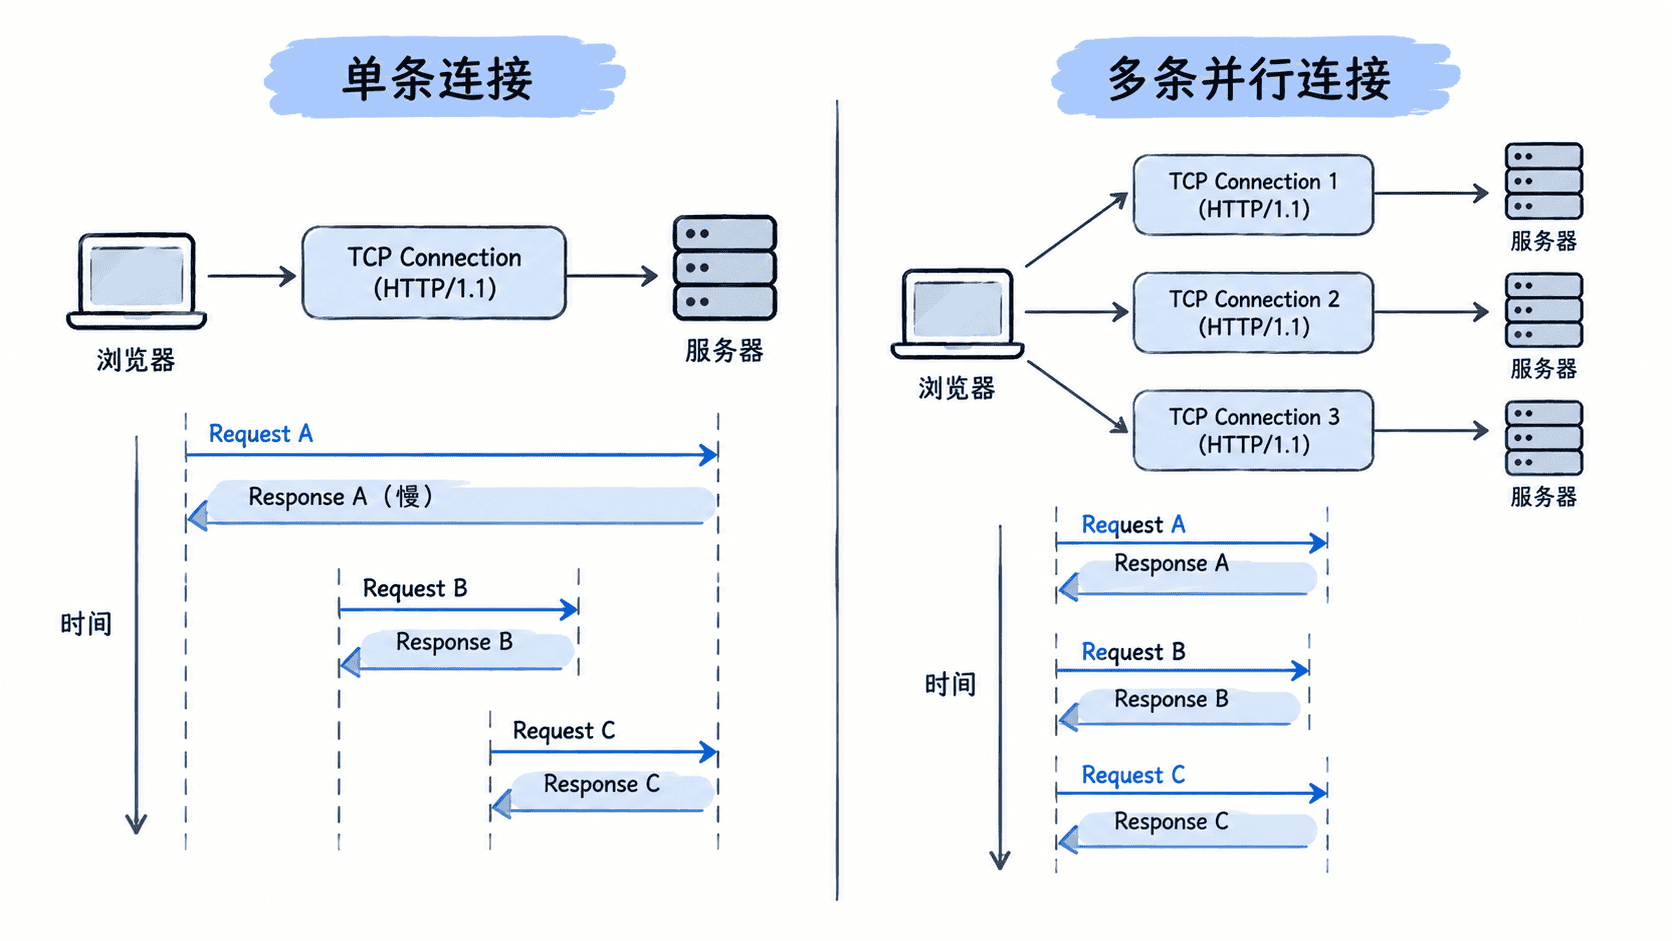
HTTP/1.1 可以复用连接,但复用并不等于真正的多路并发。同一条连接上的请求和响应存在顺序约束,一个慢响应可能拖住后续工作。浏览器因此常为同一站点建立多条并行 TCP 连接,用多个连接换取更高的资源加载并发度。
学习目标
- 理解 HTTP/1.1 单连接为什么难以实现真正的多路复用
- 解释队头阻塞与请求响应顺序之间的关系
- 理解浏览器建立多条并行连接的原因和代价
单条连接上的顺序约束
最容易理解的 HTTP/1.1 使用方式是:发送一个请求,等待对应响应结束,再在同一连接上发送下一个请求。这样能够复用 TCP,但同一时刻这条连接主要服务于一个请求响应过程。
HTTP/1.1 还定义过流水线机制,客户端可以连续发送多个请求而不逐个等待响应,但服务端必须按照请求顺序返回响应。只要排在前面的响应耗时较长,后面即使已经处理完成,也不能越过它先发送,这就是典型的应用层队头阻塞问题。由于实现复杂、代理兼容性和阻塞收益有限,浏览器长期以来通常不会依赖 HTTP/1.1 流水线来提高并发。
浏览器为什么建立多条连接
网页往往需要同时加载很多资源。若所有 CSS、JavaScript、字体和图片都排在一条 HTTP/1.1 连接上,任何较慢的资源都可能延迟后续请求。建立多条 TCP 连接后,不同资源可以分配到不同连接,某一条连接正在等待响应时,其他连接仍能继续工作。
浏览器会限制对同一来源建立的并行连接数量,而不是无限增加。具体上限属于浏览器实现策略,并非 HTTP/1.1 协议规定的固定数字;常见浏览器长期采用每个来源约数条连接的策略,但版本和场景可能不同。
多连接并不是免费的
增加连接可以提升 HTTP/1.1 下的并发度,但每条连接都要独立建立 TCP 状态,并占用客户端、服务端和中间设备的连接资源。HTTPS 连接还涉及 TLS 状态。连接过多会增加握手、内存、套接字和调度成本,因此浏览器只能在并发收益和连接开销之间折中。
过去曾出现“域名分片”做法,把静态资源分散到多个主机名,以绕开单一来源的并行连接限制。这种技巧主要针对 HTTP/1.x;在 HTTP/2 或 HTTP/3 中,多路复用已经改变了连接模型,刻意增加域名和连接反而可能失去连接复用收益。
与 HTTP2 的关键差别
HTTP/1.1 的核心限制是同一连接上的消息不能像独立通道那样自由交错。浏览器为了并发,常需要增加连接数量。HTTP/2 则把一条连接划分为多个逻辑流,不同请求和响应可以交错传输,从而显著减少为并发而建立多条 TCP 连接的需求。
不过 HTTP/2 仍运行在 TCP 之上,TCP 层丢包可能影响这条连接中的多个流;HTTP/3 使用 QUIC 后又进一步改变了这一层的阻塞行为。因此看到“HTTP/1.1 慢所以开多连接”时,应理解为协议并发模型造成的工程折中,而不是 Keep-Alive 本身失效。