
HTTP 与 Web 标准 / 系统课时
排查缓存不更新问题
排查缓存不更新问题
内容已经发布,但用户仍看到旧页面时,问题不一定出在浏览器。缓存可能停留在浏览器、代理或 CDN 任一层。本篇用响应头、绕过缓存和版本对比逐层定位,最终确认旧内容来自哪里,以及该改缓存策略、清理缓存还是修正资源版本。
学习目标
- 能区分浏览器缓存、代理缓存和 CDN 缓存造成的“旧内容”
- 能用 HTTP 响应头判断缓存是否仍然新鲜、是否发生重新验证
- 能按固定顺序修复并验证缓存更新问题
先判断旧内容停在哪一层
排查时不要先让用户“清浏览器缓存”。这只能证明本机缓存可能参与了问题,却无法解释其他用户为什么也旧。更有效的顺序是先确认源站内容,再检查共享缓存,最后检查浏览器本地状态。
浏览器可能命中内存缓存或磁盘缓存;企业代理、反向代理可能再次缓存;CDN 边缘节点又可能保存一份副本。若还使用 Service Worker,应把它视为浏览器前的一层应用级缓存。
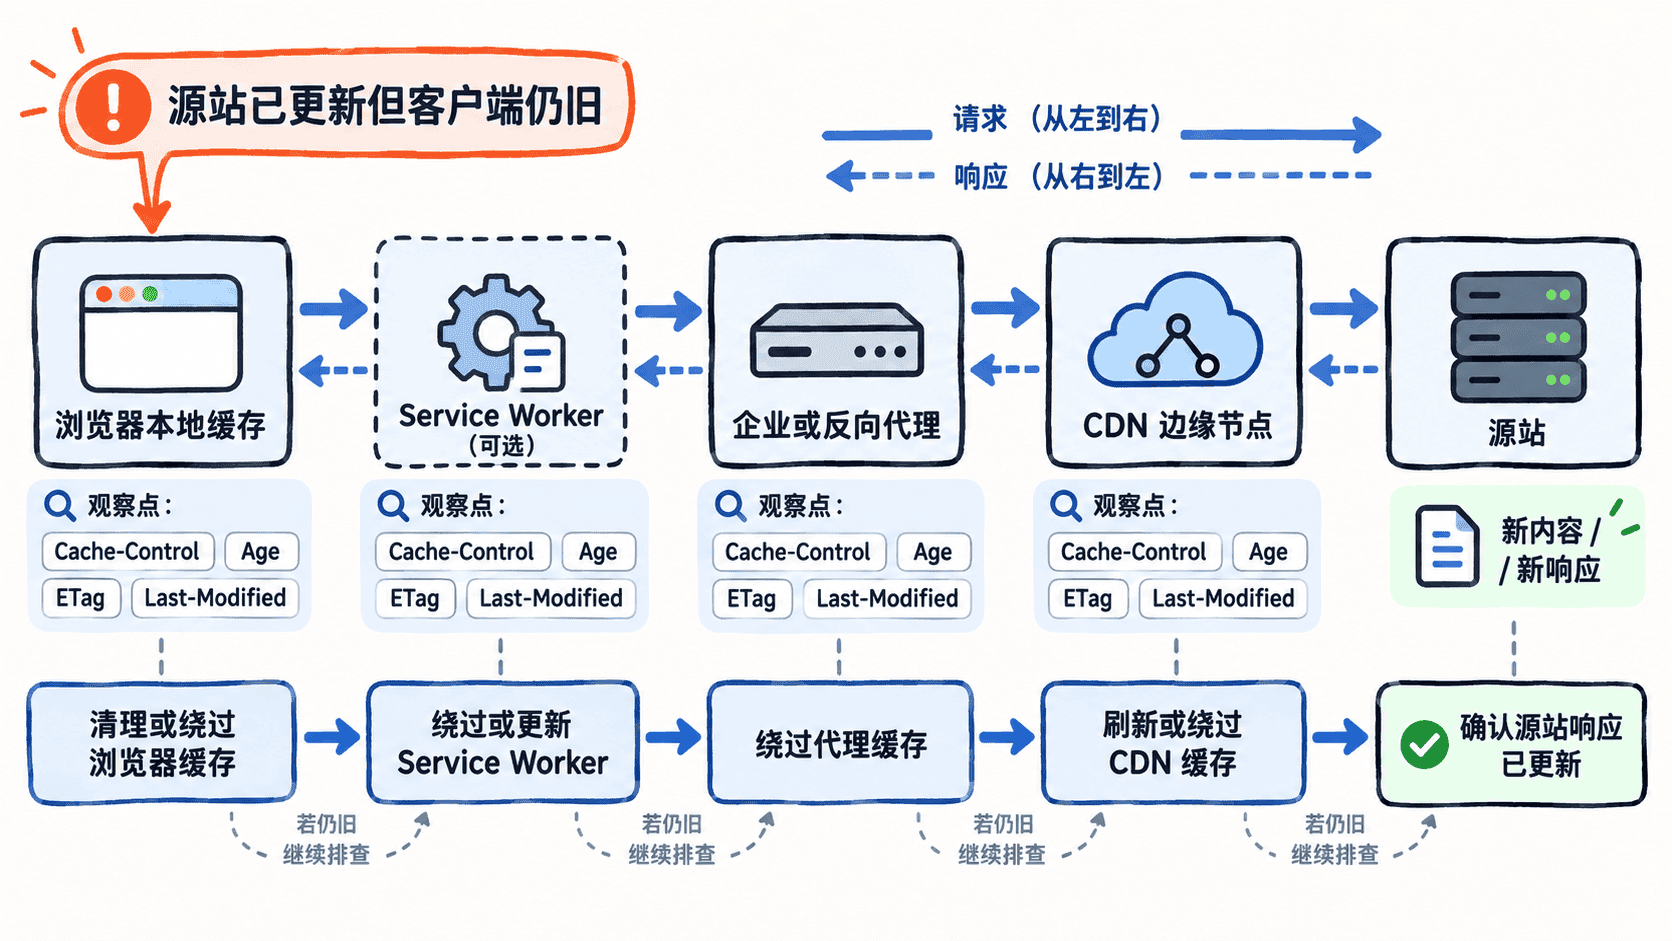
先看响应头,不要凭刷新结果猜
先对公开 URL 发一个只取响应头的请求,观察缓存控制与验证器。下面命令会保留状态行,并筛出最常用于定位缓存的响应头。
curl -sS -D - -o /dev/null "https://<HOST>/static/app.js" | grep -Ei '^(HTTP/|cache-control:|age:|etag:|last-modified:|via:)'如果该资源配置了共享缓存和验证器,预期输出形态可能如下;实际协议版本、字段数量和时间值会因服务配置而不同。
HTTP/2 200
cache-control: public, max-age=<TIME>
age: <TIME>
etag: "<ID>"
其中 <TIME> 代表运行时得到的秒数,<ID> 代表实际实体标签。Age 持续增长通常说明响应来自共享缓存;max-age 或 s-maxage 尚未过期时,缓存继续返回旧副本可能完全符合配置。ETag 或 Last-Modified 用于过期后的重新验证,验证成功时可能收到 304 Not Modified。
用绕过手段确认是哪一层
浏览器里先使用开发者工具的 Network 面板观察响应头和资源来源,再用命令行从浏览器之外复测。如果命令行已经拿到新内容,而浏览器仍旧,问题更靠近本机缓存、Service Worker 或浏览器扩展;如果不同设备都旧,则优先检查代理、CDN 和源站发布状态。
排查共享缓存时,可以临时给请求加 Cache-Control: no-cache,也可以使用仅用于诊断的查询参数生成不同 URL。注意,这两种方式都不是“强制绕过所有 CDN”的通用开关:代理可以按自己的策略处理请求头,也可能把查询参数排除在缓存键之外。
继续比较源站直连结果与公开域名结果。若源站已经是新版本,而公开域名仍是旧版本,问题就收敛到中间缓存层;若源站本身就是旧版本,应先检查发布目录、回源地址或部署版本,而不是继续清 CDN。
按根因修复,而不是一律清缓存
静态指纹资源最适合长缓存,例如文件名包含内容哈希的 app.<ID>.js。内容变化后 URL 同时变化,浏览器和 CDN 可以安全使用较长的 max-age,甚至配合 immutable。HTML 入口则通常需要较短缓存或重新验证,否则它可能一直引用旧的静态资源地址。
如果 CDN 缓存键配置错误,应检查主机名、路径、查询参数和必要的 Vary 维度是否参与区分;如果只是个别对象过期时间过长,可精准刷新对应 URL,而不是全站清缓存。若使用 ETag 或 Last-Modified,要确认内容变化后验证器也会变化,否则缓存可能错误地得到“未修改”的结论。
最后做一轮闭环验证
先确认源站版本正确,再访问公开 URL 并记录响应头;随后连续请求两次,观察 Age、状态码和验证器是否符合预期。最后换一个全新浏览器会话或另一台设备访问,确认结果不依赖本机历史状态。
当源站、共享缓存和浏览器三处都得到同一版本,并且缓存头与设计一致,问题才算真正解决。这样处理能把“刷新几次看起来好了”变成可重复、可验证的 HTTP 缓存排障流程。