
HTTP 与 Web 标准 / 系统课时
拆解 HTTP 请求报文
拆解 HTTP 请求报文
这一节从一段原始 HTTP/1.1 请求文本入手,识别请求行、请求头、空行和消息体的准确边界。掌握这种拆法后,遇到抓包、代理日志或接口调试信息时,就能快速判断每一段数据属于哪里。
学习目标
- 从原始文本识别 Method、Request Target 与 HTTP Version
- 找到 Header 结束位置以及 Body 的起始位置
- 理解
Content-Length与消息体字节数之间的关系
先看一份完整请求
片段示例:下面是 HTTP/1.1 请求的原始报文形态,需要来自抓包、代理调试、服务端日志或已建立的 TCP 连接,不能直接当作 shell 命令执行。
POST /api/orders?dryRun=true HTTP/1.1
Host: api.example.test
Content-Type: application/json
Content-Length: 35
Accept: application/json

{"productId":"p-1001","quantity":2}
这段文本只有四个结构区域:第一行是请求行;随后是若干请求头;一个空行结束 Header 区域;空行之后才是 Body。对 HTTP/1.1 来说,这个空行是解析边界,不是为了排版美观。
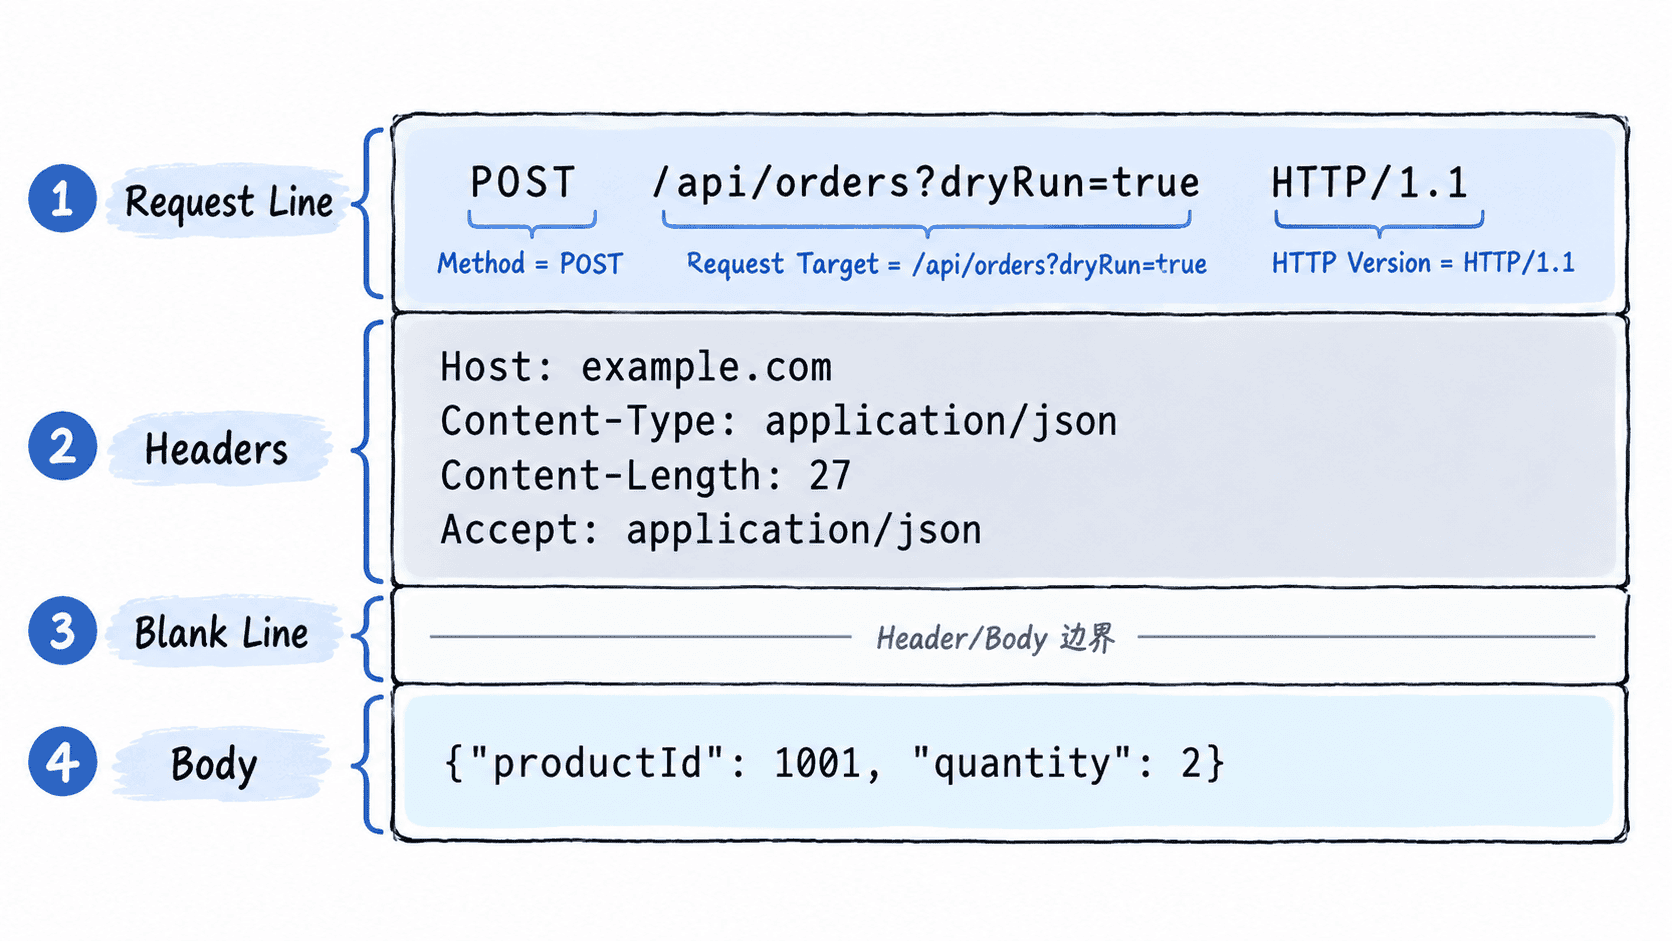
请求行决定“做什么、对哪里做、按什么版本说话”
请求行由三个部分组成,并以空格分隔:
| 部分 | 本例 | 作用 |
|---|---|---|
| Method | POST |
表示请求方法 |
| Request Target | /api/orders?dryRun=true |
指定资源路径与查询参数 |
| HTTP Version | HTTP/1.1 |
指明本条报文使用的协议版本 |
这里的 Request Target 不是完整 URL。客户端直连源站时,HTTP/1.1 最常见的是这种以 / 开头的 origin-form;目标主机则由 Host 请求头提供。代理、CONNECT 或 OPTIONS * 等场景还存在其他 target 形式,但不影响当前这份报文的拆解方法。
Header 到哪里结束
请求头采用“字段名: 字段值”的形式,一行一个字段。HTTP 字段名语义上不区分大小写,但实际开发中应保持常见写法以便阅读。解析时最关键的是找到连续的 CRLF CRLF,也就是一个空行;它标志着 Header 区域结束。
本例中的 Content-Type: application/json 描述 Body 的媒体类型,Content-Length: 35 表示后续消息体长度为 35 个字节。长度按字节计算,而不是按“看起来有多少个字符”估算;包含多字节 UTF-8 字符时,两者可能不同。
用代码验证边界和长度
下面的完整 Python 示例把同一份原始请求按 \r\n\r\n 分成 Header 与 Body,再拆出请求行三个字段,并核对消息体字节数。
raw_request = (
    "POST /api/orders?dryRun=true HTTP/1.1\r\n"
    "Host: api.example.test\r\n"
    "Content-Type: application/json\r\n"
    "Content-Length: 35\r\n"
    "Accept: application/json\r\n"
    "\r\n"
    '{"productId":"p-1001","quantity":2}'
)

header_block, separator, body = raw_request.partition("\r\n\r\n")
if not separator:
    raise ValueError("未找到 Header 与 Body 的空行边界")

request_line, *header_lines = header_block.split("\r\n")
method, target, version = request_line.split(" ", 2)

print(method, target, version)
print("header_count =", len(header_lines))
print("body_bytes =", len(body.encode("utf-8")))
预期输出:
POST /api/orders?dryRun=true HTTP/1.1
header_count = 4
body_bytes = 35
这个验证也说明了为什么不能只靠肉眼找 Body:协议解析依赖明确分隔符和长度信息。真实请求还可能使用 Transfer-Encoding: chunked 等传输方式,此时不能再把 Content-Length 当成唯一边界依据。
遇到异常报文时先查边界
如果服务端报告 JSON 解析失败,先确认问题是否真的出在 JSON。请求行格式错误、Header 与 Body 之间缺少空行、Content-Length 与实际字节数不一致,都可能让服务端在到达业务代码前就错误解析报文。
拆 HTTP 请求时始终按“请求行 → Header → 空行 → Body”的顺序定位,比从某个字段名称猜结构更可靠;一旦边界确定,再分析方法、目标、首部语义和消息体内容。