
HTTP 与 Web 标准 / 系统课时
理解 HTTP2 头部压缩
理解 HTTP2 头部压缩
HTTP 请求经常重复携带 :method、accept、cookie 等头字段。HTTP/2 不再把这些 Header 按 HTTP/1.1 的文本行原样重复发送,而是使用 HPACK 把头字段编码成更紧凑的 Header Block。本节重点理解静态表、动态表和 Huffman 编码如何协作,以及为什么编码双方必须维护一致状态。
学习目标
- 说明 HTTP/2 为什么需要专门的头部压缩机制
- 区分 HPACK 的静态表、动态表和 Huffman 编码
- 通过实际编码结果观察重复 Header 如何变得更短
为什么重复 Header 值得压缩
HTTP/1.1 中,头部本质上以文本字段反复出现。同一连接连续请求多个资源时,User-Agent、Accept、Cookie 或鉴权信息往往高度重复。对于正文很小的请求,Header 甚至可能占据明显比例。
HTTP/2 会先把请求头表示成“名称和值”的字段列表,再由 HPACK 编码成二进制 Header Block,放进 HEADERS 或 CONTINUATION Frame。这里压缩的是 Header 表示,而不是把整份 HTTP 报文交给通用压缩算法处理。
HPACK 怎样减少重复数据
HPACK 主要利用三类手段:
- 静态表:协议预定义常见头字段和常见值,例如
:method: GET。发送方可以用索引代替完整字符串。 - 动态表:连接双方根据已经出现过的字段维护一张可更新表。后续再次出现相同或相近字段时,可以引用之前的条目。
- Huffman 编码:对需要直接发送的字符串进行更紧凑的位级编码,进一步减少字节数。
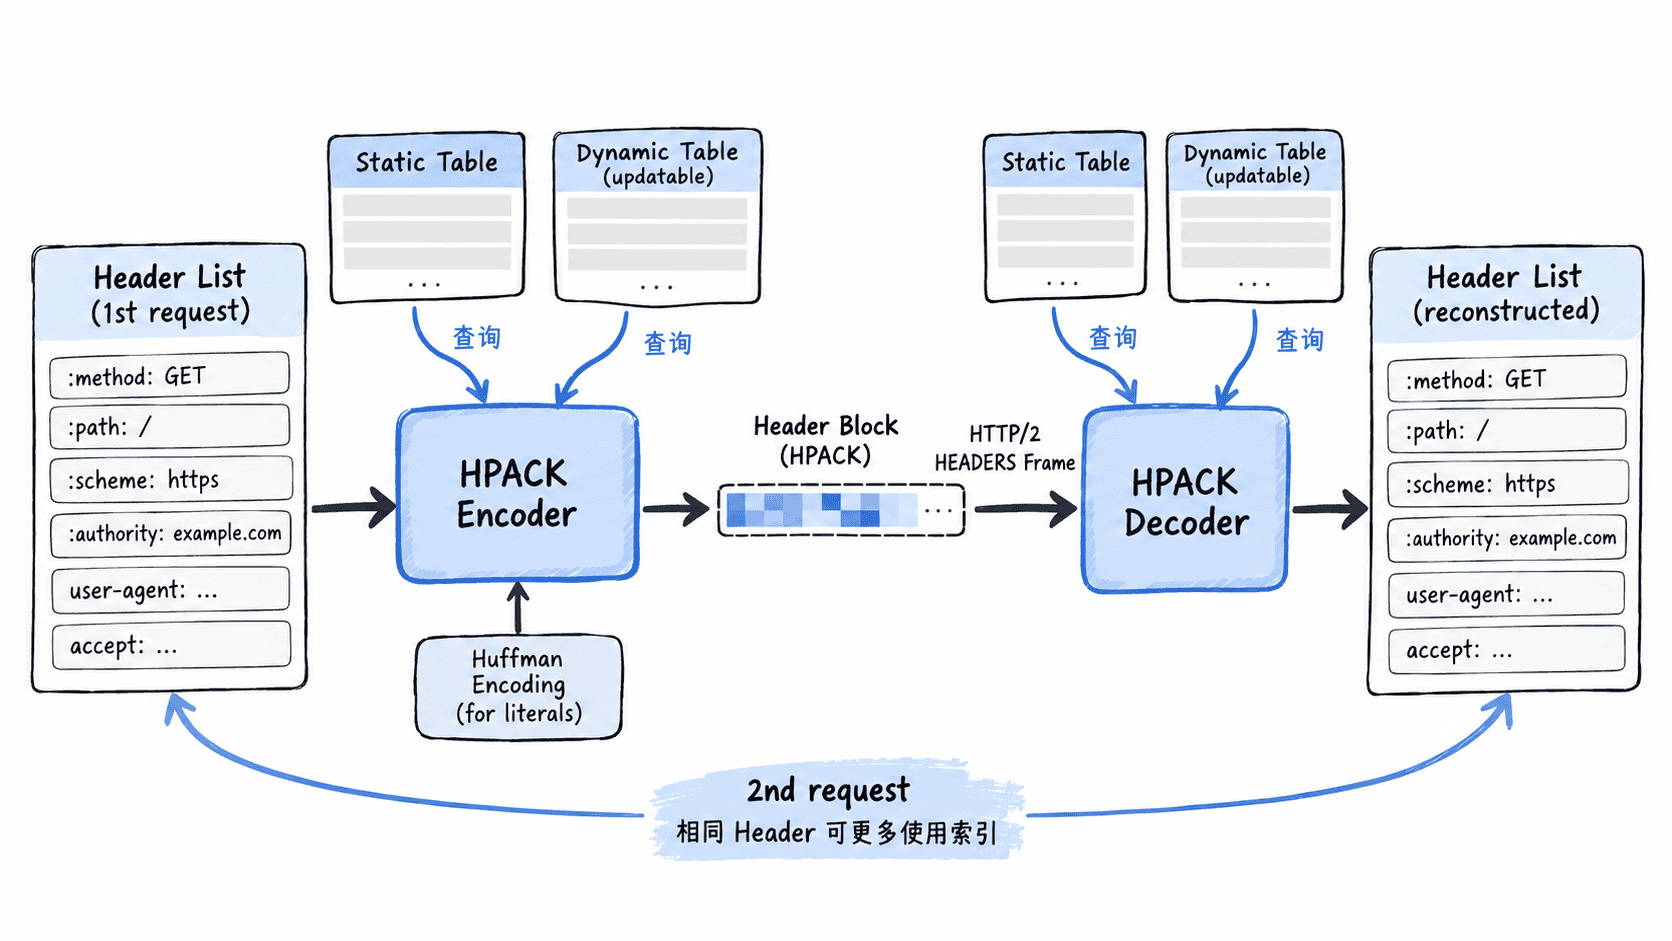
静态表是固定知识,动态表则依赖这条连接此前已经编码和解码过的 Header。也正因为动态表是有状态的,编码器和解码器必须按照协议规则保持一致,否则后续索引就无法正确还原。
用 hpack 库观察动态表复用
下面示例使用 Python 的 hpack 库。运行前需在当前 Python 环境安装该库,例如执行 python -m pip install hpack。程序用同一个编码器连续编码完全相同的 Header 列表,再用同一个解码器顺序还原两个结果。
from hpack import Decoder, Encoder

headers = [
    (":method", "GET"),
    (":scheme", "https"),
    (":authority", "example.com"),
    (":path", "/api/items"),
    ("accept", "application/json"),
    ("x-client", "anystack-demo"),
]

encoder = Encoder()
first = encoder.encode(headers)
second = encoder.encode(headers)

decoder = Decoder()
first_decoded = decoder.decode(first)
second_decoded = decoder.decode(second)

print(f"second_is_smaller={len(second) < len(first)}")
print(f"decoded_equal={first_decoded == second_decoded == headers}")
预期输出:
second_is_smaller=True
decoded_equal=True
第二次编码更短,是因为编码器已经可以复用先前建立的动态表条目。解码器之所以能恢复出同样的 Header,也依赖它按相同顺序处理第一个 Header Block,从而建立一致的动态表状态。
它和 HTTP/1.1 文本头的差别
HTTP/1.1 报文里可以直接看到类似 Accept: application/json 的文本行;HTTP/2 在线路上看到的则是 Frame 与经过 HPACK 编码的 Header Block。应用层语义仍然是 Header 名称和值,但传输表示已经改变。
当抓包或排查协议问题时,不应再用“寻找一整段明文 HTTP/1.1 请求头”的思路理解 HTTP/2。更准确的模型是:应用产生 Header 列表,HPACK 依据静态表和连接级动态状态编码,HTTP/2 再把编码结果放入相应 Frame 传输。