
HTTP 与 Web 标准 / 系统课时
完整分析一次 HTTP 请求
完整分析一次 HTTP 请求
一次 HTTP 故障不能只看状态码。本节把 DNS、TCP/TLS、请求报文、代理与缓存、服务端处理和响应传输串成一条证据链,并用一次可重复的采样判断时间究竟消耗在哪一段。
学习目标
- 能把一次 HTTPS 请求拆成可观测的 DNS、连接、TLS、首字节和响应传输阶段。
- 能结合状态码、响应头、代理与缓存信息判断请求实际经过了哪些组件。
- 能根据时间指标和服务端证据缩小故障范围,而不是仅凭“请求很慢”猜原因。
把一次请求拆成证据链
以常见的 HTTPS over TCP 为例,浏览器或客户端首先解析域名,然后与目标 IP 建立 TCP 连接,完成 TLS 握手并协商 HTTP 版本,随后发送请求。请求可能先到 CDN、反向代理或网关,再命中缓存或转发到源站,最终由应用生成响应并返回客户端。
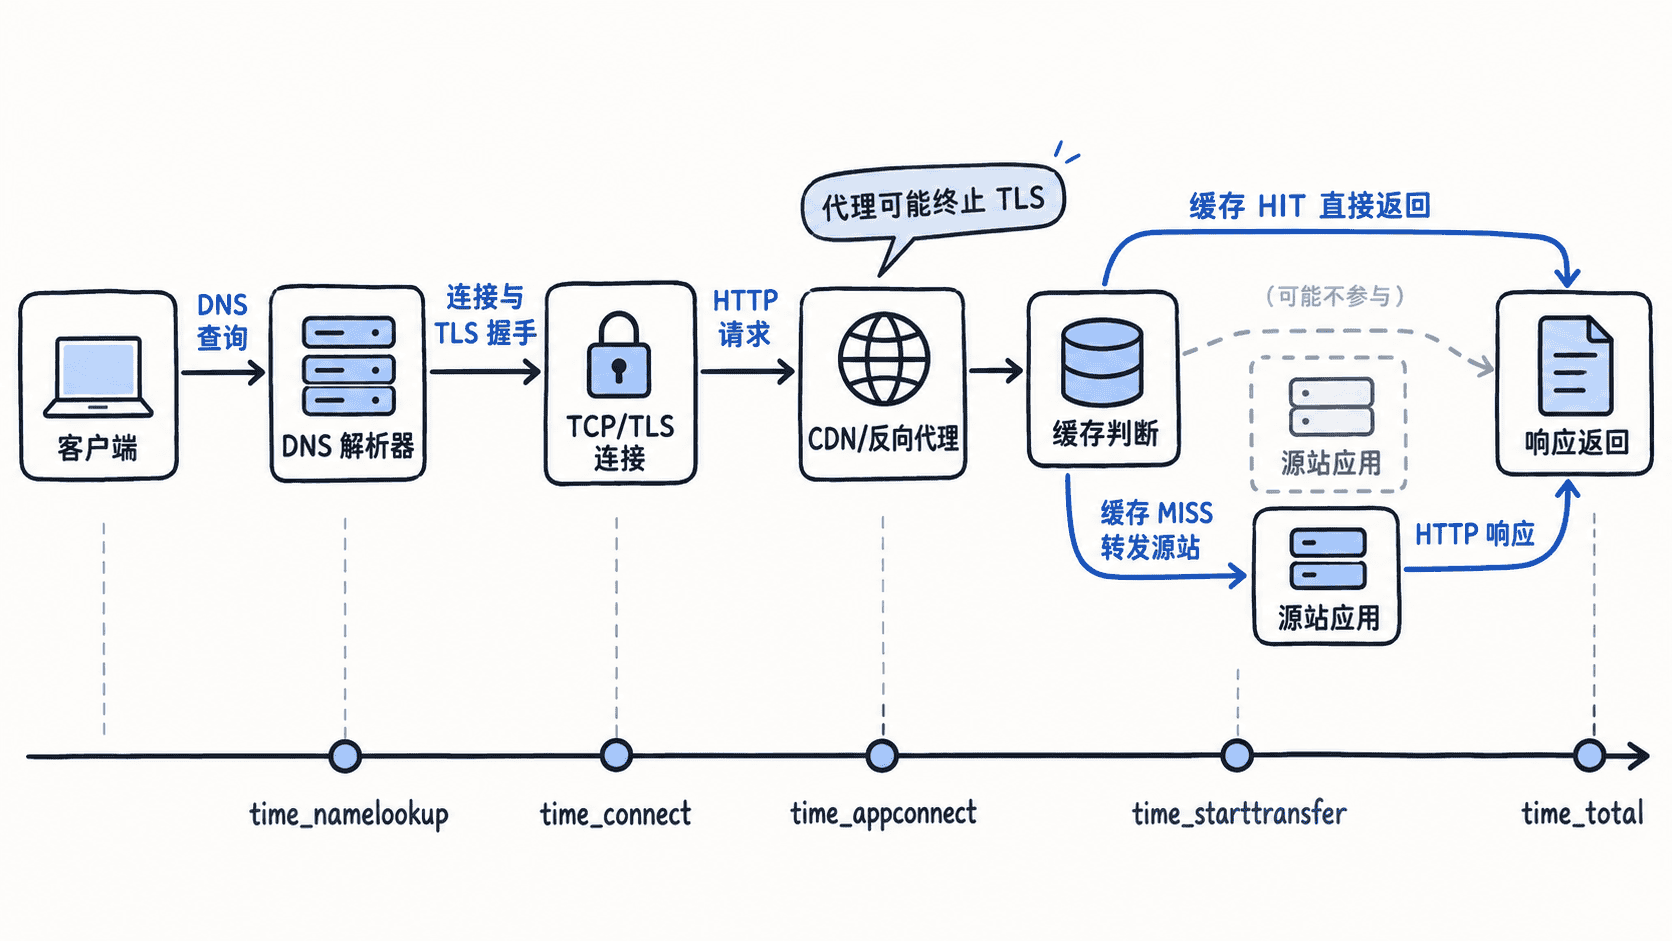
这条链路最重要的判断是:客户端看到的是端到端结果,不等于源站内部耗时。例如 TLS 可能终止在 CDN,缓存命中时源站甚至不会收到请求;而客户端的首字节时间会把代理排队、缓存查找、上游网络和应用处理一起包含进去。
用 curl 建立第一份时间证据
下面的命令同时记录关键阶段时间、最终状态码、连接到的远端地址,并把响应头保存到文件。curl 的这些时间值单位都是秒,而且大多是从请求开始累计到某个时间点。
curl -sS -D response-headers.txt -o /dev/null \
  -w 'dns=%{time_namelookup}\nconnect=%{time_connect}\ntls=%{time_appconnect}\nttfb=%{time_starttransfer}\ntotal=%{time_total}\nhttp=%{http_code}\nremote=%{remote_ip}:%{remote_port}\nredirects=%{num_redirects}\n' \
  https://example.com/
预期输出(实际时间、地址、状态码和重定向次数会因网络环境变化):
dns=<TIME>
connect=<TIME>
tls=<TIME>
ttfb=<TIME>
total=<TIME>
http=<STATUS>
remote=<IP>:<PORT>
redirects=<COUNT>
不要直接把 connect 当成“TCP 耗时”。这些值是累计时间,因此更有用的是做差:DNS 约为 dns,TCP 建连阶段约为 connect - dns,TLS 阶段约为 tls - connect,从 TLS 完成到收到首字节约为 ttfb - tls,响应体传输约为 total - ttfb。
对普通 GET 请求来说,若 ttfb - tls 明显偏大,问题通常已经不在 DNS、TCP 或 TLS,而是在代理排队、缓存查找、代理到源站的上游连接、应用处理或数据库等后端依赖。若 total - ttfb 才明显偏大,则更应检查响应体大小、压缩、带宽和客户端接收速度。
把代理、缓存和报文放回链路
时间只能告诉你“慢在哪一段”,响应头和日志才帮助判断“是哪一层造成的”。先查看前一步保存的 response-headers.txt,重点寻找与缓存、代理和链路关联有关的字段。
报文层还要确认请求本身是否正确。在客户端调试信息、代理访问日志或服务端接入日志中核对方法、路径与查询参数、Host 或 HTTP/2 的 :authority、Content-Type、请求体长度以及认证头是否按预期到达。错误路径导致的 404、认证头被代理剥离导致的 401,都可能发生在连接完全正常的情况下;记录证据时应对 Cookie、Token 等敏感值脱敏。
Cache-Control 描述缓存策略;Age 在共享缓存响应中可表示对象已在缓存中存放的秒数;Via 可暴露经过的中间代理;Server-Timing 如果服务端或网关主动提供,可携带后端阶段耗时。它们都不是“完整链路证明”:代理可以删除或改写头部,CDN 也常使用厂商自定义字段。
状态码也要结合产生位置解释。502、504 常见于网关无法正常获得上游响应,但仅凭状态码不能证明一定是代理故障;源站也可能返回同样的代码。304 表示条件请求验证后复用已有内容,不等于“这次完全没有访问上游”。判断时应同时关联请求 ID、代理访问日志和应用日志。
缓存尤其容易误判。若响应由边缘缓存直接返回,客户端测到的首字节时间主要反映客户端到边缘节点的链路和缓存处理;若缓存 MISS,ttfb 还会把边缘节点访问源站的时间包含进去。客户端通常无法把这段上游耗时自动拆成单独一项。
按时间特征缩小故障范围
| 观测现象 | 优先怀疑的阶段 | 下一步证据 |
|---|---|---|
dns 明显偏大 |
DNS 解析器、网络或域名解析链 | 对比不同解析器、检查 DNS 日志和解析结果 |
connect - dns 偏大 |
到目标 IP 的网络、路由、防火墙或边缘节点 | 核对 remote_ip,检查网络路径与代理接入点 |
tls - connect 偏大 |
TLS 握手、网络 RTT、证书链或终止 TLS 的代理 | 检查握手日志、证书链和代理 TLS 配置 |
ttfb - tls 偏大 |
代理排队、缓存 MISS、上游连接、应用或数据库 | 关联 Via、缓存头、请求 ID、网关与应用日志 |
total - ttfb 偏大 |
响应体过大、压缩不足、带宽或丢包 | 检查响应大小、压缩方式和传输速率 |
redirects 大于 0 |
重定向链增加额外请求 | 逐跳检查 Location,确认是否存在循环或多余跳转 |
一次完整分析应遵循“先客户端、再代理、后源站”的顺序。先确认 DNS、连接和 TLS 是否正常,再看 HTTP 状态、重定向与缓存信息,最后才进入应用日志和数据库。这样可以避免在网络阶段已经异常时,却先去调应用线程池或 SQL。
用一组数据完成判读
假设一次采样得到 dns=0.010、connect=0.045、tls=0.090、ttfb=0.620、total=0.650。换算后,TCP 建连约 35 ms,TLS 约 45 ms,而 TLS 完成到首字节约 530 ms;响应体只用了约 30 ms。此时主瓶颈显然集中在首字节之前,而不是下载阶段。
接着检查响应头:如果存在可证明共享缓存命中的证据,源站可能并未参与,应优先查看边缘节点和代理;如果缓存未命中,并且同一请求 ID 在应用日志中显示约 500 ms 的处理时间,就能把问题进一步收敛到服务端。反之,若应用日志只有几十毫秒,而客户端仍等待 530 ms,则需要继续检查网关排队、代理到源站的网络和上游连接复用。
完整链路分析的关键不是收集越多指标越好,而是让每条证据回答一个具体问题:域名是否正确解析、连接建立到哪里、TLS 在哪里终止、请求是否经过代理、缓存是否参与、首字节之前是谁在等待、响应体又花了多久。把这些答案按时间顺序拼起来,才能得到可验证的 HTTP 故障结论。