
HTTP 与 Web 标准 / 系统课时
用 curl 观察一次请求
用 curl 观察一次请求
这一节用 curl 把一次 HTTPS 请求的关键痕迹直接摊在终端里:连接到哪里、发出了哪些请求头、服务器返回了什么状态与响应头。读完后,你能把协议里的“请求—响应”与真实命令输出逐项对应起来。
学习目标
- 用
curl -v观察连接过程、请求头和响应头 - 区分 curl 的调试标记、HTTP 报文内容与最终状态码
- 用
-w提取状态码、远端 IP 和实际 HTTP 版本
把一次请求完整摊开
下面只下载响应但丢弃正文,让终端重点保留连接与报文信息。--http1.1 固定使用 HTTP/1.1,便于直接看到传统请求行;-v 输出连接和首部细节,-w 在结束时打印几个关键指标。
curl --http1.1 -v -o /dev/null -sS \
  -w '\nstatus=%{http_code}\nremote_ip=%{remote_ip}\nhttp_version=%{http_version}\n' \
  https://example.com/
预期输出(具体 IP、curl 版本、TLS 细节和部分响应头可能不同):
* Host example.com:443 was resolved.
* IPv4: <IP>
*   Trying <IP>:443...
* Connected to example.com (<IP>) port 443
> GET / HTTP/1.1
> Host: example.com
> User-Agent: curl/<VERSION>
> Accept: */*
>
< HTTP/1.1 200 OK
< Content-Type: text/html
< ...
status=200
remote_ip=<IP>
http_version=1.1
<IP> 和 <VERSION> 是动态值,实际输出以当前网络和本机 curl 为准。命令中的 -o /dev/null 只丢弃响应正文,不会阻止 -v 显示首部信息。
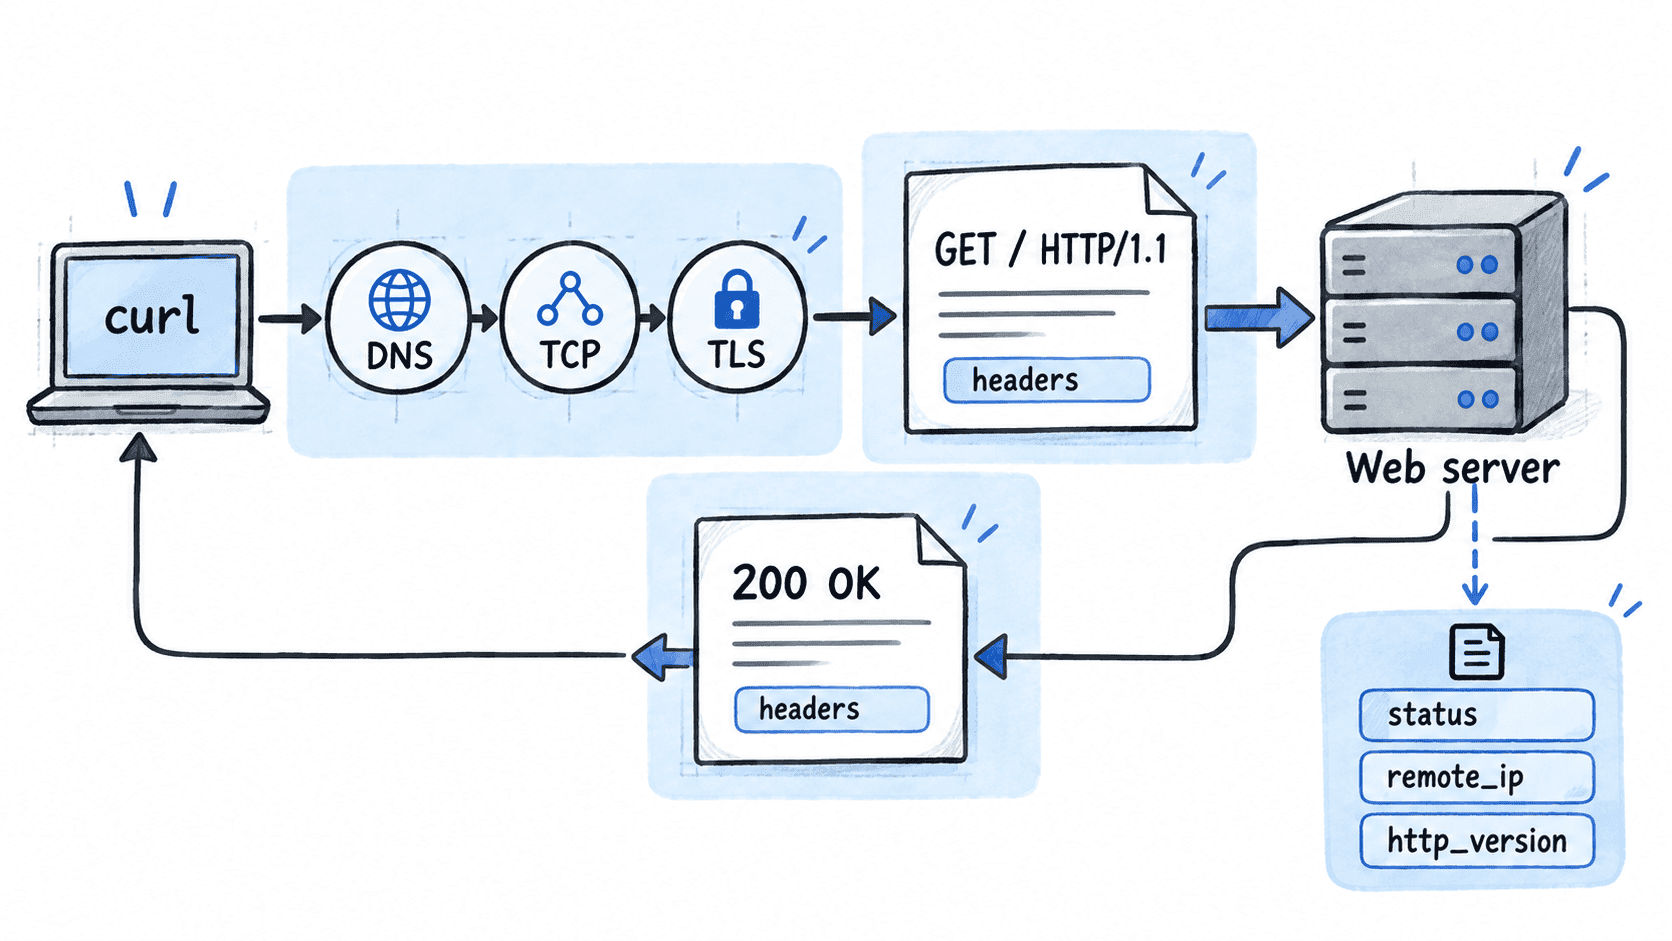
逐行认出信息属于哪一层
curl 的 verbose 输出会在行首加辅助符号,这些符号不是 HTTP 报文本身。读输出时先按符号分类,再看具体字段。
| 行首 | 含义 | 典型内容 |
|---|---|---|
* |
curl 的连接或调试信息 | DNS、目标 IP、TCP/TLS 连接 |
> |
客户端发出的 HTTP 内容 | 请求行、Host、User-Agent |
< |
服务器返回的 HTTP 内容 | 状态行、响应头 |
| 无固定符号 | -w 的统计结果 |
状态码、远端 IP、HTTP 版本 |
因此 * Connected to ... 说明的是传输连接已经建立,不是服务器返回的 HTTP 响应;真正的响应从 < HTTP/1.1 200 OK 开始。
把几个关键字段对应到协议概念
GET / HTTP/1.1 是请求行:GET 是 Method,/ 是 Request Target,HTTP/1.1 是协议版本。紧随其后的 Host、User-Agent 和 Accept 属于请求头,空的 > 行表示请求头结束。
响应侧的 HTTP/1.1 200 OK 是状态行,其中 200 才是 HTTP 状态码。Content-Type 等 < 开头的行属于响应头。最后 status=200 是 curl 从响应中提取出的数值,不是服务器额外发送的一行报文。
避免把连接信息和 HTTP 信息混在一起
HTTPS 请求在发送 HTTP 数据前还要完成 DNS、TCP 和 TLS 等步骤,所以 verbose 输出通常比“请求行加响应行”长得多。排查时可以先问两个问题:是否成功连接到预期主机与端口,以及连接成功后是否收到了 HTTP 状态行。前者失败时通常还没进入 HTTP 层,后者出现后才适合继续分析状态码和响应头。
另外,不要把一次请求的 remote_ip 等同于站点唯一服务器地址;CDN、负载均衡、代理和 DNS 调度都可能让不同请求连接到不同 IP。用这种分层读法,curl 的长输出就会从一堆日志变成一条清晰的请求链路。