
HTTP 与 Web 标准 / 系统课时
理解建立连接的实际成本
理解建立连接的实际成本
一个接口明明只返回几 KB 数据,却可能在第一次访问时耗费数百毫秒。原因往往不在传输正文,而在正文发送前必须完成的 DNS 查询、TCP 建连和 TLS 握手。本篇把这些固定成本拆开,并用实际计时理解为什么短请求尤其依赖连接复用。
学习目标
- 能说清 DNS、TCP、TLS 分别发生在请求链路的什么位置
- 能用 RTT 理解连接建立为什么会放大短请求延迟
- 能使用
curl拆分一次 HTTPS 请求的关键时间点
首次 HTTPS 请求在首字节前做了什么
对典型的 HTTP/1.1 或 HTTP/2 HTTPS 请求来说,客户端首先需要把域名解析成可连接的地址;若没有可复用连接,随后进行 TCP 三次握手;在 TCP 之上还要完成 TLS 握手,最后才能发送 HTTP 请求并等待服务器产生首字节。
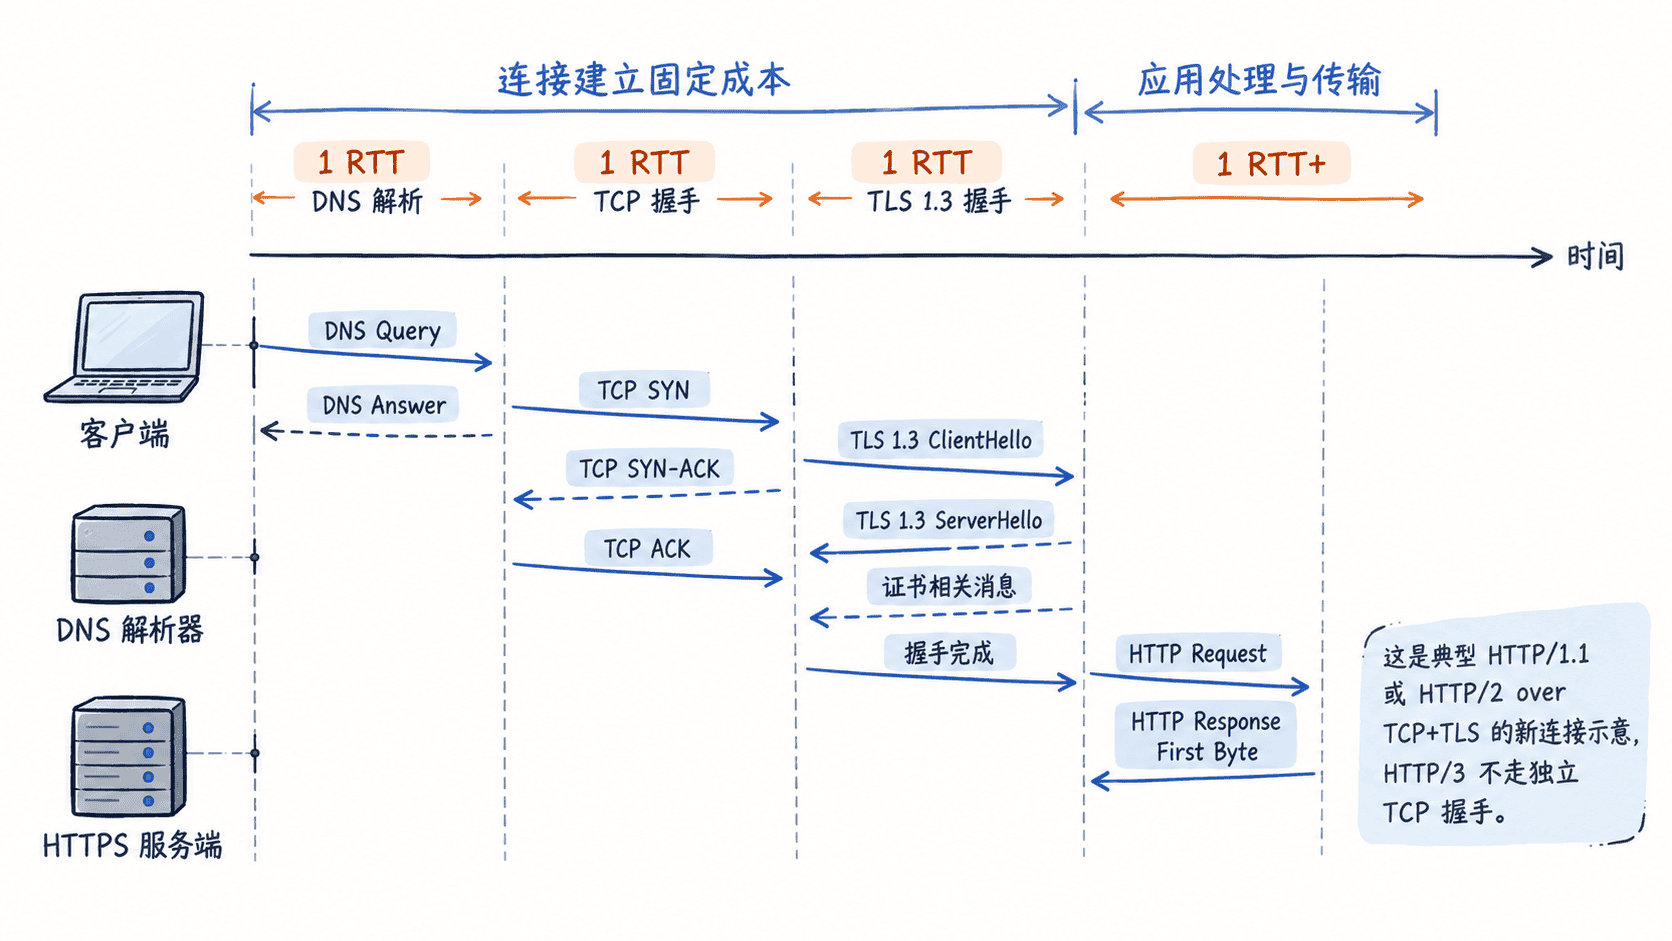
DNS 并不总是产生网络开销,因为操作系统、浏览器和递归解析器都可能已有缓存。TCP 建连通常至少需要一个往返时间 RTT;对新的 TLS 1.3 会话,TLS 握手通常还要再消耗约一个 RTT。TLS 1.2、代理链路或特殊认证流程可能需要更多往返。
HTTP/3 的情况不同:它基于 QUIC,把传输层建立和 TLS 1.3 握手结合起来,因此不能直接套用“TCP 一个 RTT 加 TLS 一个 RTT”的模型。
用 RTT 看固定成本为何显眼
RTT 是一个数据包从客户端到服务端再返回所需的往返时间。假设客户端到服务端 RTT 约为 80 ms,那么一个新的 TCP 连接再加一次典型 TLS 1.3 握手,仅握手就可能消耗大约 160 ms,还没有算 DNS、服务器处理和响应正文传输。
对 2 KB、5 KB 这类短响应,正文传输时间通常很短,固定握手成本反而占据总延迟的大部分。请求越短、网络越远,这个现象越明显;大文件传输则更容易被带宽和拥塞控制影响。
用 curl 拆分一次请求时间
可以让 curl 输出一次 HTTPS 请求的关键计时点。下面示例适用于安装了 curl 的 Bash 环境,<HOST> 替换为实际域名。
curl -o /dev/null -sS \
  -w 'dns=%{time_namelookup}\nconnect=%{time_connect}\ntls=%{time_appconnect}\nstarttransfer=%{time_starttransfer}\ntotal=%{time_total}\n' \
  "https://<HOST>/"
预期输出格式如下,实际秒数会随网络、DNS 缓存和服务端状态变化。
dns=<TIME>
connect=<TIME>
tls=<TIME>
starttransfer=<TIME>
total=<TIME>
这些值是从请求开始累计到各阶段完成的时间,而不是每个阶段单独耗时。要估算 TCP 阶段,可用 connect - dns;要估算 TLS 阶段,可用 tls - connect;starttransfer - tls 则大致包含发送请求、网络往返和服务端处理到首字节的时间。
连接复用改变了什么
HTTP 持久连接的价值,是让后续请求跳过已经支付过的 DNS、TCP 和 TLS 成本。HTTP/1.1 可以在同一连接上连续发送多个请求;HTTP/2 还能在一个连接上并发复用多个请求流,因此特别适合页面同时加载大量小资源或 API 客户端频繁访问同一主机。
连接也不会永久存在。浏览器、客户端连接池、负载均衡器、NAT 和服务器都有空闲超时或连接上限。一旦连接被关闭,下一个请求又要重新支付建连成本。因此优化短请求时,重点不是“让握手本身消失”,而是让连接池、持久连接和协议复用尽可能提高已有连接的利用率。
理解这条时间线后,再看到“首个请求慢、后续请求快”时,就能先区分固定建连成本与业务处理时间,而不是直接把延迟归咎于服务器代码。