
HTTP 与 Web 标准 / 系统课时
定位 502 503 504
定位 502 503 504
代理链路出现 502、503、504 时,不能只凭状态码猜故障点。有效做法是把状态码、代理错误日志、上游状态和各阶段耗时放在一起,判断失败发生在连接上游、选择可用实例,还是等待上游响应的阶段。
学习目标
- 区分 502、503、504 在代理链路中的核心含义
- 结合代理日志和耗时字段判断故障发生阶段
- 按固定顺序验证上游连接、服务状态和超时配置
先把三个状态码放回代理链路
当客户端经过反向代理、网关或负载均衡器访问后端时,最终状态码可能由代理生成,也可能只是代理把上游返回的状态码原样转发。因此,状态码只能给出调查方向,不能单独证明根因。
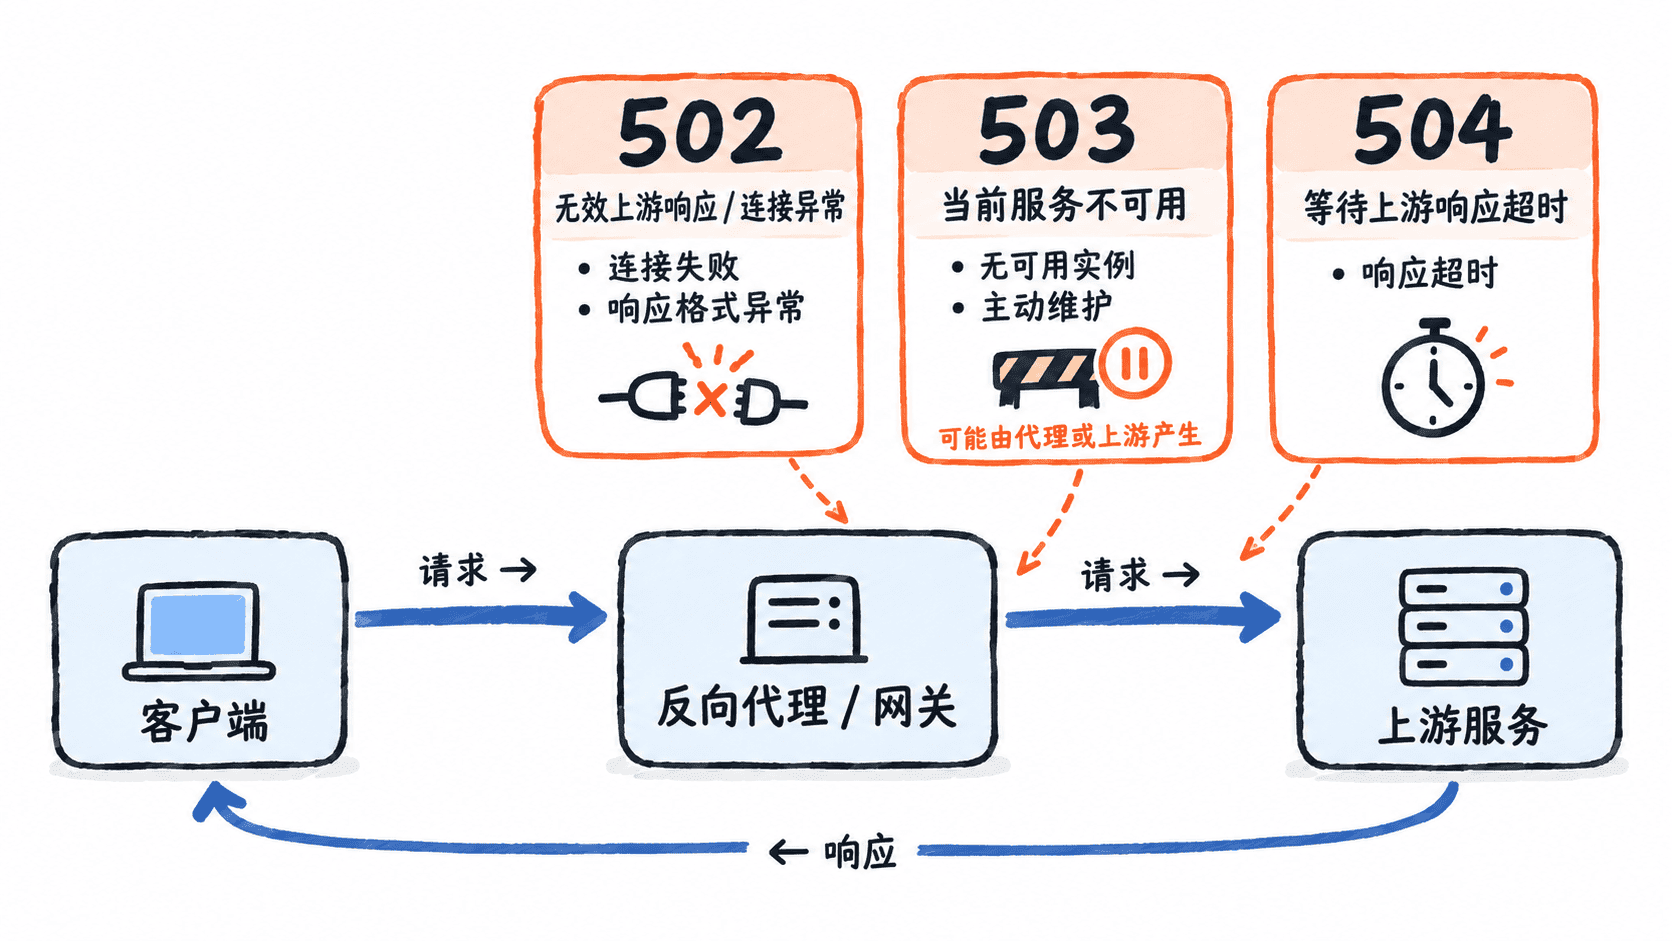
| 状态码 | 协议层面的重点 | 排查时优先寻找的证据 |
|---|---|---|
| 502 Bad Gateway | 代理作为网关时,从上游得到无效响应 | 上游连接被拒绝、连接被重置、响应格式异常、上游提前断开 |
| 503 Service Unavailable | 当前服务暂时无法处理请求 | 维护、过载、健康实例不足,或上游自身明确返回 503 |
| 504 Gateway Timeout | 网关等待上游响应超过允许时间 | 上游连接过慢、首字节过慢、处理时间超过代理超时阈值 |
不同代理产品对具体故障的状态码映射并不完全一致。例如“没有健康上游”可能被不同实现映射为不同 5xx。因此排查时应以实际代理日志为准,而不是把“503 等于无健康节点”之类经验规则当成协议保证。
用状态码和耗时做第一轮判断
先从客户端记录 HTTP 状态码和总耗时。下面的命令请求代理入口,同时输出建立客户端到代理连接所需时间、收到首字节时间和总时间。将占位符替换为实际地址。
curl -sS -o /dev/null -w 'status=%{http_code} connect=%{time_connect}s starttransfer=%{time_starttransfer}s total=%{time_total}s\n' "http://<HOST>:<PORT>/<PATH>"预期输出。以下示例表示代理最终返回 504,实际时间值可能不同。
status=504 connect=<TIME>s starttransfer=<TIME>s total=<TIME>s如果 connect 很短而 total 接近固定阈值,例如每次都接近代理配置的读取超时时间,重点检查代理到上游这一段。不过这里的 time_connect 只测量客户端到代理的连接,并不能代替代理内部的上游连接耗时。
502 如果几乎立即返回,常见方向是上游端口无人监听、连接被拒绝、TLS 或协议不匹配;504 如果总是在接近固定秒数后返回,更像代理的连接或读取计时器触发。503 若快速且稳定出现,应进一步判断它究竟由代理生成,还是上游应用主动返回。
把代理日志里的时间轴对上
代理访问日志最好能够关联请求 ID、最终状态码、上游状态以及连接和响应耗时。以常见反向代理日志字段为例,排查时重点观察这些信息:request_time、upstream_status、upstream_connect_time、upstream_header_time 和 upstream_response_time。
下面是经过简化的三类日志示意,字段名和格式会随代理产品及日志配置变化。
status=502 request_time=0.003 upstream_status=502 upstream_connect_time=0.001 upstream_response_time=0.001
status=503 request_time=0.002 upstream_status=- upstream_connect_time=- upstream_response_time=-
status=504 request_time=30.001 upstream_status=504 upstream_connect_time=0.004 upstream_response_time=30.000
第一行说明故障很快发生,继续查看同一请求对应的错误日志,常会发现连接拒绝、上游提前关闭或响应解析失败等更具体的原因。第二行没有实际访问上游的时间,更应检查代理自身的路由、健康检查、限流或维护策略,但这只是诊断线索,不能仅凭一个横线字段断定原因。
第三行中连接很快完成,但响应耗时接近固定的 30 秒,说明重点已经从“能否连上”转向“上游为什么迟迟没有返回”。此时应检查应用处理时间、数据库或下游依赖,以及代理的读取超时,而不是盲目增加重试次数。
从代理所在位置直接验证上游
排查代理链路时,应尽量在代理主机或代理容器内部直接访问同一个上游目标。这样可以绕过客户端到代理这一段,验证 DNS、网络路由、目标端口和应用响应是否正常。
curl -sS -o /dev/null -w 'upstream_status=%{http_code} total=%{time_total}s\n' "http://<UPSTREAM_HOST>:<UPSTREAM_PORT>/<PATH>"预期输出。修复后上游健康接口应返回预期的成功状态,实际耗时可能不同。
upstream_status=200 total=<TIME>s如果直连上游也失败,应先解决上游监听、网络、安全策略或应用自身问题;如果直连稳定成功而代理仍然失败,则重点检查代理使用的目标地址、协议、连接池、健康检查和超时参数。还要确认测试的是代理实际使用的主机名、端口和协议,避免拿另一个入口的成功结果误判链路已经恢复。
用同一请求完成闭环验证
一次可靠排查通常按这个顺序进行:先记录客户端收到的状态码、耗时和请求 ID,再到代理访问日志与错误日志中定位同一请求,确认是否真正访问了上游以及失败发生在哪个计时阶段;随后从代理所在位置直连同一上游,最后再检查上游应用日志和依赖耗时。
修复后不要只验证“5xx 消失”。还应确认代理日志中的上游状态恢复正常、耗时不再贴近超时阈值,并连续请求多次,避免故障只存在于部分实例。502、503、504 的价值不是直接告诉你答案,而是帮助你把调查范围逐步缩小到连接、可用性或响应等待这三个方向。