
音频开发 / 系统课时
归一化音量并抑制背景噪声
归一化音量并抑制背景噪声
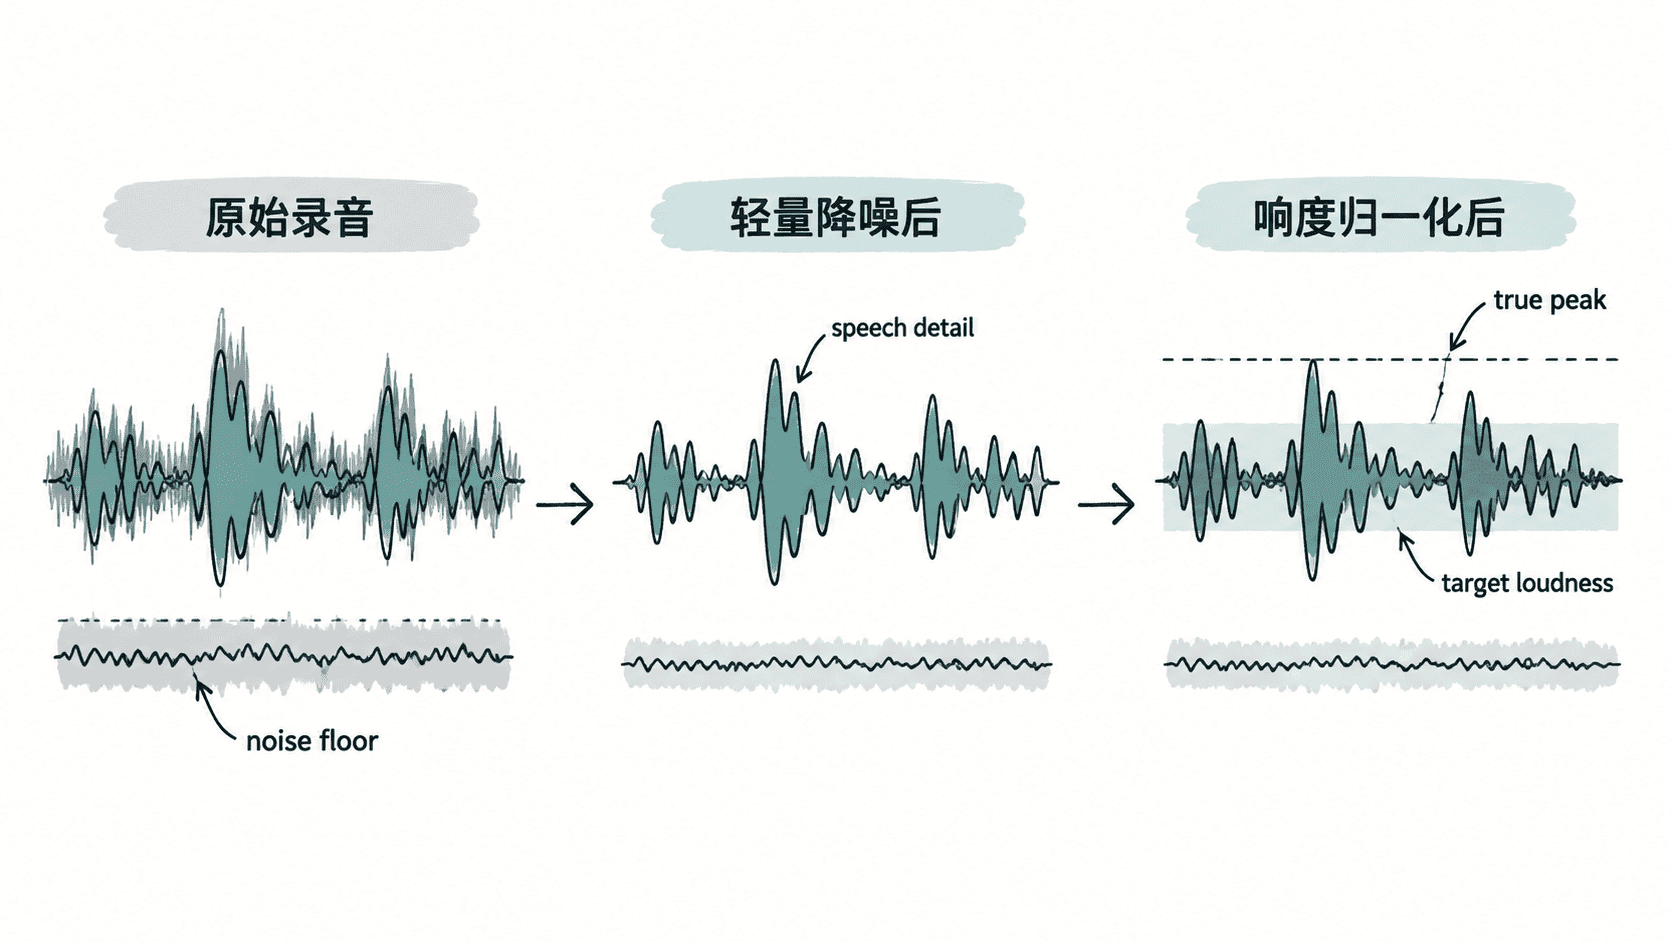
同一批录音如果忽大忽小、底噪明显,ASR 前端会面对不稳定的信噪比。处理目标不是把声音“修得像录音棚”,而是先温和降低持续噪声,再把有效语音拉到稳定响度范围,同时保留辅音、呼吸和瞬态等识别所需特征。
学习目标
- 区分峰值归一化、响度归一化与降噪的职责
- 能用一条可复现的处理链完成轻量降噪与响度归一化
- 能识别过度降噪、削波和噪声被同时放大的风险
先处理噪声,再统一响度
归一化解决的是“整体电平不一致”,它不会自动提高信噪比。若录音中有持续风扇声,直接把整体音量拉高,噪声也会一起变大。因此通常先做温和降噪,再做归一化。
峰值归一化把最高峰对齐到目标电平,计算简单,但不同录音的主观响度仍可能差异很大。响度归一化则以整体感知响度为目标,更适合长录音或批量数据。对语音识别而言,两者都应避免把峰值顶到 0 dBFS 附近,以免后续重采样或滤波造成削波。
用 FFmpeg 建立一条保守处理链
下面示例使用 FFmpeg 的 afftdn 做频域降噪,再用 loudnorm 做响度归一化。参数刻意偏保守:降噪强度 nr=8,噪声底估计 nf=-45,目标响度 -20 LUFS,真峰值限制在 -2 dBTP。
ffmpeg -y -i input.wav -af "afftdn=nr=8:nf=-45,loudnorm=I=-20:TP=-2:LRA=7" -ar 16000 -ac 1 cleaned.wav
ffprobe -v error -show_entries stream=sample_rate,channels -of default=noprint_wrappers=1 cleaned.wav
预期输出中,FFmpeg 会生成 cleaned.wav;ffprobe 的关键结果应为:
sample_rate=16000
channels=1
FFmpeg 自身还会打印版本、编码器、时长和处理速度等日志,这些动态值会因环境和输入文件而不同。真正需要确认的是输出文件存在、采样率为 16 kHz、声道数为 1,并且试听时语音主体没有明显金属音或吞字。
为什么降噪不能开得越强越好
语音中的擦音、送气音和词尾衰减本来就接近噪声。降噪过强时,这些低能量细节最先被抹掉,听起来可能“更干净”,但识别模型反而失去区分音素的线索。若出现水声、金属感、断续感,应先降低降噪强度,而不是继续提高归一化增益。
afftdn 更适合相对稳定的背景噪声,例如风扇、空调和电流底噪。面对突发敲击声、旁人说话或音乐,它并不能可靠分离目标语音;这类场景更适合用专门的语音增强模型,或从麦克风阵列、录音环境和 VAD 分段上解决。
用可量化结果做验收
处理后应同时检查电平、噪声和识别结果。电平方面,确认没有峰值削顶;噪声方面,比较静音段的底噪是否下降;识别方面,用同一模型比较处理前后的错误率或至少逐句核对转写。
如果原始录音本身已经干净,只做轻量归一化往往比“降噪加满”更可靠。音频预处理的边界应该由识别结果决定:只消除明显无效的噪声和电平差异,不主动改造模型本来能够识别的语音细节。