
音频开发 / 系统课时
看懂 ASR 与 TTS 数据链路
看懂 ASR 与 TTS 数据链路
实时语音应用的核心不是“把模型接上就结束”,而是把声音、文本和播放结果在多个阶段之间正确转换。本节用一条完整链路说明 ASR 与 TTS 各自吃什么、吐什么,以及离线、在线、流式调用分别把哪些责任留给应用层。
学习目标
- 说清 ASR 与 TTS 输入输出的数据形态,以及音频在链路中的变化。
- 区分离线、在线、流式三类调用方式,并判断各自适合的场景。
- 明确应用层在采集、切片、缓冲、状态管理和播放上的职责。
一条语音应用链路里发生了什么
ASR(Automatic Speech Recognition)负责“声音转文字”,TTS(Text To Speech)负责“文字转声音”。把两者串起来,就得到常见的语音交互闭环:用户说话,应用采集音频并送入 ASR,得到文本后交给业务逻辑,再把回复文本送入 TTS,最后播放合成音频。
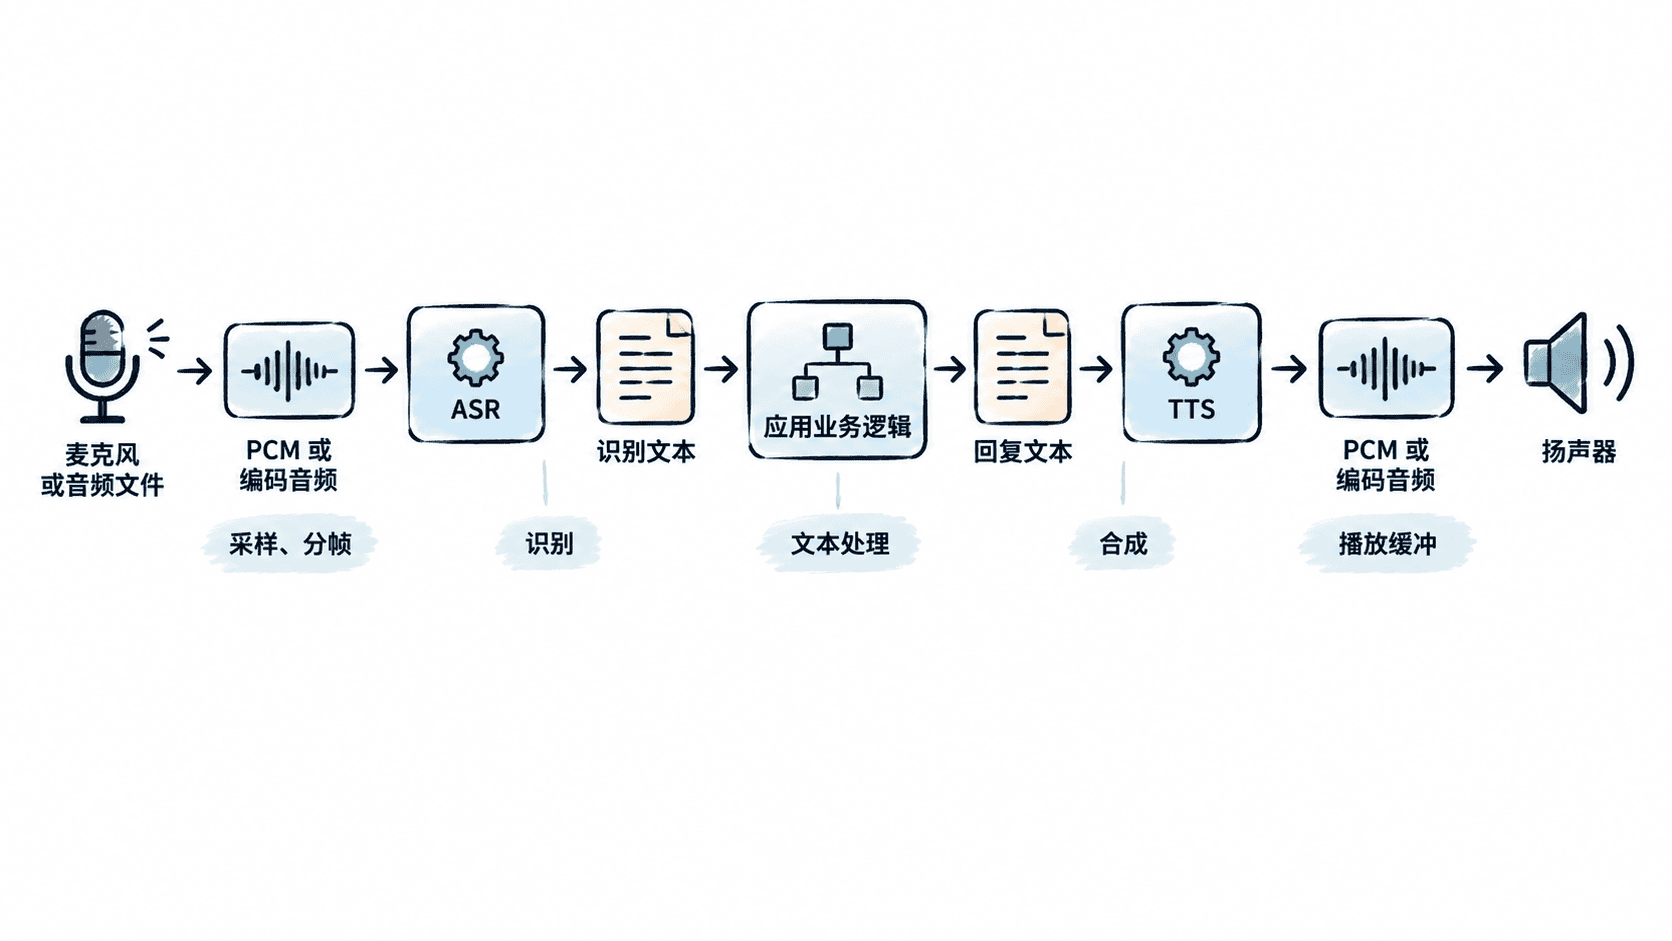
麦克风最初产生连续声学信号,数字化后通常以 PCM 样本存在。应用可以直接把 PCM 帧送给流式 ASR,也可以先编码成 WAV、FLAC、Opus 等格式再提交。ASR 的主要输出是文本,但流式场景经常同时产生不断修正的中间结果和最终结果。
TTS 的方向正好相反。应用提供文本、语言、发音人、语速等参数,服务返回一段音频数据。返回值可以是完整文件,也可以是一块块音频帧;应用需要根据返回方式决定等待全部完成后播放,还是边接收边播放。
离线、在线与流式不是一回事
“离线”强调推理发生在本机或内网,不依赖远端服务;“在线”表示请求交给远端服务处理;“流式”则描述数据是否分块发送、结果是否增量返回。在线和流式可以同时存在,因此不能把“在线”与“流式”当成互斥选项。
| 方式 | 典型输入 | 结果返回 | 主要优点 | 主要代价 |
|---|---|---|---|---|
| 离线 | 本地音频或实时帧 | 本机直接得到结果 | 隐私好、弱网可用 | 模型体积和算力压力在设备侧 |
| 在线非流式 | 完整音频文件或整段文本 | 请求完成后一次返回 | 接口简单、实现成本低 | 首次结果等待时间较长 |
| 在线流式 | 连续音频帧或文本片段 | 增量返回识别或音频 | 交互延迟低 | 状态、缓冲和异常处理更复杂 |
应用层真正要负责什么
模型只负责识别或合成,应用仍要管理模型之外的工程问题。ASR 前要处理麦克风权限、采样率、声道、静音检测和分帧;识别过程中要维护会话状态、超时与重连;拿到文本后还要区分中间结果和最终结果,避免界面反复覆盖或业务重复提交。
TTS 侧同样需要管理文本切分、请求并发、音频缓冲和播放队列。若边合成边播放,还要避免音频生产速度低于播放速度造成卡顿;若用户中途打断,则要同时终止未完成的 TTS 请求和本地播放,不能只让扬声器暂时静音。
什么时候选择哪种调用方式
录音转写、会议纪要、上传音频转文本这类任务通常不要求立即反馈,优先选择非流式方式,链路更简单。语音助手、实时字幕、同声传译更看重首字延迟,通常要使用流式 ASR;如果回复也要求自然衔接,再配合流式 TTS。
离线方案适合隐私、断网可用性或持续调用成本敏感的场景,但要承担模型部署和性能优化。在线方案适合快速接入和模型能力优先的产品;真正决定工程复杂度的,往往不是“云端还是本地”,而是音频和结果是否需要持续流动。
理解这条链路后,可以把实时语音应用看成两个方向相反的数据管道:ASR 把音频逐步收敛成文本,TTS 再把文本展开成可播放音频,而应用层负责把采集、网络、状态和播放可靠地连接起来。