
音频开发 / 系统课时
接入大模型生成语义回复
接入大模型生成语义回复
这一节把 ASR 的识别文本接到大语言模型,并把模型输出整理成适合 TTS 直接朗读的短回复。重点不在“能调通接口”,而在于控制回复长度、语气和格式,让整条语音链路既自然又低延迟。
学习目标
- 将 ASR 文本组织成适合语音对话的大模型请求
- 用提示词约束回复长度、口语化程度和信息密度
- 在进入 TTS 前清理 Markdown、链接等不适合朗读的格式
语音对话中的大模型位置
语音应用里的大模型位于 ASR 与 TTS 之间:ASR 负责把声音转成文本,大模型负责理解语义并生成回复,TTS 再把清理后的文本变回声音。这里的关键不是追求长答案,而是尽快生成“可直接说出口”的内容。
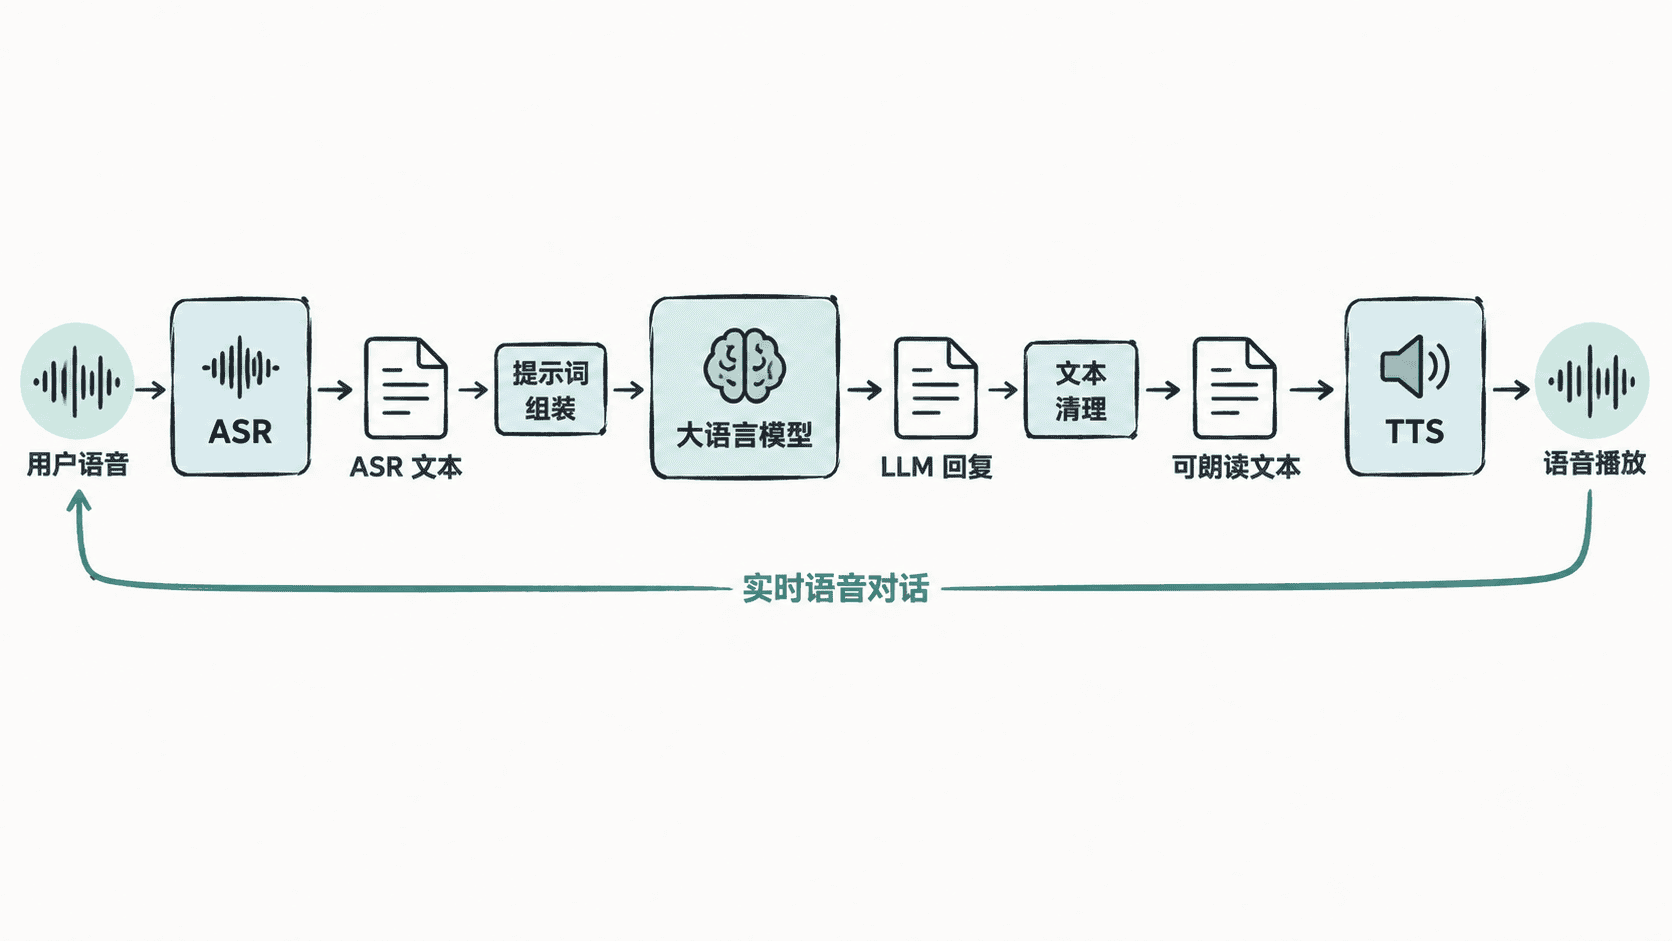
语音场景与普通聊天最大的差别是用户正在等待声音返回。回复越长,生成首句和完整播报的时间越久。因此提示词要明确要求简短、口语化、不要输出表格和复杂 Markdown,并让模型优先给结论。
设计适合朗读的提示词
系统提示可以直接约束回答形态。下面是片段示例,假设你的服务端已经能够把 system 与 user 消息传给所使用的大模型接口。
SYSTEM_PROMPT = (
    '你是实时语音助手。'
    '请优先直接回答问题,通常控制在 2 到 4 句。'
    '使用自然口语,不输出 Markdown 表格、代码围栏、标题或链接。'
    '除非用户明确要求,否则不要长篇解释。'
)

def build_messages(asr_text: str) -> list[dict[str, str]]:
    return [
        {'role': 'system', 'content': SYSTEM_PROMPT},
        {'role': 'user', 'content': asr_text.strip()},
    ]
这段代码不负责网络请求,只负责生成稳定的模型输入。验证时可以打印 build_messages('为什么天空是蓝色的?'),确认系统约束和 ASR 文本都进入请求消息。
调用模型并限制回复长度
实际接入时,建议在模型参数和提示词两层同时控制长度。下面是片段示例:假设供应商提供兼容 Chat Completions 风格的 HTTP 接口,实际 URL、鉴权头和响应字段请按所用服务调整。
import httpx

async def generate_reply(
    base_url: str,
    api_key: str,
    model: str,
    asr_text: str,
) -> str:
    payload = {
        'model': model,
        'messages': build_messages(asr_text),
        # 语音回复应尽量短,避免生成和播报时间持续拉长。
        'max_tokens': 160,
        'temperature': 0.4,
    }

    async with httpx.AsyncClient(timeout=15.0) as client:
        response = await client.post(
            f'{base_url.rstrip("/")}/v1/chat/completions',
            headers={'Authorization': f'Bearer {api_key}'},
            json=payload,
        )
        response.raise_for_status()
        data = response.json()

    return data['choices'][0]['message']['content'].strip()
这是依赖具体模型服务的片段示例,不能脱离真实 base_url、密钥和供应商响应格式独立运行。接入后应验证三点:HTTP 请求成功、回复没有明显超长、用户说完后能在可接受时间内拿到首段文本。
进入 TTS 前清理文本
即使提示词禁止 Markdown,模型仍可能偶尔返回标题、加粗、链接或列表符号。TTS 如果直接朗读这些符号,用户会听到“星号”“井号”或冗长 URL,因此要在合成前做一次轻量清理。
import re

def clean_for_tts(text: str) -> str:
    text = re.sub(r'`[\s\S]*?``', '这里有一段代码,已省略。', text)
    text = re.sub(r'\[([^\]]+)\]\((https?://[^)]+)\)', r'\1', text)
    text = re.sub(r'[*_#>`~-]+', '', text)
    text = re.sub(r'\s+', ' ', text)
    return text.strip()

if __name__ == '__main__':
    raw = '## 建议\n你可以先看 **官方文档**:https://example.com'
    print(clean_for_tts(raw))
``

预期输出

`text
建议 你可以先看 官方文档:https://example.com
这个清理器故意保持轻量:它处理最常见的 Markdown 标记,但不试图理解所有自然语言。若产品不希望朗读 URL,还可以在进入 TTS 前把完整网址替换成“相关链接已发送到屏幕”。
控制延迟与答案质量
实时语音里,模型回复的目标不是一次性说完所有知识,而是尽快生成下一句有用的话。可以优先使用流式输出,在拿到一个完整短句后就交给 TTS 分段合成,而不是等待整段文本生成完毕。
同时要限制上下文规模。只保留与当前会话有关的最近若干轮,或先做摘要再送入模型,可以减少首 token 延迟和无关信息干扰。最终进入 TTS 的文本应满足三个条件:语义完整、长度可控、读出来像人话;这比保留模型原始格式更重要。