
音频开发 / 系统课时
用任务队列隔离耗时语音请求
用任务队列隔离耗时语音请求
这一节把批量转写和长文本合成从同步 HTTP 请求中拆出去:Web 层只负责创建任务和查询状态,Worker 独立执行推理,并通过超时、重试与幂等控制失败边界,避免慢任务拖垮在线接口。
学习目标
- 设计适合语音任务的异步状态与查询接口
- 理解队列、Worker、结果存储之间的职责边界
- 为超时、重试和重复提交设置可验证的保护规则
先把慢任务移出请求线程
长音频转写或长文本 TTS 可能持续几十秒甚至数分钟。如果 HTTP 连接一直占着线程、连接池和网关超时预算,少量慢请求就可能把在线服务拖住。异步化后,请求只做参数校验、幂等判断和入队,然后立即返回 taskId。
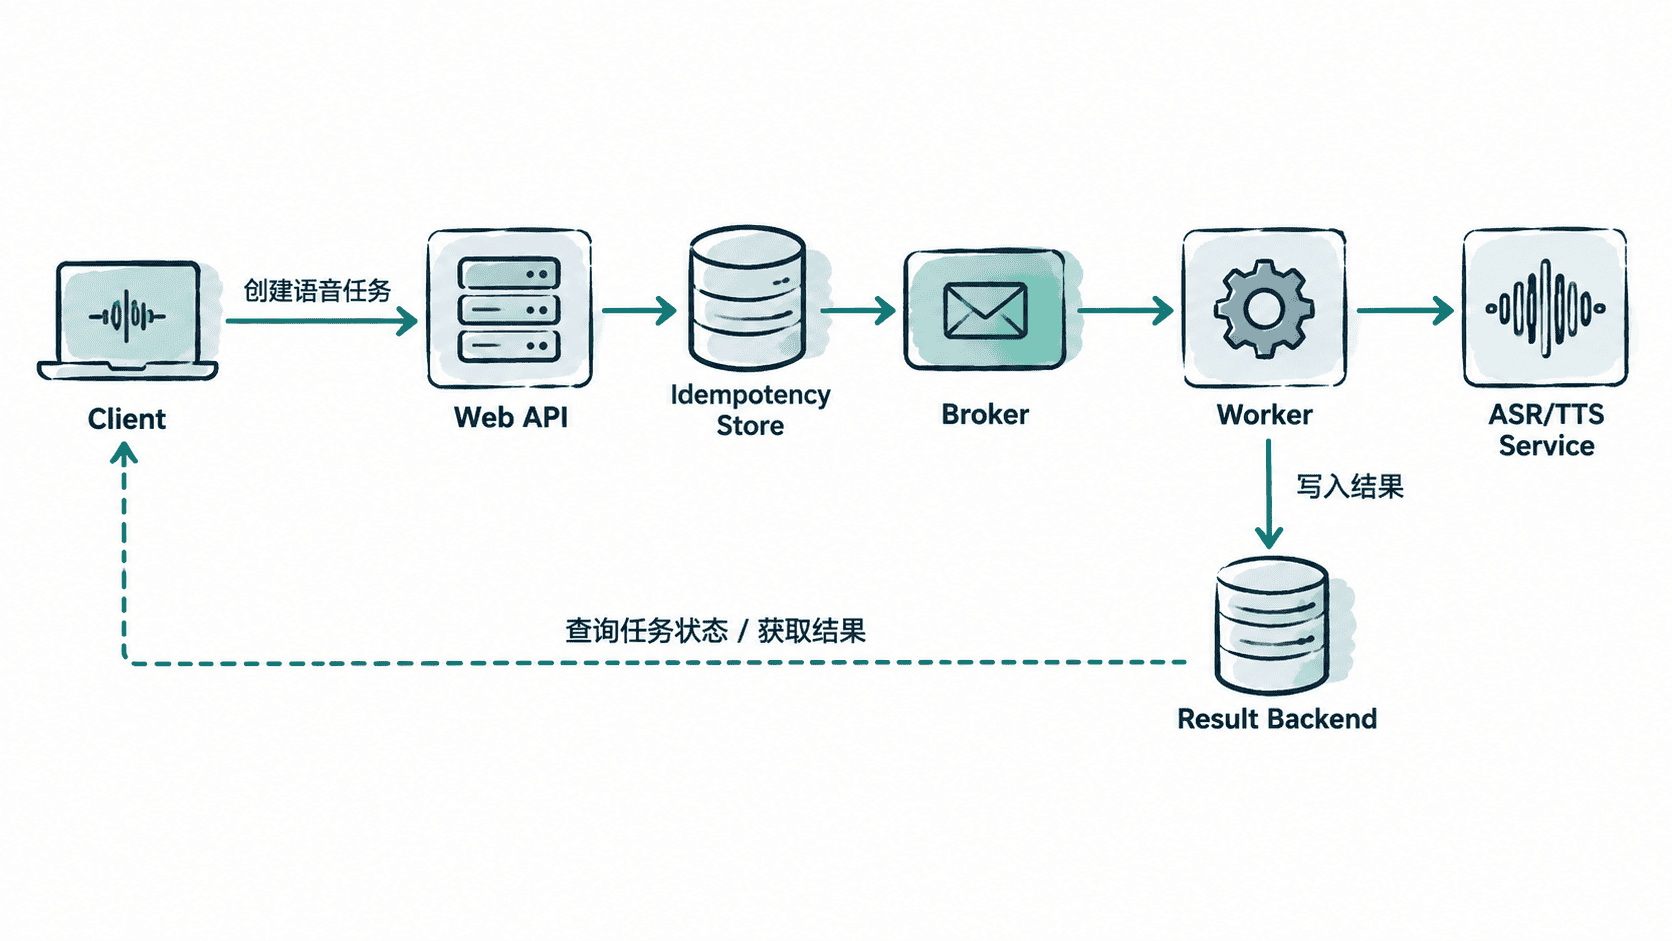
推荐的主链路是“API 创建任务 → Broker 排队 → Worker 取任务 → 调用语音服务 → 结果存储 → API 查询结果”。Web 服务不直接等待模型完成,Worker 也不负责面向终端用户保持长连接。
用状态机约束重试与终态
任务状态不能只用“处理中/完成”两个值,否则超时、重试和永久失败会混在一起。至少需要 QUEUED、RUNNING、RETRYING、SUCCESS、FAILED,并规定只有终态才能被客户端长期缓存。
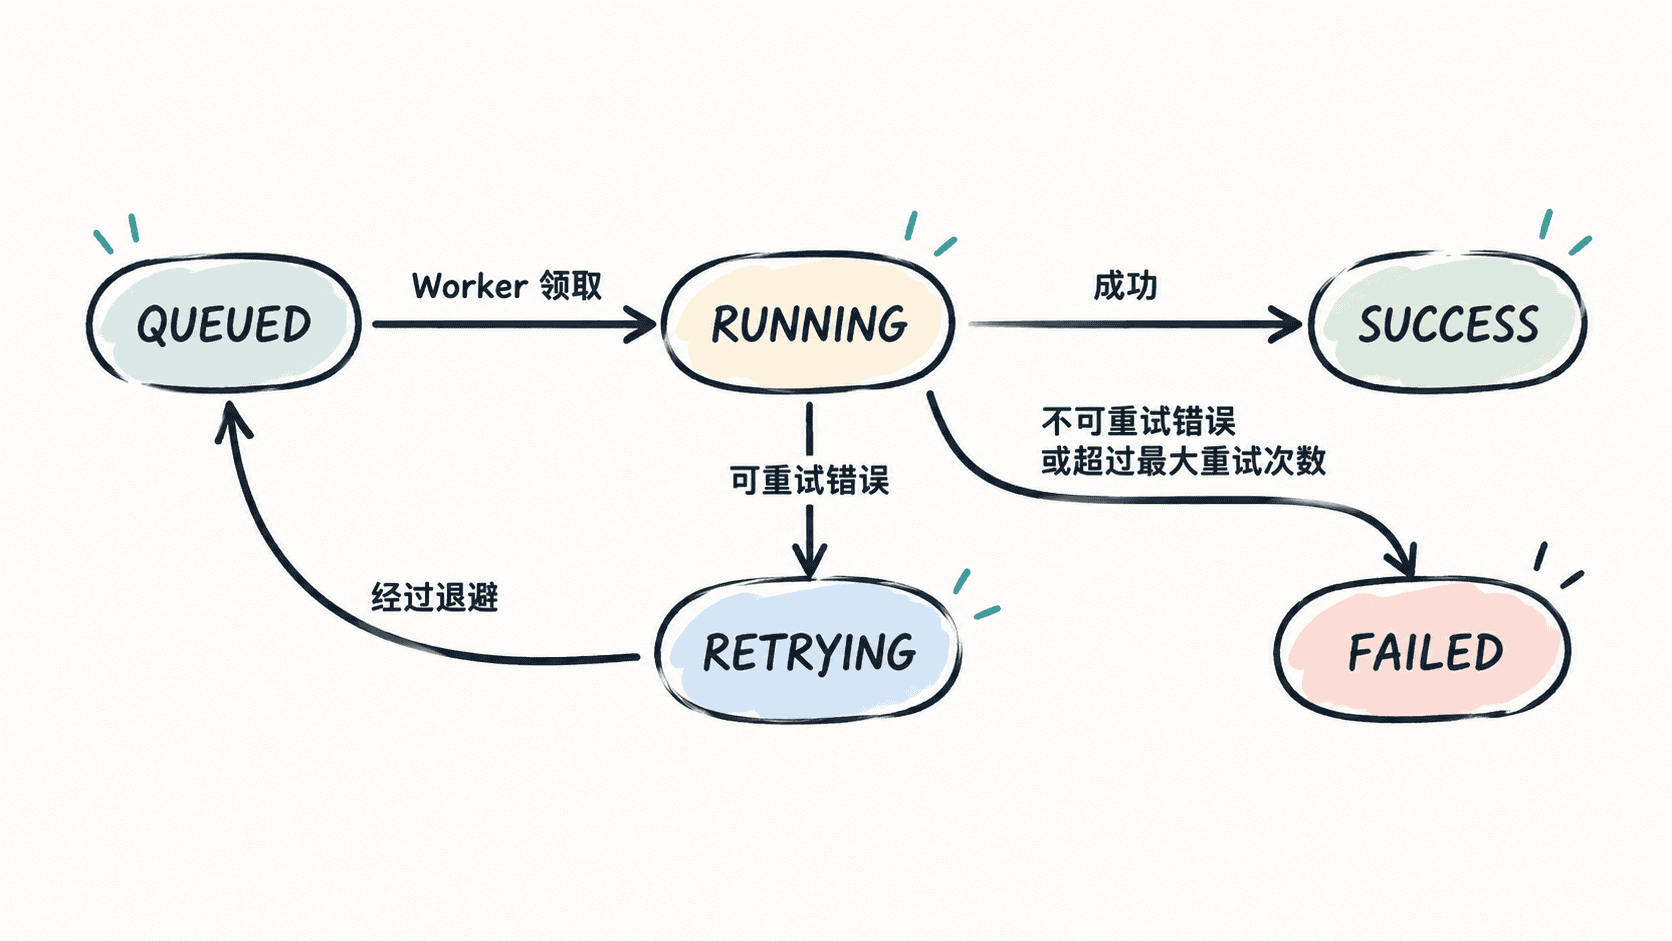
SUCCESS 和 FAILED 应视为终态。RUNNING 超过租约或心跳阈值时不能直接假定失败,需要由 Worker 或调度器判断任务是否失联,再决定重新入队或标记失败。
用 Celery 与 Redis 做最小可运行实现
下面示例使用 Redis 作为 Broker、结果存储和幂等键存储,Celery Worker 执行任务,FastAPI 只创建与查询任务。示例中的 speech_job 用短暂休眠模拟推理,重点是队列边界而不是真实 ASR/TTS 模型。
tasks.py:
import time
from celery import Celery
from celery.exceptions import SoftTimeLimitExceeded
app = Celery(
    "speech",
    broker="redis://localhost:6379/0",
    backend="redis://localhost:6379/1",
)
app.conf.update(task_track_started=True, task_acks_late=True, task_reject_on_worker_lost=True)
@app.task(bind=True, max_retries=3, soft_time_limit=55, time_limit=60)
def speech_job(self, payload: dict):
    try:
        if payload.get("simulate") == "retry":
            raise RuntimeError("temporary upstream error")
        time.sleep(0.2)
        return {"kind": payload["kind"], "output": f"done:{payload['source']}"}
    except SoftTimeLimitExceeded as exc:
        raise self.retry(exc=exc, countdown=5)
    except RuntimeError as exc:
        raise self.retry(exc=exc, countdown=min(2 ** self.request.retries, 30))
预期结果:加载该模块后会注册 speech_job 任务;正常任务进入 SUCCESS,临时故障按退避策略进入重试,超过限制后进入失败终态。该文件本身不打印固定业务输出。
api.py:
import uuid
import redis
from fastapi import FastAPI, Header
from pydantic import BaseModel
from tasks import app as celery_app, speech_job
api = FastAPI()
r = redis.Redis(host="localhost", port=6379, db=2, decode_responses=True)
STATE_MAP = {"PENDING": "QUEUED", "STARTED": "RUNNING", "RETRY": "RETRYING", "SUCCESS": "SUCCESS", "FAILURE": "FAILED"}
class JobRequest(BaseModel):
    kind: str
    source: str
    simulate: str | None = None
def public_state(task_id: str) -> str:
    return STATE_MAP.get(celery_app.AsyncResult(task_id).state, "QUEUED")
@api.post("/speech-jobs")
def create_job(req: JobRequest, idempotency_key: str = Header(alias="Idempotency-Key")):
    redis_key = f"idem:speech:{idempotency_key}"
    task_id = str(uuid.uuid4())
    if not r.set(redis_key, task_id, nx=True, ex=86400):
        existing = r.get(redis_key)
        return {"task_id": existing, "state": public_state(existing)}
    try:
        speech_job.apply_async(args=[req.model_dump()], task_id=task_id, queue="speech")
        return {"task_id": task_id, "state": "QUEUED"}
    except Exception:
        if r.get(redis_key) == task_id:
            r.delete(redis_key)
        raise
@api.get("/speech-jobs/{task_id}")
def get_job(task_id: str):
    result = celery_app.AsyncResult(task_id)
    body = {"task_id": task_id, "state": STATE_MAP.get(result.state, result.state)}
    if result.successful():
        body["result"] = result.result
    if result.failed():
        body["error"] = str(result.result)
    return body
预期结果:API 暴露创建任务与查询任务两个端点;同一个 Idempotency-Key 会复用已有任务 ID,并返回该任务当前状态。实际行为可用下面的 HTTP 请求验证。
运行前需要本机 Redis,并安装 celery、redis、fastapi、uvicorn。分别启动 celery -A tasks worker --loglevel=INFO -Q speech 与 uvicorn api:api 后,可以提交任务:
curl -s -X POST http://127.0.0.1:8000/speech-jobs -H 'Content-Type: application/json' -H 'Idempotency-Key: demo-001' -d '{"kind":"ASR","source":"demo.wav"}'预期结果
{"task_id":"<ID>","state":"QUEUED"}其中 <ID> 是运行时生成的任务 ID。使用同一个 Idempotency-Key 再次提交时,应返回同一个任务 ID,而不是创建第二个语音任务。待 Worker 完成后查询该 ID,状态会变为 SUCCESS,结果中的 output 为 done:demo.wav。
把超时、重试和幂等分别处理
超时解决的是“单次执行多久必须结束”,重试解决的是“临时故障是否值得再试”,幂等解决的是“同一个业务请求被重复提交时是否会重复执行”。三者不能互相替代。
可重试错误应限制在上游超时、临时网络故障、限流等短暂问题,并采用指数退避和最大次数。参数错误、音频格式不支持、文本违规等确定性失败不应重试。对于 TTS 计费、对象存储写入等有副作用的步骤,还要把业务幂等键传递到下游,避免 Worker 重跑时重复扣费或重复落库。
上线前验证故障边界
生产验收至少要覆盖四类场景:正常任务能从 QUEUED 进入 SUCCESS;可重试故障会进入 RETRYING 且不超过最大次数;超时任务最终不会永久卡在 RUNNING;同一幂等键连续提交只产生一个业务任务。
如果业务需要“创建任务记录”和“发送到 Broker”具备更强一致性,应进一步采用事务消息或 Outbox,而不是只依赖 Redis 幂等键。队列的目标不是让失败消失,而是把失败变成可观察、可恢复、不会拖垮在线请求的状态。