
音频开发 / 系统课时
重采样并转换单声道输入
重采样并转换单声道输入
语音模型通常要求固定采样率、单声道和确定的 PCM 格式。本节用 FFmpeg 把常见 WAV 输入统一为 16 kHz、单声道、16 位 PCM,并说明重采样、声道混合和编码转换分别改变了什么,以及质量与计算成本应如何取舍。
学习目标
- 能把输入音频统一转换为模型要求的采样率、声道数和 PCM 编码。
- 能验证转换结果,而不是只根据文件扩展名判断格式。
- 能根据实时性和识别质量要求判断重采样配置是否合理。
一次完成三类格式转换
语音识别前常见的标准化目标是 16 kHz、单声道、PCM S16LE。采样率决定每秒保留多少离散采样点,声道数决定模型接收一条还是多条波形,PCM 编码则决定每个采样点使用什么数值格式存储。
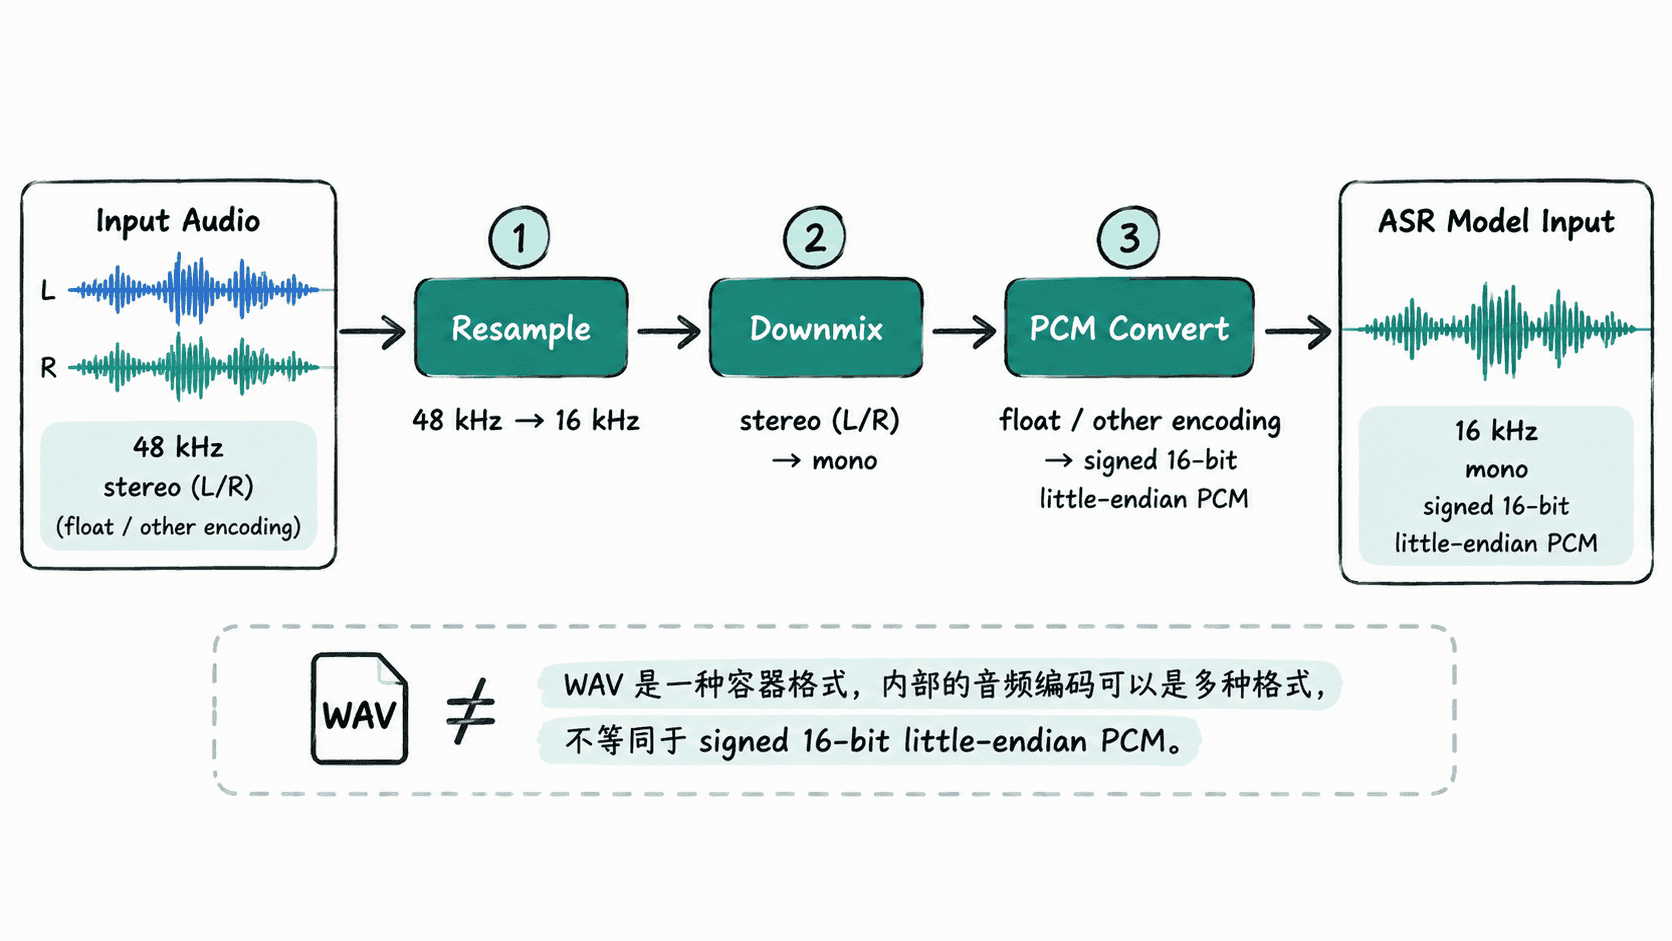
降采样不能理解成简单地“每隔几个采样点取一个”。目标采样率降低后,可表示的最高频率也随之降低,因此高质量重采样会先抑制目标奈奎斯特频率以上的成分,再计算新的采样点,否则高频信号可能折叠到低频区域形成混叠。
立体声转单声道也不等于直接删除一个声道。通常需要把左右声道按混音规则合并,否则只存在于被删除声道中的语音会完全丢失。如果左右声道本来分别记录不同说话人,则不应贸然混成单声道。
用 FFmpeg 统一输入格式
假设当前目录已有 input.wav,下面的命令把它转换为 normalized.wav。-ar 16000 指定目标采样率,-ac 1 指定单声道,-c:a pcm_s16le 指定 16 位小端有符号 PCM。第二条命令用于检查实际输出参数。
ffmpeg -hide_banner -loglevel error -y -i input.wav -ar 16000 -ac 1 -c:a pcm_s16le normalized.wav
ffprobe -v error -select_streams a:0 -show_entries stream=sample_rate,channels,codec_name -of default=noprint_wrappers=1 normalized.wav
预期输出
codec_name=pcm_s16le
sample_rate=16000
channels=1
ffprobe 验证很重要,因为 .wav 只是容器扩展名,内部仍可能是 44.1 kHz、双声道,甚至采用其他编码。模型接口如果要求“16 kHz mono PCM”,应以探测结果为准,而不是只看文件名。
重采样质量与计算成本
重采样器主要在滤波质量、延迟与 CPU 消耗之间取舍。离线批处理可以接受更复杂的滤波计算来换取更好的频率响应;实时语音链路更关心稳定吞吐和低延迟,因此通常没有必要为了极小的理论质量差异使用过重的处理配置。
目标采样率还应尽量与模型训练和接口要求一致。把 8 kHz 电话录音升采样到 16 kHz,只会增加采样点数量,不会恢复原始录音已经没有的高频信息;把 48 kHz 音频降到 16 kHz,则会主动舍弃识别模型通常不使用的高频成分,并减少后续输入数据量。
声道混合与幅度安全
双声道混合为单声道时还要关注幅度。如果两个声道的高幅度信号直接相加,峰值可能超过目标 PCM 能表示的范围并发生削波。常规转换工具会按照混音规则处理,但高动态范围录音或后续还要增加增益时,仍应额外检查峰值与实际听感。
如果左右声道代表两个独立麦克风或不同说话人,保留多通道数据可能比立即混音更有价值。可以先分别识别各声道,再在更高层合并时间轴;只有模型明确要求单声道或业务不需要声道信息时,才进行统一混音。
进入识别模型前至少确认三个条件:采样率与模型要求一致、声道布局符合任务语义、PCM 类型与接口约定一致。这样后续出现识别偏差时,才能优先分析音频内容和模型能力,而不是被输入格式问题干扰。