
音频开发 / 系统课时
纠正专有名词与领域词偏差
纠正专有名词与领域词偏差
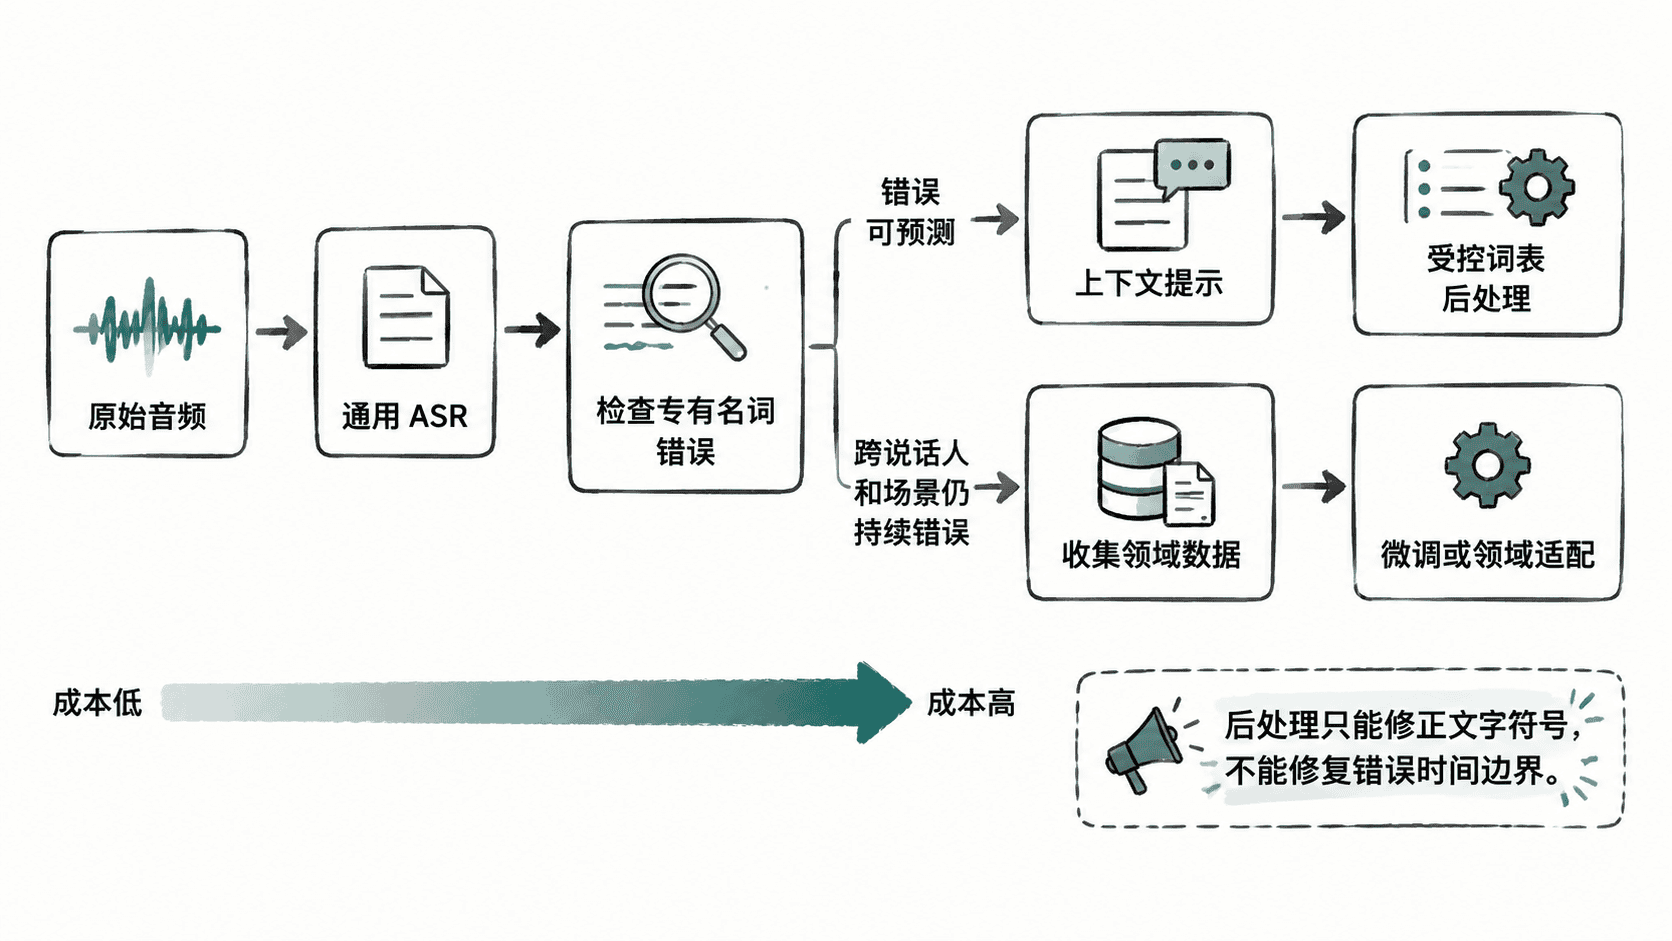
通用语音识别模型最容易在品牌名、产品名、缩写、药名和内部术语上出错。本节把纠错拆成三层:识别前提供上下文,识别后做受控词表纠正,错误仍稳定存在时再评估微调,避免一开始就投入高成本训练。
学习目标
- 判断专有名词错误来自上下文不足还是模型能力不足
- 使用上下文提示与词表后处理降低可预测错误
- 明确何时应停止规则修补并进入模型微调
先区分可预测错误与系统性错误
如果某个专有名词在多数音频里都被识别成同一个近音词,这类错误通常适合用上下文提示或词表后处理;如果不同说话人、不同语速下错误形式完全不稳定,说明模型对该领域发音模式本身掌握不足。
纠错策略应从低成本到高成本逐层升级,而不是把所有错误都交给一个“大词表”。
优先使用上下文提示
很多识别服务支持提示词、上下文文本或热词能力,适合提前告诉模型“本段音频可能出现哪些词”。提示内容应短而相关,例如当前会议的产品名、人员名、项目代号,而不是一次塞入几千个词。
上下文提示的价值是让模型在多个近音候选中提高正确词的概率。它发生在解码阶段,因此通常比事后字符串替换更自然,也更容易保留正确的标点和词边界。
用受控词表做后处理
对于仍然稳定出现的固定错误,可以在识别后增加一层受控纠错。规则必须满足“错误形式明确、目标词唯一、不会误伤普通语句”三个条件。
下面示例将已知近音错误替换为领域词,并只处理完整词条,避免无边界的全局替换。
import re

CORRECTIONS = {
    "安易栈": "Anystack",
    "向量库为": "向量库",
}

def correct_terms(text: str) -> str:
    result = text
    for wrong, right in CORRECTIONS.items():
        # 对中文固定短语做受控替换;规则数量应保持小而明确。
        result = re.sub(re.escape(wrong), right, result)
    return result

sample = "今天演示安易栈的语音检索,并检查向量库为连接。"
print(correct_terms(sample))
预期输出
今天演示Anystack的语音检索,并检查向量库连接。这类后处理适合修正文字符号,但它不能恢复被模型错误切分的词级时间边界。如果字幕需要逐词高亮,替换后的文本长度与原词序列变化较大时,应重新检查时间戳映射,而不是直接沿用旧索引。
给纠错规则加保护条件
不要把“相似就替换”写成模糊规则。例如把所有“苹果”替换成某个产品名,会破坏正常语义。更稳妥的做法是结合上下文判断,例如只在技术会议、产品词附近或特定客户词表生效。
生产环境还应记录纠错前文本、纠错后文本、命中的规则和人工回退结果。这样才能判断某条规则是在提升准确率,还是制造新的误报。
什么时候需要微调
当错误跨说话人、口音和录音条件持续出现,而且单靠提示词与少量规则无法稳定修复时,再考虑微调或领域适配。典型信号包括:领域词数量很多、同一词存在多种错误形式、词边界经常错误,以及后处理规则开始相互冲突。
微调前先收集真实领域音频与高质量标注,并保留一套独立验证集。目标不是让模型“记住词表”,而是让它学会该领域真实的发音、上下文和术语组合。
最稳妥的路径是先做上下文提示,再做少量可解释的后处理,最后才进入微调。这样可以用最低成本解决大多数专有名词问题,同时保留足够清晰的误差来源和回退空间。