
音频开发 / 系统课时
配置语言与解码搜索参数
配置语言与解码搜索参数
本节用同一段音频比较不同 Whisper 解码配置,重点观察语言提示、温度和 beam search 如何改变候选文本的选择。最终你会得到一套可操作的参数选择方法,而不是靠反复试值碰运气。
学习目标
- 能正确设置
language、temperature、beam_size与best_of - 能解释确定性 beam search 与随机采样的差异
- 能用同一音频做可复现的参数对比并选择合适配置
参数怎样进入解码过程
language 决定或提示解码使用的语言上下文;temperature 控制采样随机性;beam_size 在低温确定性解码时同时保留多个候选路径。它们不是彼此独立的“精度旋钮”,而是共同影响候选文本怎样被搜索和筛选。
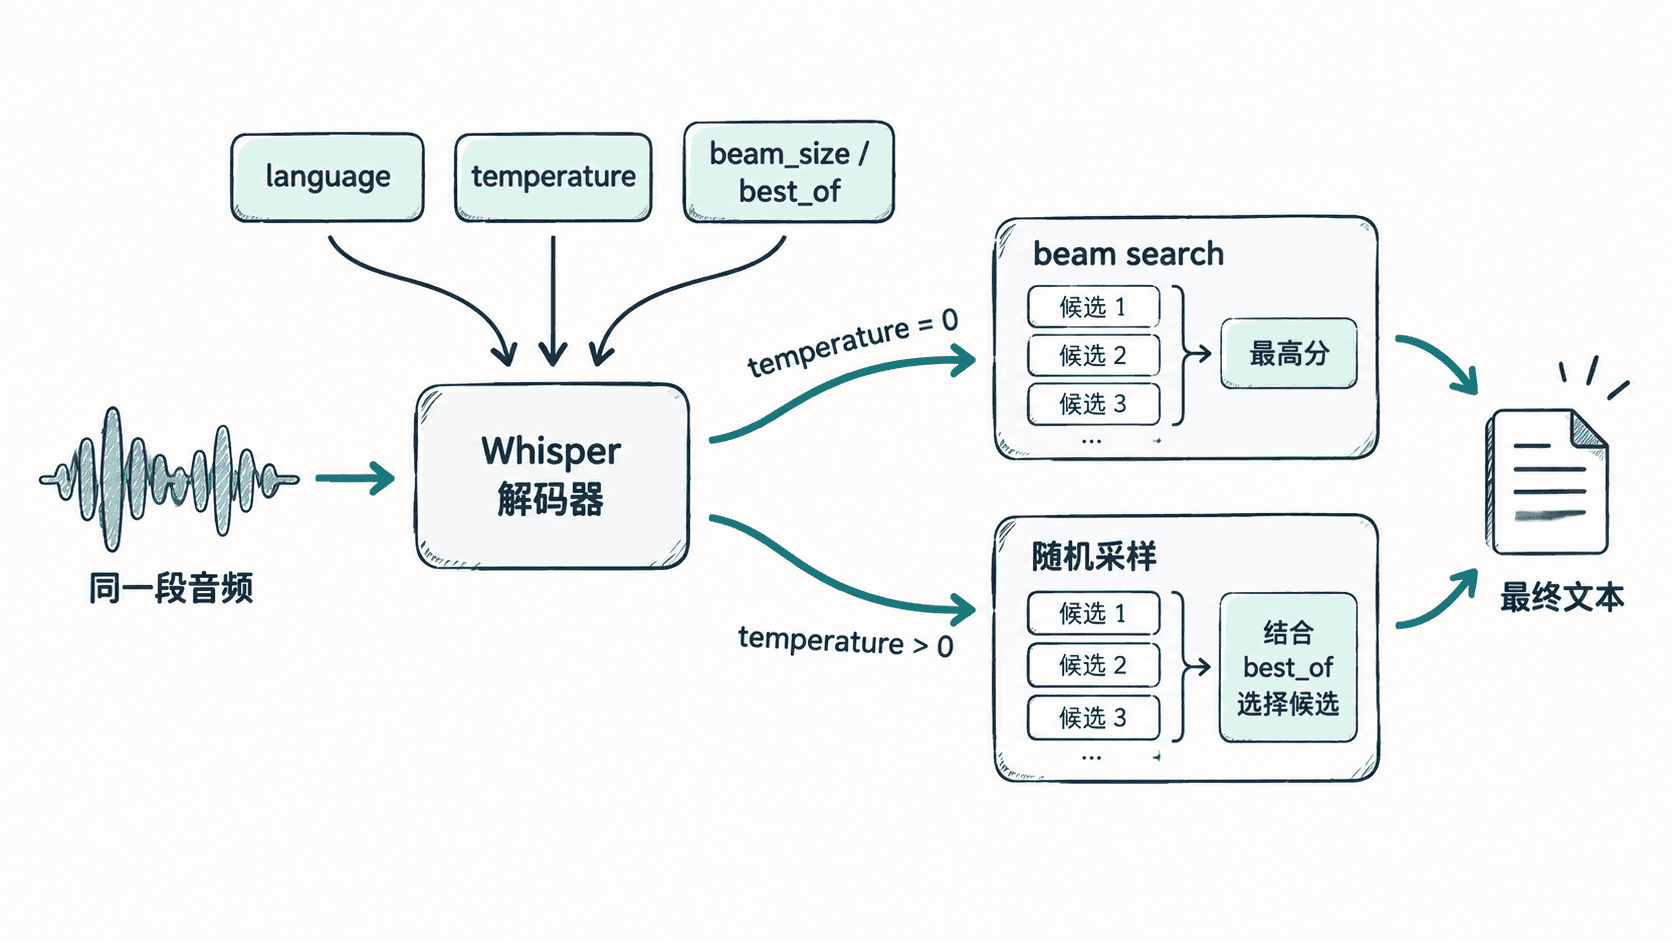
对于已知语言的批量音频,显式设置 language="zh" 可以省去语言检测并减少误判。若音频语言未知,再让模型自动检测更合适。temperature=0 时输出更稳定,适合作为批量转写的默认起点;需要从不确定片段中探索其他候选时,才考虑提高温度。
对比 beam search 与采样
下面脚本对同一音频执行两次转写:第一组使用固定语言和 beam search,第二组使用非零温度与 best_of 采样。两组配置刻意分开,避免把只适用于不同解码模式的参数混在一起。
import argparse
import whisper

def transcribe_once(model, audio, **options):
    result = model.transcribe(audio, verbose=False, **options)
    return result["text"].strip()

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("audio")
    args = parser.parse_args()

    model = whisper.load_model("base")

    beam_text = transcribe_once(
        model,
        args.audio,
        language="zh",
        temperature=0.0,
        beam_size=5,
    )

    sample_text = transcribe_once(
        model,
        args.audio,
        language="zh",
        temperature=0.4,
        best_of=5,
    )

    print("[beam]")
    print(beam_text)
    print("[sample]")
    print(sample_text)

if __name__ == "__main__":
    main()
预期输出:
[beam]
<TRANSCRIPT_A>
[sample]
<TRANSCRIPT_B>
<TRANSCRIPT_A> 与 <TRANSCRIPT_B> 由实际音频决定,二者可能完全相同,也可能只在专有名词、标点或含混词上不同。对比的关键是保持音频和模型不变,只改变解码参数。
建立参数选择依据
已知语言时优先显式指定 language。这对语言单一的批处理任务尤其重要,因为它既减少检测开销,也能避免短音频被误判成相近语言。多语言混合文件则不要强制错误语言,否则模型可能把原本可识别的外语片段“硬转成”目标语言附近的文本。
beam_size 适合希望结果稳定、可复现的任务。较大的 beam 会保留更多候选,但搜索成本也会增加,收益通常不是线性的。可从 5 这类中等值开始,再用真实测试集判断是否值得继续增大。
非零 temperature 会增加采样随机性,更适合模型对某些片段明显犹豫时尝试其他候选。best_of 用于采样模式,从多次候选中选择较优结果。若目标是稳定的批量识别,不应一开始就把温度调高。
用真实样本验证配置
参数优劣必须落到同一测试集上比较。至少准备清晰语音、噪声音频、专有名词和较长句子四类样本,记录识别文本、耗时与失败案例。若业务有人工标注,可进一步统计字错率或词错率;没有标注时,也应人工核对关键字段是否被稳定识别。
批量任务的默认策略通常是:语言已知就显式指定,温度从 0 开始,beam 取中等值;只有在特定样本出现稳定误识别时,再针对性尝试采样或更大的搜索范围。这样参数调整才是可验证的工程过程,而不是随机试参。