
音频开发 / 系统课时
压测并发吞吐与尾延迟
压测并发吞吐与尾延迟
生产环境的语音服务不能只看“平均延迟”。本节用短语音、长音频和流式会话三类负载建立压测基线,同时观察吞吐、首结果时间、P95/P99 与排队时间,最终判断瓶颈究竟出现在入口、队列还是模型推理阶段。
学习目标
- 能为短语音、长音频和流式会话分别设计可复现的压测场景
- 能正确读取吞吐、首结果时间、P95/P99、实时率等关键指标
- 能根据并发升高后的指标变化区分排队瓶颈与推理瓶颈
先把压测场景拆开
三类请求不要混在一个平均值里。短语音更敏感于固定开销,长音频更容易暴露推理吞吐不足,流式会话则重点观察“首个可用结果”以及持续处理是否跟得上音频输入速度。
| 场景 | 建议样本 | 主要指标 | 常见瓶颈 |
|---|---|---|---|
| 短语音 | 2~10 秒 | QPS、P95/P99、排队时间 | 网关、连接池、调度 |
| 长音频 | 1~10 分钟 | 实时率、总耗时、GPU 利用率 | 解码、模型推理、显存 |
| 流式会话 | 连续 30~120 秒 | 首结果时间、增量结果间隔、断流率 | 会话数、队列、流式解码 |
实时率可用 表示。RTF 小于 1 说明单个任务处理速度快于音频播放速度,但这并不代表高并发下仍然不会排队。
用固定协议跑一轮基准
下面示例假设服务提供同步接口 POST /v1/asr,上传字段名为 audio。脚本分别压短音频与长音频,并通过环境变量控制地址和并发,便于在不同机器上复用。流式接口通常使用 WebSocket 或 gRPC,应沿用同一批音频样本,并单独记录建连时间和首结果时间。
import os
import time
import statistics
from concurrent.futures import ThreadPoolExecutor, as_completed

import requests

BASE_URL = os.getenv("ASR_BASE_URL", "http://127.0.0.1:8000")
AUDIO_FILE = os.getenv("AUDIO_FILE", "short.wav")
CONCURRENCY = int(os.getenv("CONCURRENCY", "8"))
REQUESTS = int(os.getenv("REQUESTS", "40"))

def call_asr(index: int) -> float:
    started = time.perf_counter()
    with open(AUDIO_FILE, "rb") as audio:
        response = requests.post(
            f"{BASE_URL}/v1/asr",
            files={"audio": audio},
            timeout=120,
        )
    response.raise_for_status()
    elapsed_ms = (time.perf_counter() - started) * 1000
    return elapsed_ms

with ThreadPoolExecutor(max_workers=CONCURRENCY) as pool:
    futures = [pool.submit(call_asr, i) for i in range(REQUESTS)]
    latencies = [future.result() for future in as_completed(futures)]

latencies.sort()
p95 = latencies[int(len(latencies) * 0.95) - 1]
p99 = latencies[int(len(latencies) * 0.99) - 1]

print(f"requests={len(latencies)}")
print(f"avg_ms={statistics.mean(latencies):.1f}")
print(f"p95_ms={p95:.1f}")
print(f"p99_ms={p99:.1f}")
预期输出的数值取决于模型、音频长度和硬件,结构应类似:
requests=40
avg_ms=<VALUE>
p95_ms=<VALUE>
p99_ms=<VALUE>
实际压测时先用 1 个并发建立基线,再逐级增加到 2、4、8、16 等档位。每个档位至少持续到指标稳定,避免只测几十秒就把模型预热、缓存或 GPU 初始化时间误判为长期性能。
同时记录排队与推理时间
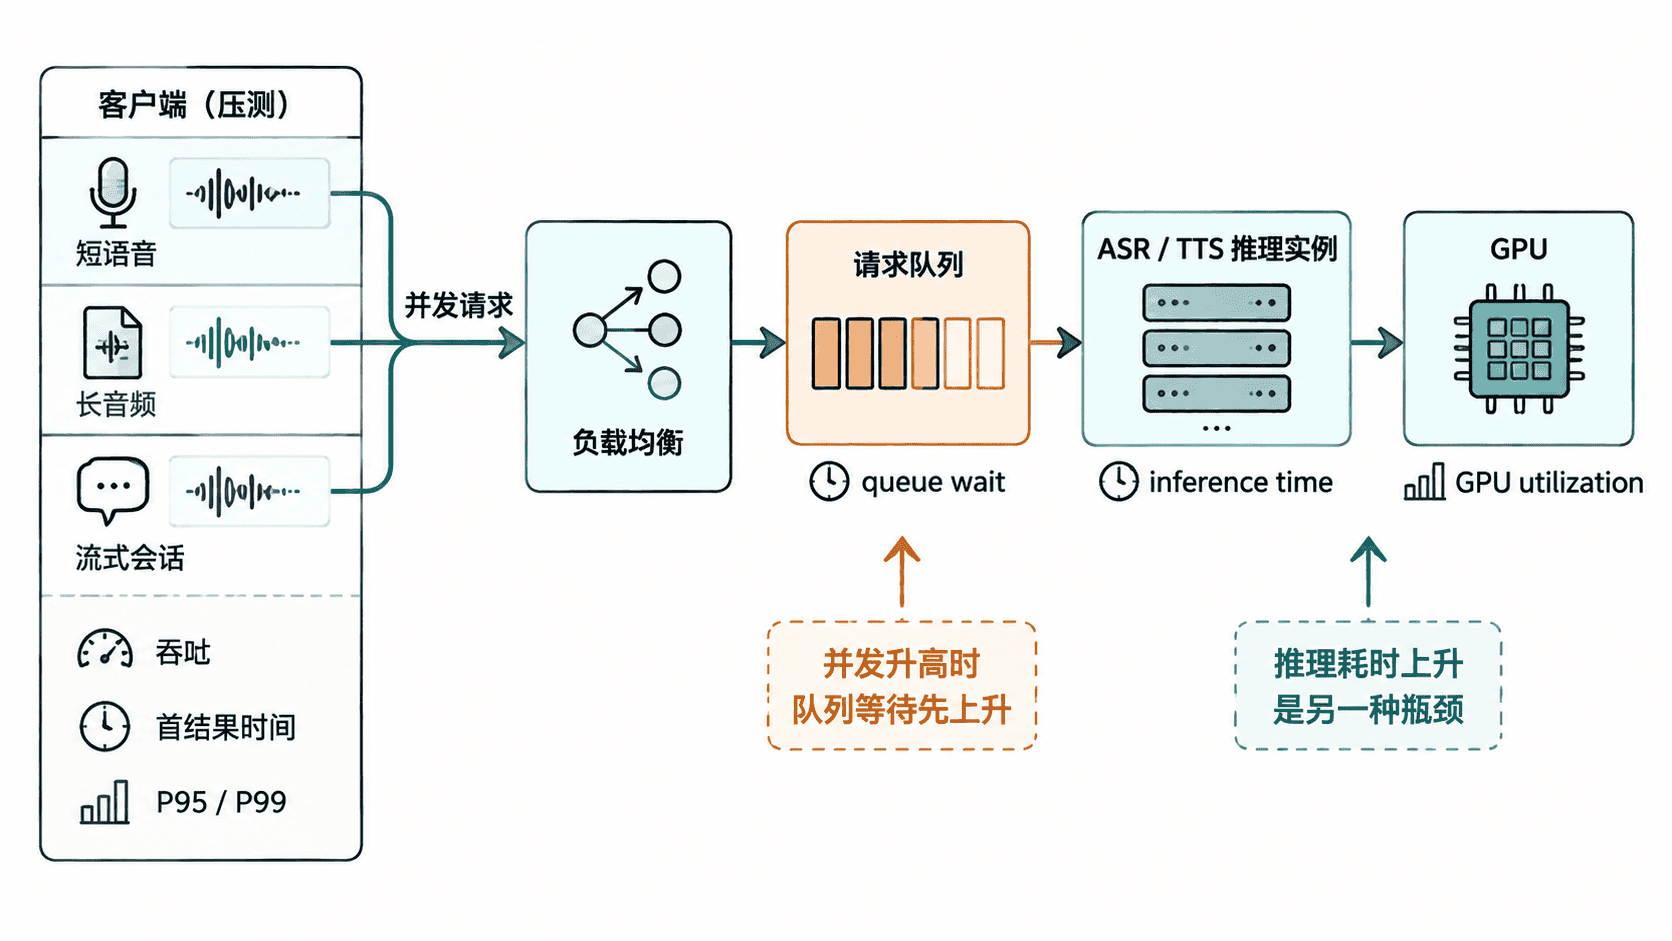
只有端到端延迟时,很难知道请求到底慢在哪里。服务端最好拆出 queue_wait_ms、inference_ms 和 total_ms 三段时间,并使用同一个请求标识关联日志。
当并发提高后,如果 queue_wait_ms 快速增长而 inference_ms 基本稳定,说明单个模型实例还能正常推理,但任务正在入口或批处理队列中等待。此时优先考虑增加实例、调整批大小、限制最大并发或引入背压。
如果 inference_ms 本身明显上涨,同时 GPU 利用率长期接近饱和、显存频繁触顶或发生 OOM,则问题更可能位于推理侧。盲目继续放大入口并发只会进一步恶化 P99。
找到拐点而不是追求最高 QPS
最终目标不是得到一个“机器最高 QPS”,而是找出满足服务等级目标时的最大稳定并发。例如要求 P95 小于 800 ms、P99 小于 1500 ms、错误率低于 0.1%,那么一旦某个并发档位持续越线,前一个稳定档位才更接近可用容量。
流式场景还要增加首结果时间和会话存活率。即使总吞吐看起来足够,只要首结果从 300 ms 恶化到数秒,实时语音体验就已经失效。生产容量应以最先违反 SLO 的指标为准,而不是以某个单项峰值为准。