
音频开发 / 系统课时
读取音频并检查编码参数
读取音频并检查编码参数
这一课把“拿到一个音频文件”变成“拿到经过校验、可以送入模型的音频输入”。你会读取 WAV、MP3 的时长、采样率、声道和编码信息,并在进入识别流程前拦截损坏文件和不符合约束的输入。
学习目标
- 能读取常见音频文件的容器、编码、时长、采样率和声道数
- 能把模型输入要求写成明确的白名单校验规则
- 能区分格式不支持、文件损坏和参数不合格三类失败
先定义什么叫可接受输入
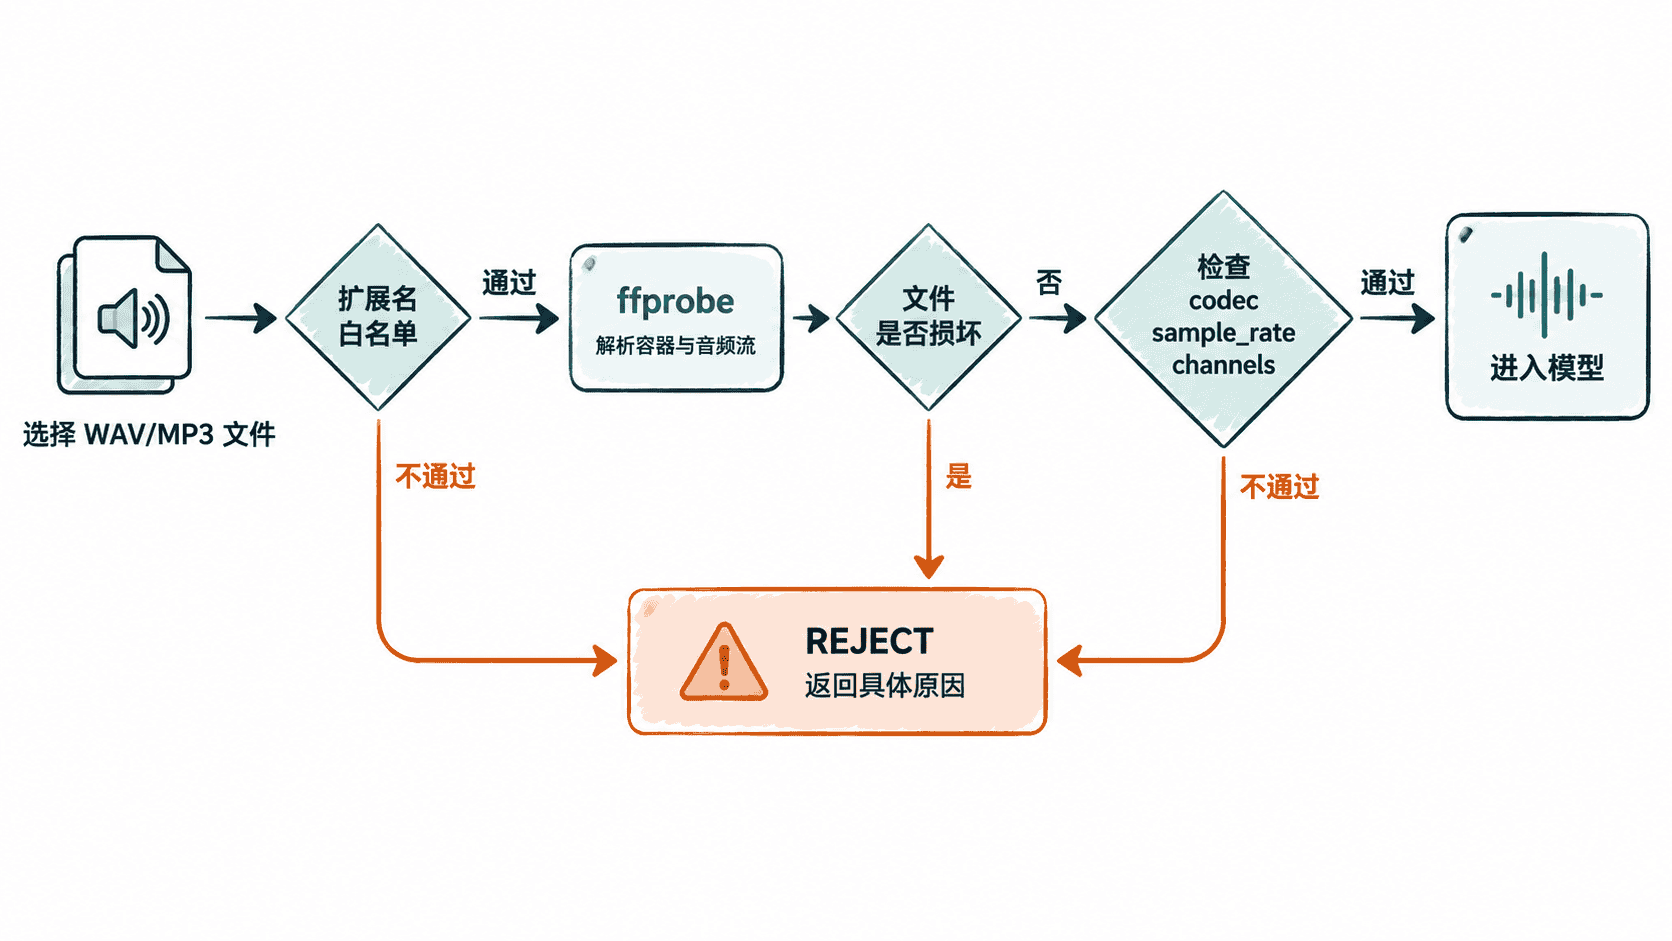
文件“能播放”不等于“适合模型”。语音识别通常会对容器、音频编码、采样率和声道数有自己的约束,因此入口校验应该以下游模型要求为准,而不是只看 .wav 或 .mp3 扩展名。
本课先定义一组教学用白名单:只接收 WAV、MP3;编码允许常见 PCM 与 MP3;采样率限定在常见语音与媒体档位;最多双声道。真实项目应把这些集合替换成你所接模型的官方要求。
用 ffprobe 读取真实编码信息
FFmpeg 自带的 ffprobe 能统一读取 WAV、MP3 等多种格式,比只靠语言标准库更适合做通用入口检查。下面脚本接收一个文件路径,先检查扩展名,再读取首个音频流,并输出关键参数。
import json
import subprocess
import sys
from pathlib import Path

ALLOWED_EXTENSIONS = {".wav", ".mp3"}
ALLOWED_CODECS = {"pcm_s16le", "pcm_s24le", "pcm_f32le", "mp3"}
ALLOWED_SAMPLE_RATES = {16000, 22050, 24000, 32000, 44100, 48000}
MAX_CHANNELS = 2

def probe_audio(path: Path) -> dict:
    command = [
        "ffprobe", "-v", "error",
        "-show_entries",
        "format=format_name,duration:stream=codec_type,codec_name,sample_rate,channels",
        "-of", "json",
        str(path),
    ]
    result = subprocess.run(command, capture_output=True, text=True)
    if result.returncode != 0:
        raise ValueError("file is damaged or cannot be parsed")
    return json.loads(result.stdout)

def validate_audio(path: Path) -> dict:
    if not path.is_file():
        raise ValueError("file does not exist")
    if path.suffix.lower() not in ALLOWED_EXTENSIONS:
        raise ValueError("unsupported file extension")

    metadata = probe_audio(path)
    streams = [s for s in metadata.get("streams", []) if s.get("codec_type") == "audio"]
    if not streams:
        raise ValueError("no audio stream found")

    stream = streams[0]
    codec = stream.get("codec_name")
    sample_rate = int(stream.get("sample_rate", 0))
    channels = int(stream.get("channels", 0))

    if codec not in ALLOWED_CODECS:
        raise ValueError(f"unsupported codec: {codec}")
    if sample_rate not in ALLOWED_SAMPLE_RATES:
        raise ValueError(f"unsupported sample rate: {sample_rate}")
    if not 1 <= channels <= MAX_CHANNELS:
        raise ValueError(f"unsupported channels: {channels}")

    return {
        "format": metadata["format"]["format_name"],
        "codec": codec,
        "duration": float(metadata["format"]["duration"]),
        "sample_rate": sample_rate,
        "channels": channels,
    }

if __name__ == "__main__":
    if len(sys.argv) != 2:
        raise SystemExit("usage: python inspect_audio.py <audio-file>")

    info = validate_audio(Path(sys.argv[1]))
    for key, value in info.items():
        print(f"{key}={value}")
    print("validation=PASS")
假设 demo.wav 是 16 kHz、单声道、16 位 PCM 文件,运行 python inspect_audio.py demo.wav 后,预期输出形态如下:
format=wav
codec=pcm_s16le
duration=<SECONDS>
sample_rate=16000
channels=1
validation=PASS
<SECONDS> 是文件实际时长。MP3 文件通过时,format 和 codec 会相应显示为 mp3;实际元数据以 ffprobe 返回值为准。
为什么不能只检查扩展名
扩展名只代表文件名约定,不能证明内部数据真实可解码。一个名为 voice.wav 的文件可能已经截断、内容为空,甚至实际装着其他格式的数据。上面的脚本让 ffprobe 真正解析容器和音频流,因此损坏文件会在送入模型前失败。
编码和容器也不是同一概念。WAV 是容器,里面常见的是 PCM;MP3 既常被当作文件格式名称,也对应压缩编码。入口校验应分别检查“文件类型是否允许”和“音频流编码是否允许”,不要把两者合并成一个字符串判断。
把失败变成可处理的输入错误
校验失败时应返回具体原因,例如 unsupported file extension、file is damaged or cannot be parsed、unsupported codec,而不是统一报“识别失败”。这样上传层就能立即提示用户换文件或先转码,不必等模型请求发出后再追日志。
当文件通过校验后,再进入重采样、转单声道或上传识别接口。这样做的价值不是多一层检查,而是把不可控的模型报错提前变成确定、可测试的本地规则。