
音频开发 / 系统课时
用 Whisper 完成本地转写
用 Whisper 完成本地转写
本节把一段本地音频交给 Whisper 完成离线转写,并把整段文本与分段时间戳保存为结构化 JSON。重点不是只跑通一次,而是理解模型尺寸、计算设备、精度和显存占用之间的取舍,形成可重复的本地转写流程。
学习目标
- 能选择合适的 Whisper 模型与 CPU/GPU 设备完成本地转写
- 能读取
text、language、segments等结构化识别结果 - 能根据显存、速度和准确率约束调整模型尺寸与精度
本地转写的数据流
Whisper 的本地流程可以概括为:音频文件先被解码和重采样,再送入语音编码器与文本解码器,最终得到全文和带时间戳的分段结果。真正影响运行成本的核心变量,是模型大小、设备类型和是否使用半精度。
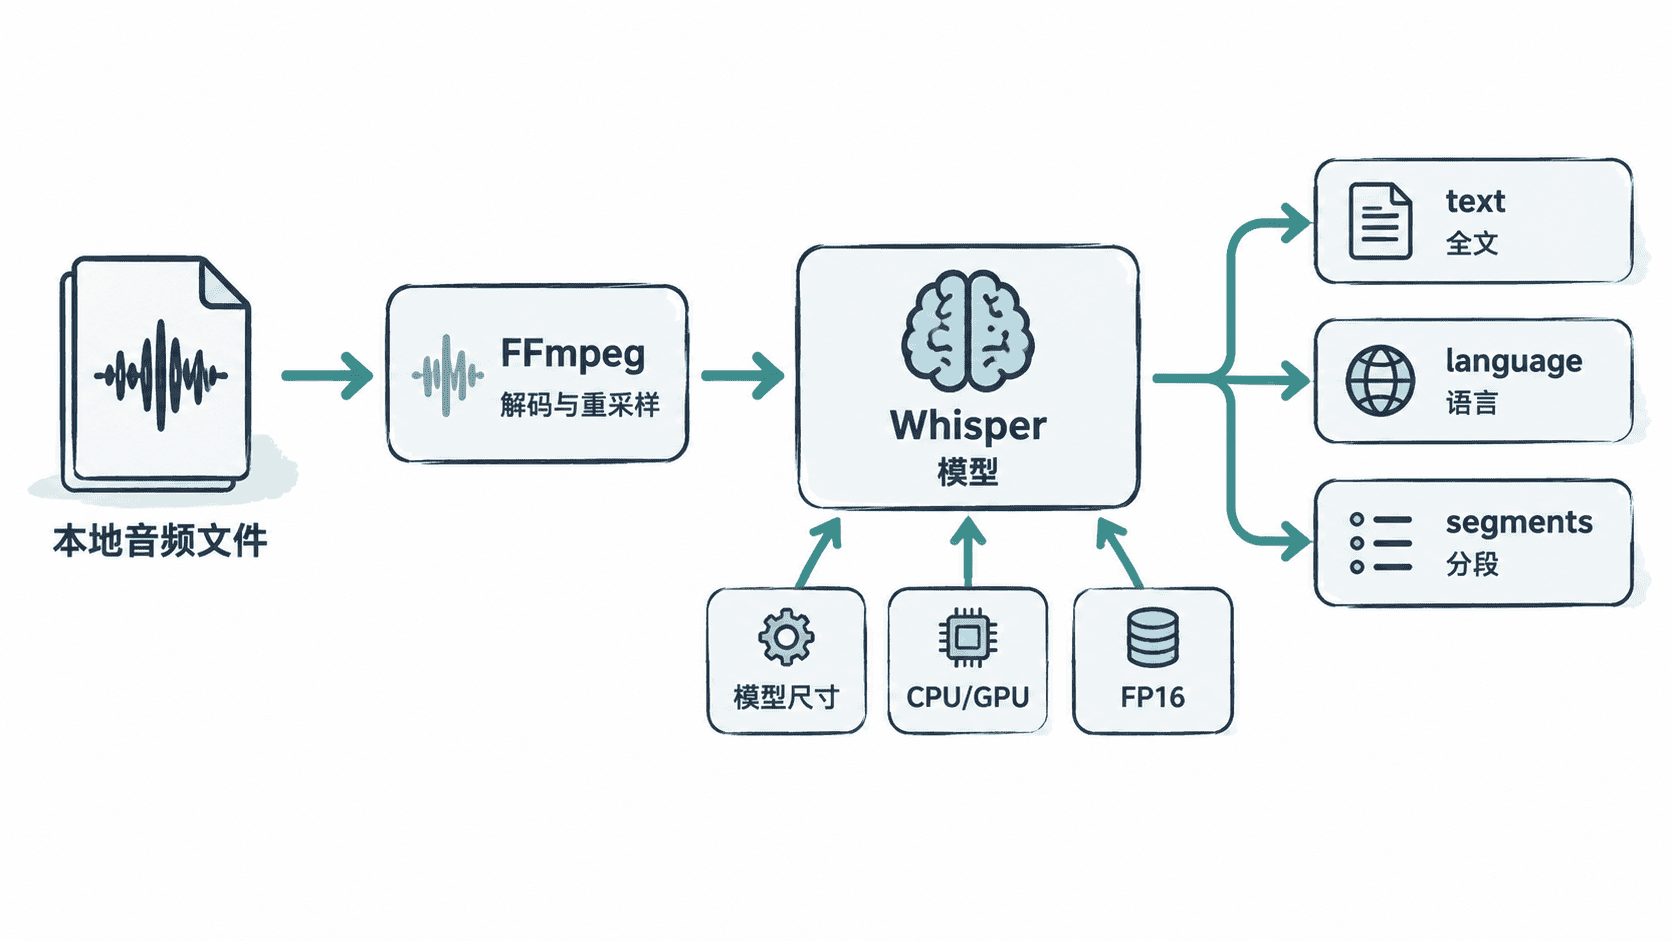
官方 Whisper 常用模型从 tiny、base、small、medium 到 large 逐步增大。通常模型越大,识别鲁棒性和多语言能力越强,但加载时间、显存和推理耗时也会上升。开发阶段可先用 base 或 small 验证流程,再根据真实音频质量决定是否升级。
运行一个完整转写脚本
下面脚本接受音频路径和模型名,自动选择 CUDA 或 CPU,并把结果写入 JSON。运行前应已安装 openai-whisper,且系统可调用 FFmpeg。
import argparse
import json
import torch
import whisper

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("audio")
    parser.add_argument("--model", default="base")
    args = parser.parse_args()

    device = "cuda" if torch.cuda.is_available() else "cpu"
    model = whisper.load_model(args.model, device=device)

    # CPU 不启用 FP16;CUDA 上使用半精度可降低显存和计算开销。
    result = model.transcribe(
        args.audio,
        fp16=(device == "cuda"),
        verbose=False,
    )

    output = {
        "language": result.get("language"),
        "text": result.get("text", "").strip(),
        "segments": [
            {
                "start": round(seg["start"], 2),
                "end": round(seg["end"], 2),
                "text": seg["text"].strip(),
            }
            for seg in result.get("segments", [])
        ],
    }

    print(json.dumps(output, ensure_ascii=False, indent=2))

if __name__ == "__main__":
    main()
预期输出:
{
  "language": "<LANGUAGE>",
  "text": "<TRANSCRIPT>",
  "segments": [
    {
      "start": 0.0,
      "end": 3.42,
      "text": "<SEGMENT_TEXT>"
    }
  ]
}
其中 <LANGUAGE>、<TRANSCRIPT>、<SEGMENT_TEXT> 和时间戳由实际音频决定。只要能看到非空文本,并且 segments 中存在起止时间,就说明模型加载、音频解码和转写链路已经打通。
选择模型、设备与精度
CPU 适合功能验证和低频离线任务,但大模型可能非常慢。具备 NVIDIA CUDA 环境时,GPU 通常能显著缩短推理时间。Whisper 在 CUDA 上常用 FP16 推理以降低显存压力;在 CPU 上则应保持 FP32,否则可能遇到半精度不受支持或性能异常。
模型选择不要只看“越大越准”。清晰普通话、安静环境和短音频,较小模型可能已经足够;远场、口音、噪声或中英混说更值得尝试较大模型。批量任务还要把单文件耗时乘以文件数量,避免单纯追求精度导致总吞吐不可接受。
检查结构化结果
text 适合全文检索和摘要,segments 更适合字幕、时间轴定位和后续切片处理。若只保存纯文本,之后想回到原音频的具体位置会很困难,因此批量转写通常应同时保留分段时间戳。
实际生产中还应记录模型名、设备、处理时间和源文件标识。这样即使以后更换模型,也能区分“同一音频由哪个版本识别”,方便回归比较和重新处理。