
音频开发 / 系统课时
发送流式音频并增量转写
发送流式音频并增量转写
实时语音识别不是“录完再上传”,而是边采集边发送、边接收识别结果。核心是控制音频帧大小与发送节奏,并正确区分会反复变化的 partial 结果和已经确认的 final 结果,让界面能持续更新而不重复拼接文本。
学习目标
- 理解音频帧、流式连接、partial 与 final 的协作关系。
- 能实现“发送音频帧 → 接收增量结果 → 更新界面”的最小处理链路。
- 能用序号和状态约束避免重复显示、乱序覆盖和结束过早。
实时链路如何工作
一条典型链路同时存在三个方向:采集端持续产生 PCM 音频帧,客户端通过 WebSocket 等长连接上传音频,识别服务再异步返回增量文本。发送和接收不能互相阻塞,否则网络抖动会直接拖慢录音采集。
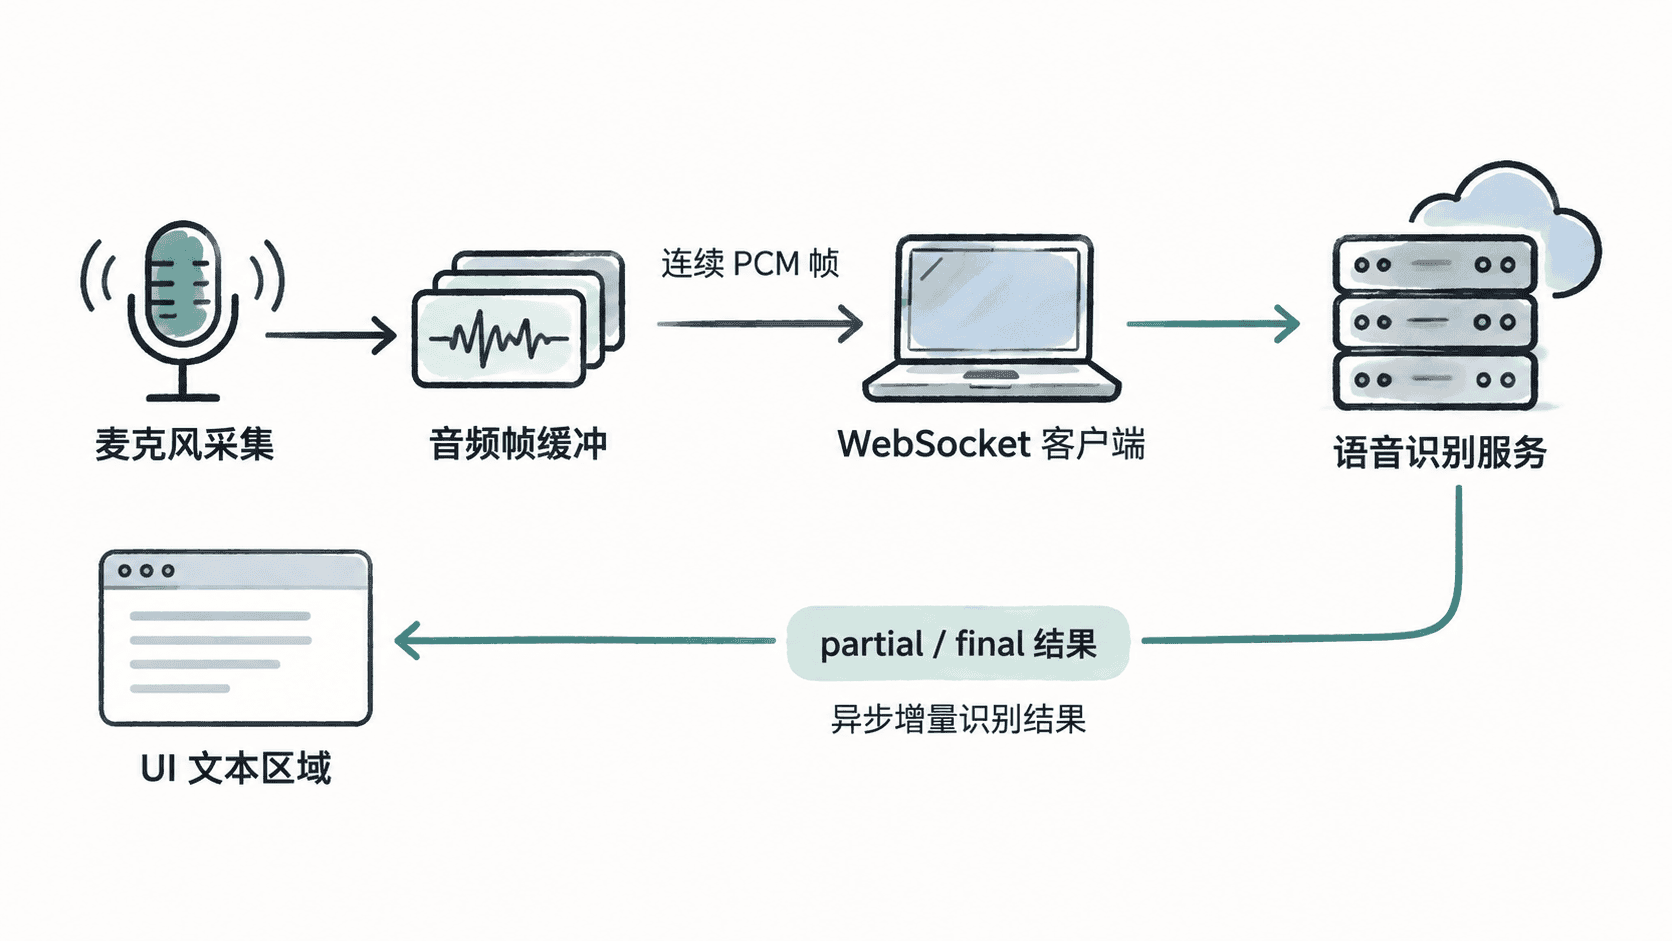
音频帧通常按固定时长切分,例如每 20~100 ms 一帧。帧太大,会增加首字延迟;帧太小,则会增加发送次数和协议开销。真正的取值还要结合采样率、编码格式、网络 RTT 和识别服务限制。
partial 与 final 的语义
partial 表示“当前最佳猜测”,后续可能被覆盖。例如先返回“今天北京天”,随后修正为“今天北京天气”。因此 partial 不能直接追加到全文尾部,而应覆盖当前未确认区域。
final 表示当前语音片段已经确认。收到 final 后,才能把这段文本加入已确认内容,并清空当前 partial。一个简单可靠的状态可以只保留两部分:committedText 与 partialText。
最小可运行处理器
下面用一个自包含 JavaScript 示例模拟 WebSocket。它连续发送三个音频帧,并依次收到两个 partial 和一个 final。真实项目只需要把 MockSocket 换成实际长连接,并把 sendAudioFrame 的输入替换成采集到的二进制音频帧。
class MockSocket {
  constructor(onMessage) {
    this.onMessage = onMessage;
  }

  send(frame) {
    console.log(`send ${frame.byteLength} bytes`);
  }

  emit(message) {
    this.onMessage(JSON.stringify(message));
  }
}

let committedText = "";
let partialText = "";

function render() {
  console.log(`UI: ${committedText}${partialText}`);
}

function handleRecognitionMessage(raw) {
  const message = JSON.parse(raw);

  // partial 只覆盖可变区,final 才进入已确认区。
  if (message.type === "partial") {
    partialText = message.text;
  } else if (message.type === "final") {
    committedText += message.text;
    partialText = "";
  }

  render();
}

const socket = new MockSocket(handleRecognitionMessage);

function sendAudioFrame(samples) {
  // 示例使用 Int16Array 表示已编码好的 PCM16 音频帧。
  socket.send(samples.buffer);
}

sendAudioFrame(new Int16Array(320));
sendAudioFrame(new Int16Array(320));
sendAudioFrame(new Int16Array(320));

socket.emit({ type: "partial", text: "今天北京天" });
socket.emit({ type: "partial", text: "今天北京天气" });
socket.emit({ type: "final", text: "今天北京天气很好。" });
预期输出:
send 640 bytes
send 640 bytes
send 640 bytes
UI: 今天北京天
UI: 今天北京天气
UI: 今天北京天气很好。
这里每帧是 320 个 16 位采样点,因此大小为 640 字节。真实系统的帧长必须由采样率推导,例如 16 kHz 单声道 PCM16 下,20 ms 音频对应 320 个采样点。
处理顺序与结束条件
生产实现还需要给识别事件附带递增序号或服务端时间戳。客户端只接受不早于当前状态的结果,防止网络重传或乱序消息覆盖较新的文本。如果服务协议提供 segmentId,应按片段分别维护状态,而不是把所有结果混在一个字符串里。
停止录音时也不要立即关闭连接。更稳妥的顺序是先停止采集,再发送“音频结束”信号,继续接收剩余结果,直到服务端确认最后一个 final 或返回结束事件,然后再关闭连接。这样可以避免最后几个词还在服务端解码时就被客户端截断。
验证时重点观察三件事:音频帧是否持续按节奏发送、partial 是否只覆盖当前可变文本、final 是否只提交一次。只要这三条成立,实时采集到增量转写的主链路就已经闭合。