
音频开发 / 系统课时
用唤醒词或按键触发录音
用唤醒词或按键触发录音
录音触发方式决定语音应用什么时候开始占用麦克风、什么时候结束一轮输入,以及误触发会有多频繁。本课比较按键、自动端点和唤醒词三种方案,并给出一套可以直接实现的开始、停止与防误触发规则。
学习目标
- 能根据交互场景选择按键、自动端点或唤醒词触发
- 能为一次录音会话定义明确的开始条件、停止条件和超时
- 能通过阈值、确认窗口和冷却时间降低环境声音误触发
三种触发方式怎么选
按键触发最确定:用户按下后开始录音,松开或再次点击后停止,适合桌面工具、客服工作台和调试版本。它几乎没有误唤醒问题,但需要用户主动操作。
自动端点通常依赖 VAD 判断有人开始说话和已经停止说话。它的交互更自然,但如果设备长期监听,就必须处理电视声、键盘声和多人环境中的误启动。
唤醒词则把持续监听限制在一个轻量检测器中,只有检测到指定短语后才真正创建录音会话。它适合免手操作,但需要额外处理置信度阈值、重复命中和设备自身播报声音反灌。
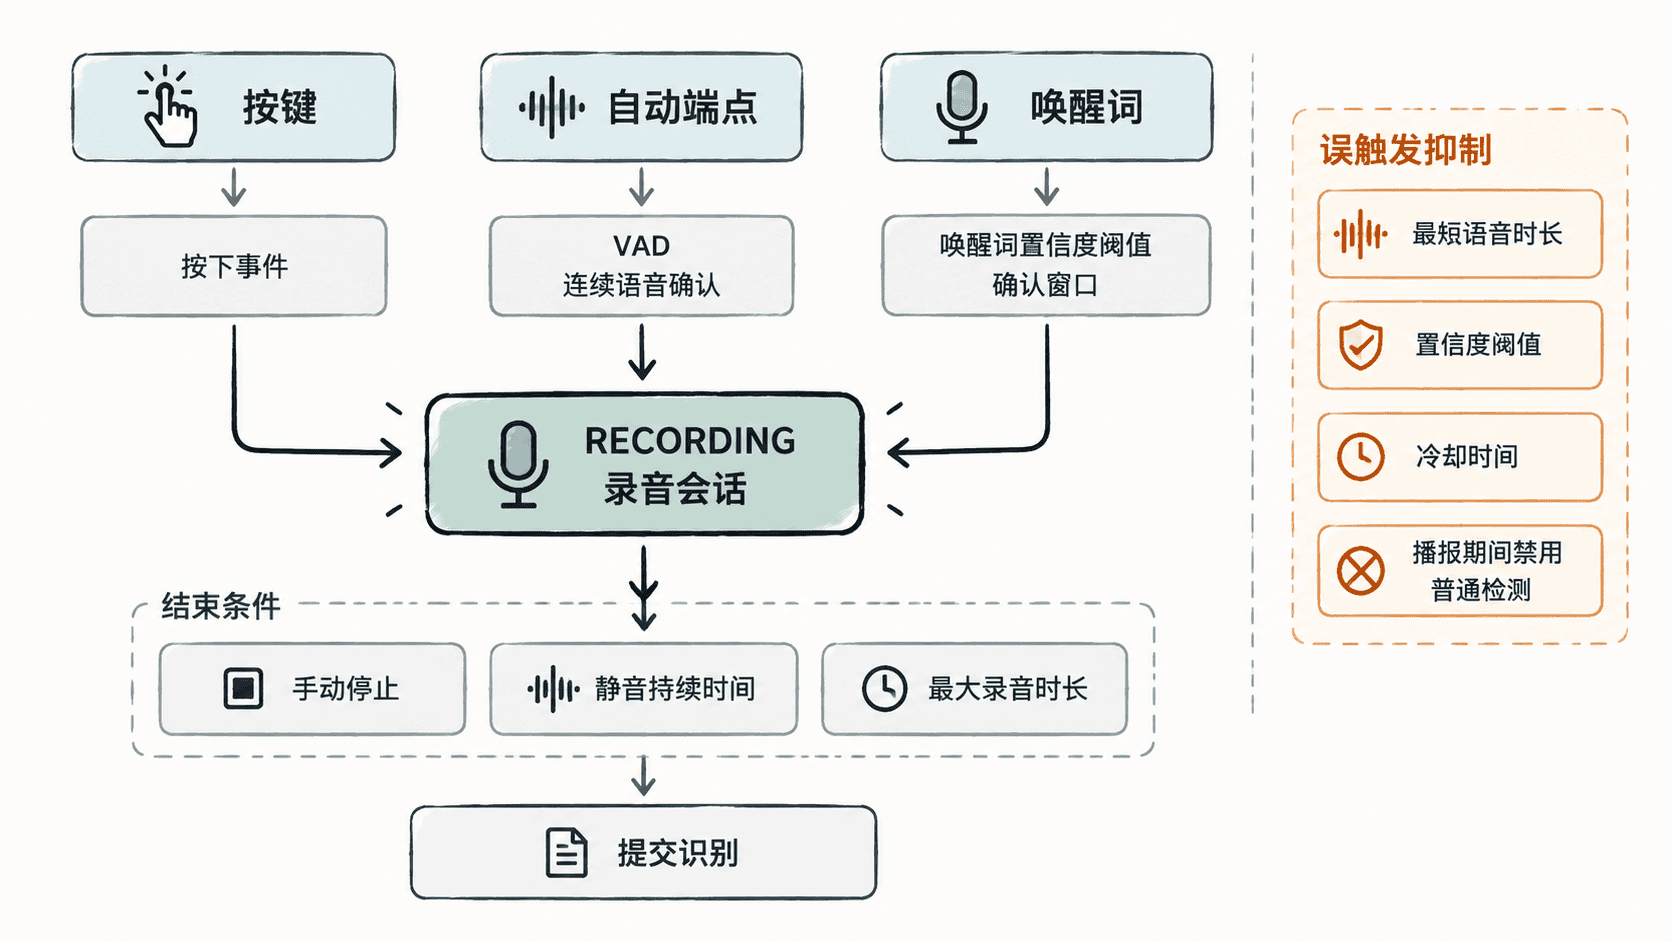
如果产品还没有稳定的声学环境数据,优先从按键触发做起。它能先验证录音、识别、生成和播报整条链路,再逐步替换为 VAD 或唤醒词,避免一开始就把识别错误和触发错误混在一起排查。
给录音会话设置硬边界
无论入口是什么,一次录音都应该同时有正常停止条件和兜底停止条件。常用条件包括用户主动停止、连续静音达到阈值、达到最大录音时长,以及应用失去麦克风权限或音频设备被其他程序占用。
例如可以采用以下范围作为调试起点:检测到连续 300~500 ms 有效语音才确认开始;录音后连续 800~1200 ms 静音视为说完;单轮录音最长 15~30 s。具体阈值必须结合真实设备、麦克风距离和环境噪声调节,不存在适用于所有场景的固定最佳值。
用统一控制器处理不同入口
下面示例把按键、唤醒词和 VAD 都转换成统一事件。这样上层录音逻辑只需要处理 START、SPEECH、SILENCE 和 STOP,增加新的触发入口时不必复制整套录音代码。
from dataclasses import dataclass


@dataclass
class Recorder:
    active: bool = False
    silence_ms: int = 0
    elapsed_ms: int = 0

    def handle(self, event: str, frame_ms: int = 100) -> None:
        if event == 'START' and not self.active:
            self.active = True
            self.silence_ms = 0
            self.elapsed_ms = 0
            print('recording:start')
            return

        if not self.active:
            return

        self.elapsed_ms += frame_ms
        if event == 'SPEECH':
            self.silence_ms = 0
        elif event == 'SILENCE':
            self.silence_ms += frame_ms
        elif event == 'STOP':
            self._finish('manual')
            return

        # 连续静音 1000 ms 或总时长 30000 ms 时结束本轮录音。
        if self.silence_ms >= 1000:
            self._finish('endpoint')
        elif self.elapsed_ms >= 30000:
            self._finish('timeout')

    def _finish(self, reason: str) -> None:
        self.active = False
        print(f'recording:stop reason={reason}')


if __name__ == '__main__':
    recorder = Recorder()
    recorder.handle('START')
    recorder.handle('SPEECH')
    for _ in range(10):
        recorder.handle('SILENCE')
预期输出
recording:start
recording:stop reason=endpoint
实际接入时,按键按下可以直接产生 START;唤醒词检测器只有在置信度超过阈值并通过确认窗口后才产生 START;VAD 则可以在连续若干帧都判定为语音后产生 START。三种入口汇入同一个录音控制器后,后续停止和提交识别的逻辑保持一致。
把误触发控制放在录音之前
误触发应尽量在真正创建一轮录音会话之前被过滤。唤醒词不要只看单帧最高分,而应结合连续帧确认;自动端点也不要凭一次 VAD 命中就开始录音,而应要求有效语音持续达到最短时间。
还需要设置冷却时间。例如一次唤醒后 1~2 s 内忽略新的唤醒命中,避免同一句声音被重复触发。系统正在 TTS 播报时,如果没有回声消除或独立的打断检测链路,应暂停普通唤醒词检测,否则设备可能被自己的扬声器声音再次唤醒。
选择触发方案时,应先保证录音边界能够稳定验证,再追求更自然的免手交互:按键提供确定性,VAD 提供自动端点,唤醒词提供免手入口;它们最终都应收敛到同一个受状态机约束的录音会话。