
音频开发 / 系统课时
压低实时识别端到端延迟
压低实时识别端到端延迟
实时识别的优化目标不是单纯让模型“跑得更快”,而是缩短用户开口到文字真正出现在界面上的总时间。本节会把端到端延迟拆成可测量的阶段,用统一时间点定位瓶颈,再针对帧大小、缓冲、网络和推理逐项优化。
学习目标
- 建立从采集到渲染的端到端延迟指标,并区分各阶段贡献
- 用可复现的时间戳数据定位主要瓶颈,而不是凭感觉调参数
- 根据瓶颈调整音频分帧、缓冲、传输和推理策略,并用分位数验证效果
先把总延迟拆开
最有用的指标是“用户声音已经进入采集链路”到“对应部分文本完成渲染”的时间。可以把一次识别链路近似写成:
其中,采集与分帧决定音频多久能被送出;缓冲可能来自客户端队列、WebSocket 发送队列或服务端抖动缓冲;网络包含上行与下行;服务端还会经历排队和推理;最后还有结果反序列化、状态更新与 UI 渲染。
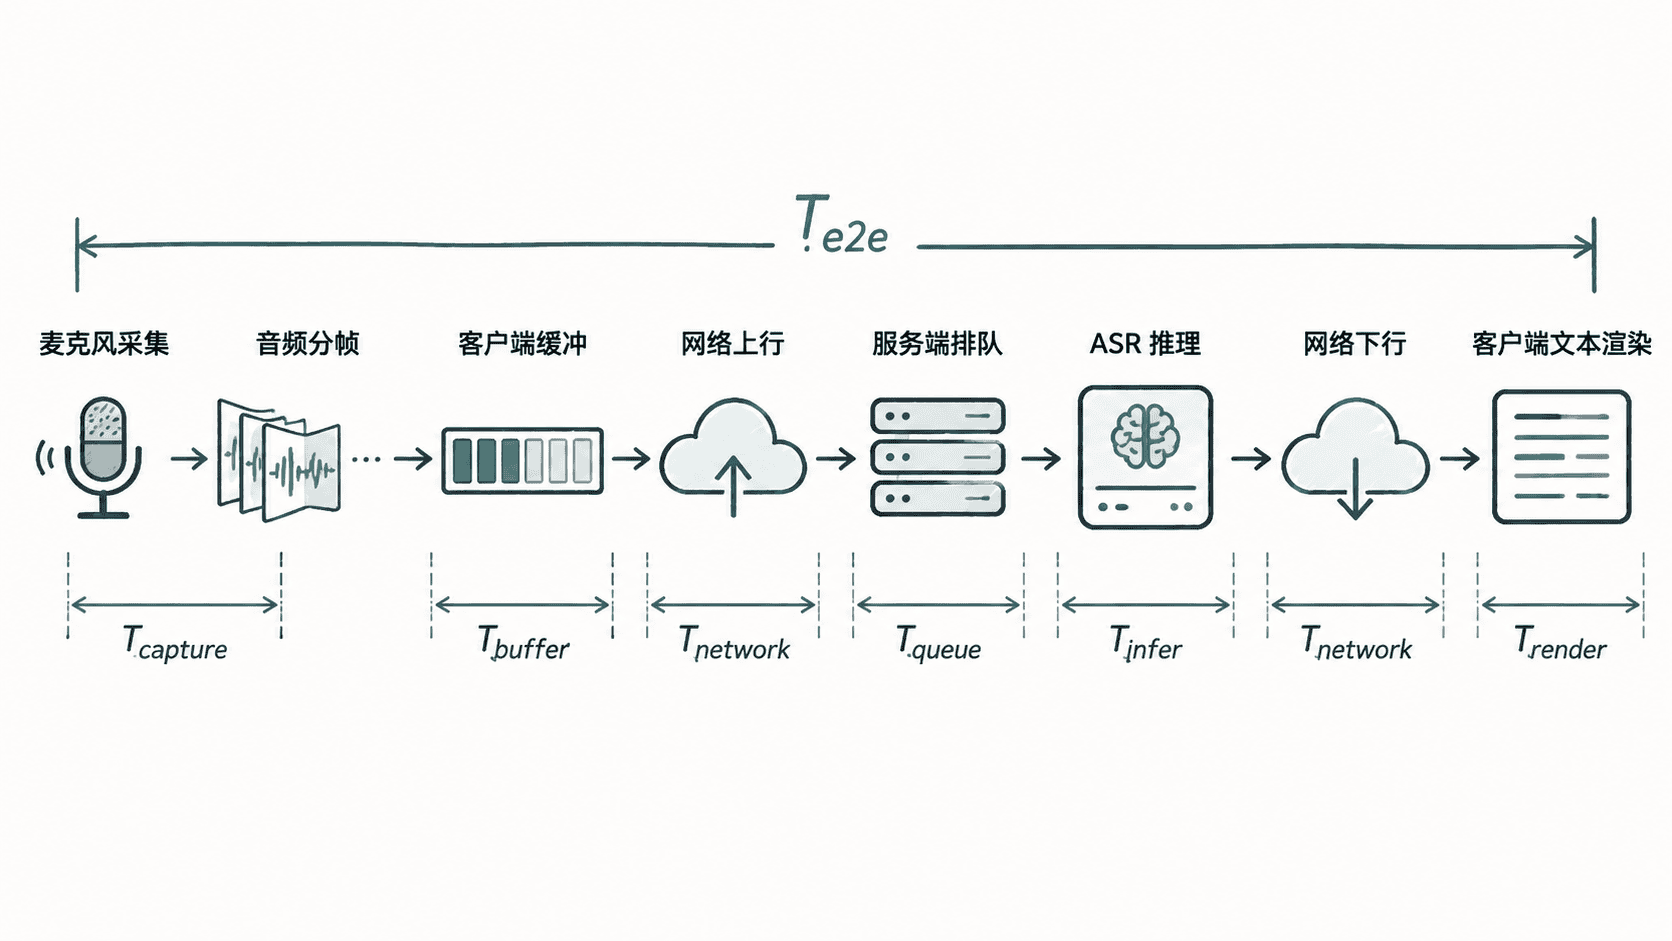
不要直接用两台机器的绝对时间戳相减来估算单向网络延迟,除非已经做了可靠时钟同步。更稳妥的做法是:客户端用单调时钟测总耗时,服务端在自己的单调时钟内测“排队 + 推理”,再把其余时间作为网络与客户端开销的组合项分析。
用时间点做一次可复现测量
下面的脚本读取一条简化的追踪记录,计算客户端等待、服务端处理、结果回传与端到端延迟。真实项目中这些时间点应通过同一个 traceId 串起来,并分别记录首个 partial 文本延迟与最终稳定文本延迟。
from dataclasses import dataclass

@dataclass
class Trace:
    speech_start_ms: float
    frame_ready_ms: float
    send_ms: float
    server_recv_ms: float
    server_done_ms: float
    client_recv_ms: float
    render_done_ms: float

def analyze(trace: Trace) -> None:
    capture = trace.frame_ready_ms - trace.speech_start_ms
    client_buffer = trace.send_ms - trace.frame_ready_ms
    server_processing = trace.server_done_ms - trace.server_recv_ms
    client_return_and_render = trace.render_done_ms - trace.client_recv_ms
    end_to_end = trace.render_done_ms - trace.speech_start_ms

    # 跨主机绝对时间不直接相减,只保留各自主机内可比较的区间。
    residual = end_to_end - capture - client_buffer - server_processing - client_return_and_render

    print(f"capture={capture:.0f} ms")
    print(f"client_buffer={client_buffer:.0f} ms")
    print(f"server_processing={server_processing:.0f} ms")
    print(f"return+render={client_return_and_render:.0f} ms")
    print(f"network+other≈{residual:.0f} ms")
    print(f"e2e={end_to_end:.0f} ms")

trace = Trace(
    speech_start_ms=1000,
    frame_ready_ms=1040,
    send_ms=1060,
    server_recv_ms=5000,
    server_done_ms=5120,
    client_recv_ms=1280,
    render_done_ms=1300,
)
analyze(trace)
预期输出:
capture=40 ms
client_buffer=20 ms
server_processing=120 ms
return+render=20 ms
network+other≈100 ms
e2e=300 ms
这组数据说明模型处理并不是唯一大头。若只把推理从 120 ms 优化到 80 ms,总延迟也只下降 40 ms;如果同时存在 40 ms 的采集成帧、20 ms 的客户端缓冲和约 100 ms 的网络及其他开销,就应并行处理这些部分。
按瓶颈调整实时链路
如果发送前等待高,先检查音频帧是否过大,以及是否为了“攒够一块”而额外等待。语音流通常应使用几十毫秒级的小帧持续发送,而不是累计数百毫秒后再批量提交。帧越小首包越快,但包数量、协议开销和调度次数会上升,所以要观察 CPU 与网络开销,不能只追求最小帧长。
如果客户端缓冲持续增长,说明生产速度超过消费速度。此时要给发送队列设置上限并监控队列时长;网络短暂抖动可以保留少量音频,但不能无限堆积,否则系统虽然“不丢数据”,用户看到的文字却会越来越落后于实时声音。
如果服务端处理高,应继续拆成排队、特征处理和模型推理。排队高通常先处理并发、批处理等待和实例负载;纯推理高再考虑更快模型、量化、硬件加速、流式解码或缩短首个 partial result 的生成周期。不要用增大批量换吞吐时忽略实时场景的等待成本。
如果网络项高,先看连接是否复用、是否存在代理缓冲、跨地域链路和丢包重传。实时识别优先保持长连接并持续小包发送,同时避免在应用层再次积攒数据。结果侧应尽早推送增量文本,而不是等待整句结束后一次返回。
用同一套实验验证优化
每次只改一个主要变量,例如把帧长从 100 ms 调到 40 ms,然后在相同音频、相同地域和相同并发下重复测试。至少记录端到端、发送前等待、服务端处理和客户端渲染四类指标,并分别比较冷启动与稳定运行后的数据。
验收时关注两个问题:首个可用文本是否更快出现,以及长时间连续识别是否会产生越来越大的滞后。如果首包变快但队列持续增长,说明只是把问题往后推;真正有效的优化应该让延迟分布整体下降,并且在持续语音下保持稳定。