
音频开发 / 系统课时
调用首个语音合成接口
调用首个语音合成接口
这一课把一段中文文本真正变成可播放音频:构造 TTS 请求,选择音色与 MP3 编码,保存接口返回的二进制数据,并用系统默认播放器打开文件,同时把最容易踩坑的参数边界一次确认清楚。
学习目标
- 能向语音合成接口发送一次完整请求并保存音频
- 能正确选择音色与输出编码,区分音频二进制和 JSON 响应
- 能验证生成文件,并定位文本长度、鉴权和格式类错误
先看清一次 TTS 调用的链路
一次最小 TTS 调用只有五个关键环节:文本进入请求体,服务端模型按指定音色生成语音,接口返回音频字节,客户端写入文件,最后交给播放器。这里最重要的认知是:成功响应主体本身就是音频数据,而不是再包一层 JSON。
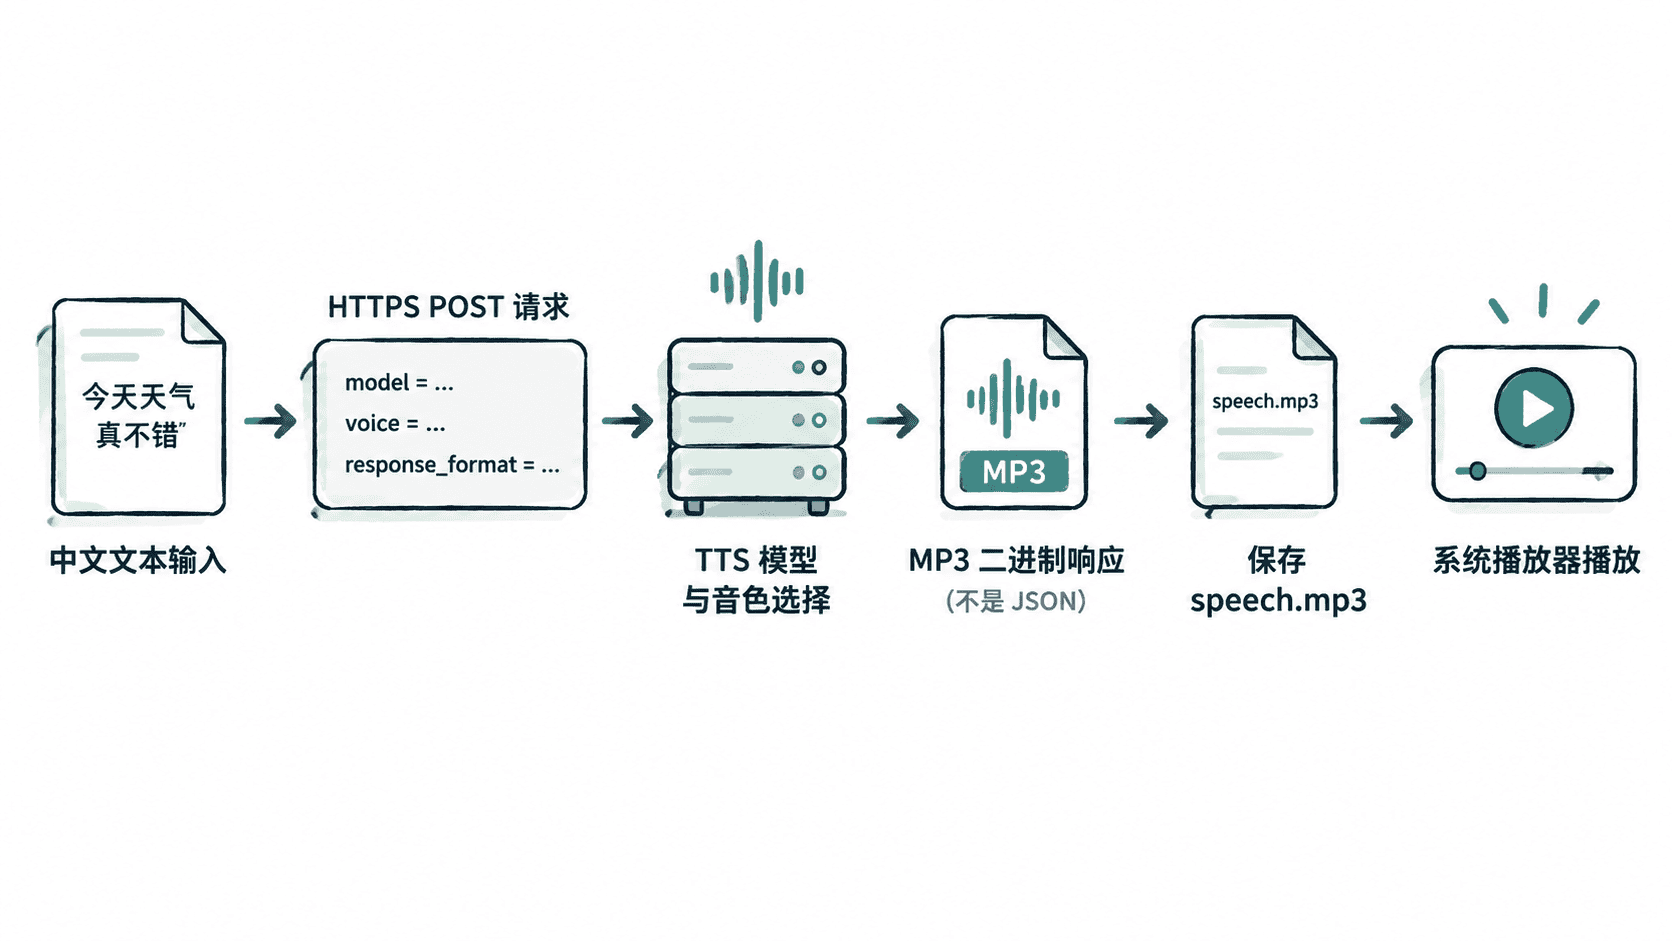
下面使用 OpenAI 的 POST /v1/audio/speech 作为首个可运行示例。当前接口要求 model、voice、input,并可通过 response_format 选择 mp3、wav 等编码;input 当前最大长度为 4096 个字符。([OpenAI Platform][1])
完成第一次合成
先确保环境变量 OPENAI_API_KEY 已配置。下面的 Python 程序只使用标准库:请求生成一段中文语音,将返回内容写入 speech.mp3,随后调用当前操作系统的默认方式打开文件。
import json
import os
import platform
import subprocess
import urllib.request
from pathlib import Path

api_key = os.environ.get("OPENAI_API_KEY")
if not api_key:
    raise SystemExit("missing OPENAI_API_KEY")

payload = {
    "model": "gpt-4o-mini-tts",
    "voice": "marin",
    "input": "你好,这是我的第一次语音合成调用。",
    "response_format": "mp3",
}

request = urllib.request.Request(
    "https://api.openai.com/v1/audio/speech",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {api_key}",
        "Content-Type": "application/json",
    },
    method="POST",
)

with urllib.request.urlopen(request, timeout=60) as response:
    audio_bytes = response.read()

output = Path("speech.mp3")
output.write_bytes(audio_bytes)
print(f"saved: {output} ({len(audio_bytes)} bytes)")

system = platform.system()
if system == "Windows":
    os.startfile(output)
elif system == "Darwin":
    subprocess.run(["open", str(output)], check=False)
else:
    subprocess.run(["xdg-open", str(output)], check=False)
预期输出:
saved: speech.mp3 (<BYTES> bytes)<BYTES> 会随文本、音色和编码结果变化。成功后当前目录应出现非空的 speech.mp3,并由系统默认播放器打开;若环境没有图形播放器,文件仍会正常保存。
参数怎么选才不容易出错
voice 决定说话音色,response_format 决定返回音频的容器或编码。首个链路优先选 mp3,因为文件体积小、播放器兼容性高;如果后续要做音频处理、波形分析或低延迟拼接,再根据下游要求改成 wav 或 pcm。
不要根据文件扩展名猜接口响应是否成功。真正可靠的判断顺序是先检查 HTTP 状态,再确认响应体非空,最后把字节按请求的格式保存。若把音频响应误当成 JSON 调用解析,会得到解码错误,而不是模型生成失败。
失败时按这个顺序定位
出现 401 或 403 时先检查 API Key 和账户权限;出现 400 时重点检查 model、voice、response_format 与文本长度;网络超时则先确认代理、DNS 和目标域名可达。若接口成功但播放器打不开,优先检查文件是否非空,以及扩展名是否与请求的编码一致。
文本较长时不要把整篇文章一次塞进请求。更稳妥的做法是按句子或自然段切分,并在应用层顺序合成、缓存和播放。到这里,只要能稳定得到一个可播放的 speech.mp3,首个 TTS 调用链路就已经跑通。