
音频开发 / 系统课时
切分长音频并保留时间轴
切分长音频并保留时间轴
长录音通常不能直接一次送入识别模型:接口可能存在时长限制,处理延迟也会随输入增长。可靠做法是把音频切成多个片段,同时记录每个片段在原始录音中的全局起止时间,识别完成后再把局部时间戳恢复到同一条连续时间轴。
学习目标
- 能按固定窗口切分长 WAV,并为每个片段保存全局时间偏移。
- 能把模型返回的片段内时间戳恢复为原始录音时间戳。
- 能理解固定窗口与语音边界切分在连续性和实现成本上的差异。
时间轴不能跟着切片归零
假设原始录音从 0 秒开始,每 30 秒切一段。第二段在自己的音频文件中仍然从 0 秒计时,但它在原始录音中的全局起点其实是 30 秒。如果模型判断第二段的一句话位于局部 4.2~6.0 秒,最终字幕必须转换为全局 34.2~36.0 秒。
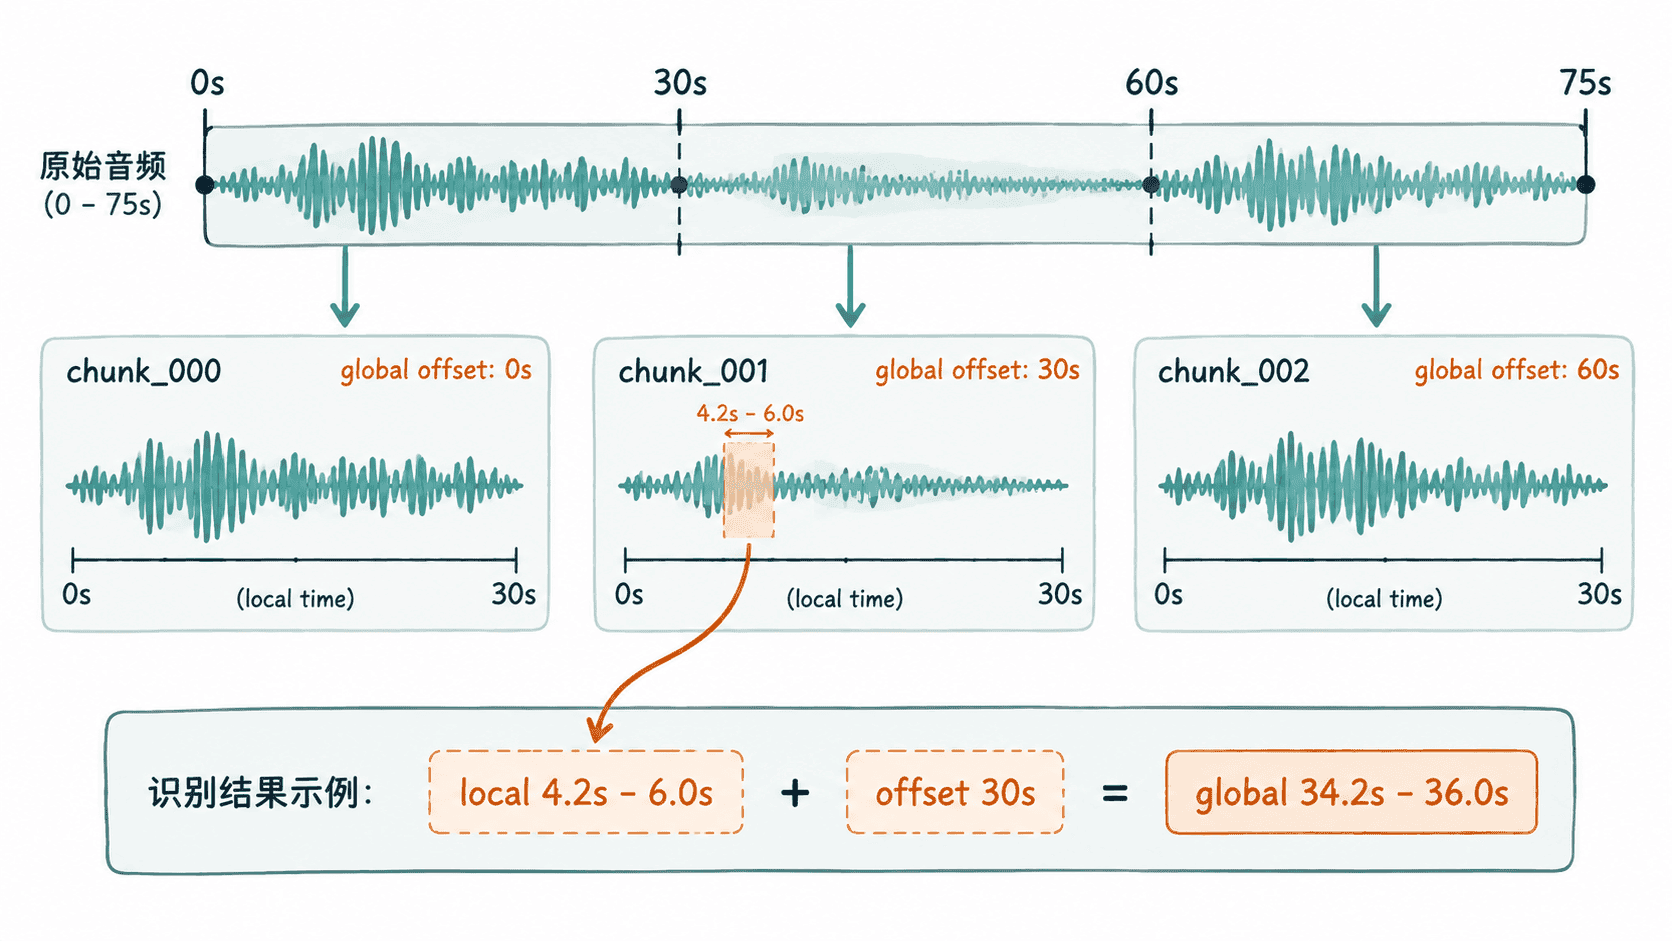
恢复规则可以写成 globalTime = chunkOffset + localTime。真正容易出错的地方不是这个加法,而是切片阶段没有保存 chunkOffset,后续只能根据文件名或片段顺序猜测偏移。一旦发生重试、缺片或重新切分,这种推断就会失效。
用固定窗口生成片段清单
下面的程序针对未压缩 PCM WAV 工作。它按固定秒数读取音频帧,为每个片段保存原始录音中的 start_ms 和 end_ms,并生成 manifest.json。时间直接由帧位置和采样率计算,可以避免连续累加浮点秒数产生误差。
from __future__ import annotations

import argparse
import json
import wave
from pathlib import Path


def split_wav(input_path: Path, output_dir: Path, chunk_seconds: int) -> None:
    output_dir.mkdir(parents=True, exist_ok=True)

    with wave.open(str(input_path), "rb") as src:
        channels = src.getnchannels()
        sample_width = src.getsampwidth()
        frame_rate = src.getframerate()
        total_frames = src.getnframes()
        chunk_frames = frame_rate * chunk_seconds
        manifest = []
        index = 0

        while src.tell() < total_frames:
            start_frame = src.tell()
            frames_to_read = min(chunk_frames, total_frames - start_frame)
            frames = src.readframes(frames_to_read)
            if not frames:
                break

            end_frame = src.tell()
            filename = f"chunk_{index:03d}.wav"
            chunk_path = output_dir / filename

            # 切片阶段保持原音频参数不变,只改变文件边界。
            with wave.open(str(chunk_path), "wb") as dst:
                dst.setnchannels(channels)
                dst.setsampwidth(sample_width)
                dst.setframerate(frame_rate)
                dst.writeframes(frames)

            # 偏移从原始帧位置计算,不依赖片段序号推断。
            manifest.append(
                {
                    "file": filename,
                    "start_ms": round(start_frame * 1000 / frame_rate),
                    "end_ms": round(end_frame * 1000 / frame_rate),
                }
            )
            index += 1

    manifest_path = output_dir / "manifest.json"
    manifest_path.write_text(
        json.dumps(manifest, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )
    print(f"created {len(manifest)} chunks; manifest={manifest_path}")


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("input", type=Path)
    parser.add_argument("--output-dir", type=Path, default=Path("chunks"))
    parser.add_argument("--chunk-seconds", type=int, default=30)
    args = parser.parse_args()
    split_wav(args.input, args.output_dir, args.chunk_seconds)
预期结果
脚本读取一个 PCM WAV,生成 chunk_000.wav、chunk_001.wav 等片段,并在输出目录写入 manifest.json;片段数量取决于原始音频时长。将代码保存为 split_audio.py,并准备一个 PCM WAV 格式的 input.wav 后运行:
python split_audio.py input.wav --chunk-seconds 30预期输出
created <ID> chunks; manifest=chunks/manifest.json其中 <ID> 是实际生成的片段数量,随输入音频总时长变化。manifest.json 中每条记录的 start_ms 都是相对原始录音起点的全局偏移,而不是相对当前片段的局部时间。
恢复识别结果的连续时间
假设模型对 chunk_001.wav 返回局部时间戳 start_ms=4200、end_ms=6000,而清单记录该片段的全局 start_ms=30000,最终时间就是 34200~36000 毫秒。对全部片段执行相同换算后,再按照全局开始时间排序即可形成连续字幕。
不要通过“片段序号乘以 30 秒”计算偏移。固定窗口最后一段通常不足 30 秒,而 VAD 切分后每段长度更不固定;如果以后加入重叠窗口,这种推算还会进一步失效。清单中的实际起止位置才应作为时间轴事实来源。
固定窗口与语音边界怎么选
固定窗口实现简单、片段大小稳定,适合先建立可靠的批处理链路,但切点可能落在一句话中间。使用 VAD 等语音边界切分能降低截断一句话的概率,却需要额外处理静音阈值、最短语音长度、最长片段和噪声环境下的误判。
如果采用重叠切片,例如每段覆盖 30 秒而相邻片段重叠 2 秒,时间恢复仍然先执行全局偏移换算,但之后还必须处理重叠区域的重复文本。可以结合时间区间交集、文本相似度或模型提供的 token 时间戳决定保留哪一份结果。
无论最终使用固定窗口还是语音边界,时间轴协议都应保持稳定:切片负责记录原始录音中的全局位置,识别模型只返回片段内部时间,聚合阶段统一完成偏移换算。只要这个边界清晰,后续替换切分算法也不会破坏字幕与原始录音的对齐关系。