
音频开发 / 系统课时
设计环形缓冲与端点检测
设计环形缓冲与端点检测
实时识别既不能等用户长时间沉默后才返回,也不能在一句话中间过早截断。本节用环形缓冲保留起点前的短暂音频,并用连续语音帧与连续静音帧确认起止点,组合出一个响应快、又能抵抗短暂停顿的端点检测器。
学习目标
- 使用环形缓冲保存有限长度的语音前滚数据
- 用 VAD 连续帧计数确认语音开始与结束
- 根据帧长把启动门限、尾部静音和延迟换算成可调参数
环形缓冲解决起点被吃掉的问题
VAD 不应在检测到第一帧语音时立即宣布开始。环境噪声可能偶尔产生一个阳性帧,因此通常需要连续若干个语音帧才能确认用户确实开口。
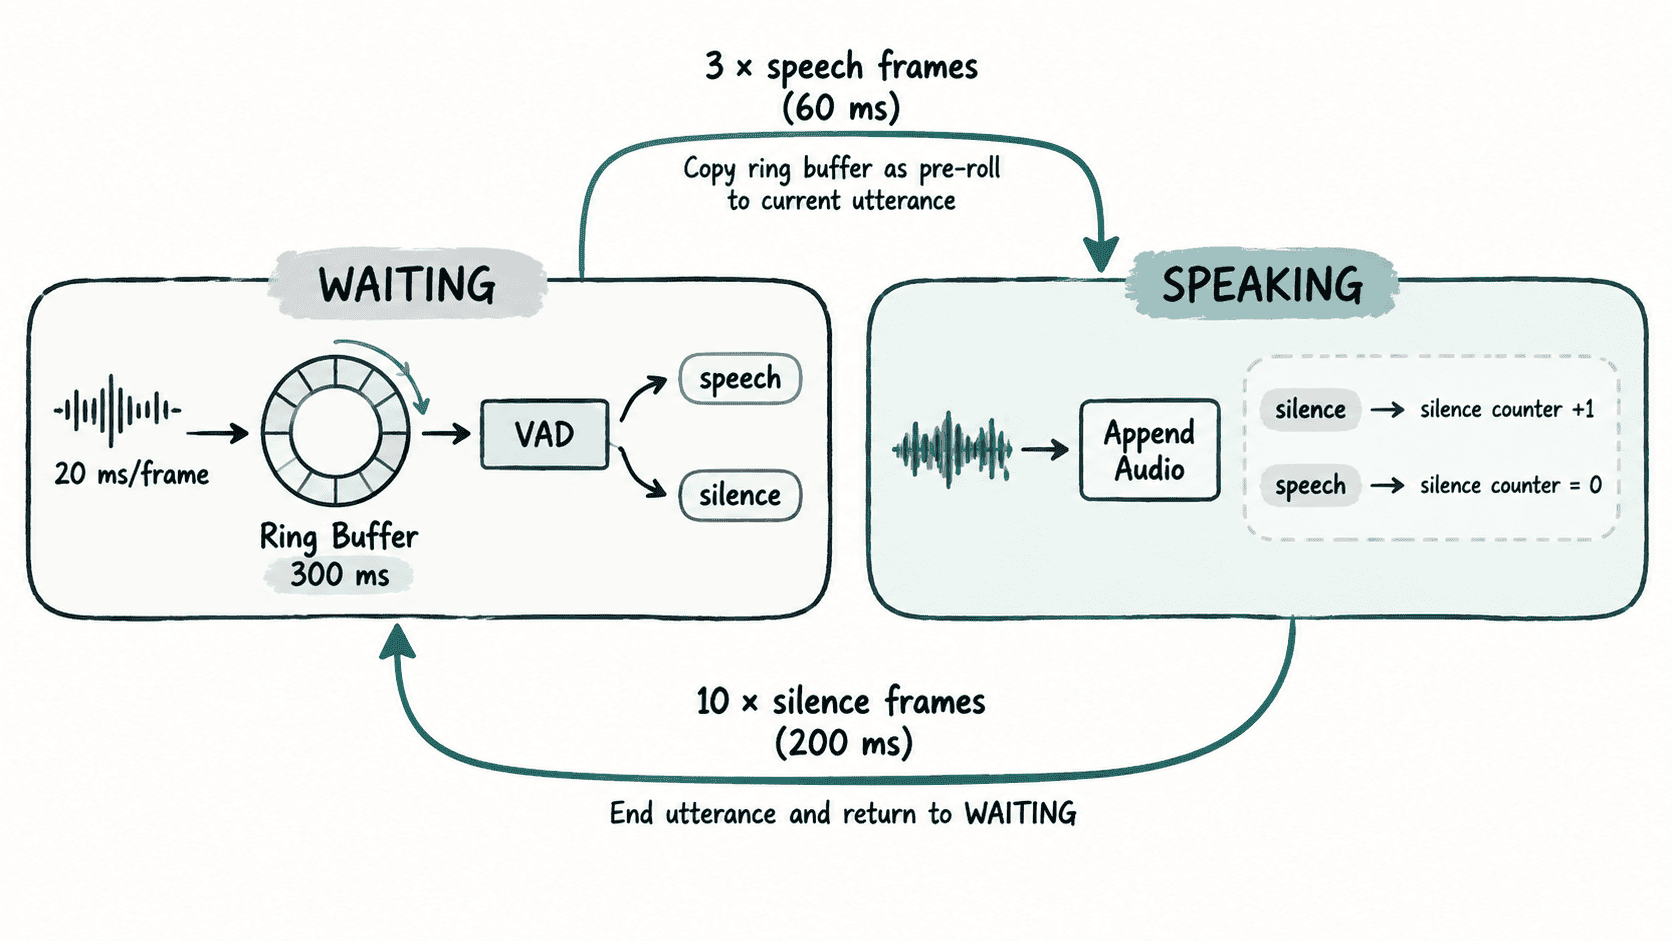
问题在于,等确认完成后再开始保存音频,会丢掉最前面的几十毫秒。解决方法是在等待状态持续保存最近一小段音频,例如 300 ms;一旦确认语音开始,就把这段前滚数据一起并入当前话语。
环形缓冲特别适合这个场景。它只保留最近固定数量的帧,容量满后自动淘汰最旧帧,因此内存占用不会随运行时间增长。假设每帧 20 ms,300 ms 前滚缓冲需要保存 15 帧。
用连续帧门限判断起止点
下面的完整示例把每帧是否为语音视为 VAD 已给出的布尔结果。等待阶段需要连续 3 个语音帧才触发开始;说话阶段需要连续 10 个静音帧才触发结束。20 ms 一帧时,它们分别对应 60 ms 的启动确认和 200 ms 的结束等待。
from collections import deque
from dataclasses import dataclass

FRAME_MS = 20
PRE_ROLL_MS = 300
START_SPEECH_MS = 60
END_SILENCE_MS = 200

PRE_ROLL_FRAMES = PRE_ROLL_MS // FRAME_MS
START_SPEECH_FRAMES = START_SPEECH_MS // FRAME_MS
END_SILENCE_FRAMES = END_SILENCE_MS // FRAME_MS


@dataclass
class Frame:
    seq: int
    pcm: bytes
    is_speech: bool


class EndpointDetector:
    def __init__(self):
        self.pre_roll = deque(maxlen=PRE_ROLL_FRAMES)
        self.speaking = False
        self.speech_run = 0
        self.silence_run = 0
        self.utterance = []

    def push(self, frame):
        if not self.speaking:
            # 等待期间始终保存最近 300 ms,避免确认起点后丢失开头。
            self.pre_roll.append(frame)
            self.speech_run = self.speech_run + 1 if frame.is_speech else 0

            if self.speech_run >= START_SPEECH_FRAMES:
                self.speaking = True
                self.utterance = list(self.pre_roll)
                self.silence_run = 0
                return ('start', frame.seq, len(self.pre_roll))
            return None

        self.utterance.append(frame)
        if frame.is_speech:
            # 中间重新检测到语音时,取消正在累计的结束静音。
            self.silence_run = 0
        else:
            self.silence_run += 1

        if self.silence_run >= END_SILENCE_FRAMES:
            result = ('end', frame.seq, len(self.utterance))
            self.speaking = False
            self.speech_run = 0
            self.silence_run = 0
            self.utterance = []
            self.pre_roll.clear()
            return result
        return None


def main():
    detector = EndpointDetector()
    labels = [False] * 20 + [True] * 12 + [False] * 10

    for seq, is_speech in enumerate(labels):
        # 这里只模拟一帧 PCM;真实系统应传入采集模块产生的音频字节。
        frame = Frame(seq=seq, pcm=b'\x00' * 640, is_speech=is_speech)
        event = detector.push(frame)
        if event and event[0] == 'start':
            print(f'start={event[1]} pre_roll_frames={event[2]}')
        elif event and event[0] == 'end':
            print(f'end={event[1]} utterance_frames={event[2]}')


if __name__ == '__main__':
    main()
预期输出:
start=22 pre_roll_frames=15
end=41 utterance_frames=34
第 20 帧开始出现语音,但检测器等到第 22 帧才满足连续 3 帧条件。由于环形缓冲保存了最近 15 帧,真正提交的话语仍然包含确认点之前的音频,而不会从第 22 帧生硬起步。
为什么结束点要允许短暂停顿
如果检测到第一帧静音就结束,一句“帮我查一下……明天的天气”很可能在自然停顿处分裂成两次请求。尾部静音门限本质上是响应速度与完整性的权衡:门限越短,结果返回越快;门限越长,越不容易过早截断。
对于 20 ms 帧,200 ms 静音等于 10 帧,500 ms 等于 25 帧。实际参数应结合语言习惯、麦克风环境和产品交互调节,而不是直接复制固定数字。语音助手通常倾向较短延迟,听写和会议转写则可以容忍更长停顿。
仅依靠 VAD 也可能受到键盘声、电视声或背景说话影响。生产系统还可以把最低语音持续时间、最大话语时长和服务端最终结果信号加入状态机,但这些约束应建立在同一套固定帧时间基准上。
验证不会漏头或过早截断
测试端点检测时,应准备至少三类序列:短噪声后保持静音、正常说话后持续静音、说话过程中插入短暂停顿。第一类不应启动话语,第二类应在达到结束门限后结束,第三类在停顿未达到门限时必须继续保持 speaking 状态。
环形缓冲负责把确认起点之前的必要音频补回来,连续语音门限过滤瞬时误触发,连续静音门限吸收自然停顿。三者组合后,端点检测才不会为了追求低延迟而牺牲一句话的完整性。