
音频开发 / 系统课时
调用首个语音识别接口
调用首个语音识别接口
文件式 ASR 的最小链路是:准备符合要求的音频,携带认证信息发起请求,再从响应中读取文本、语言和时间信息。本节使用一个统一 HTTP 接口契约完成第一次调用,并把认证失败、请求参数错误和音频格式错误分别处理清楚。
学习目标
- 能组织一次包含音频文件与识别参数的 ASR 请求
- 能读取识别文本、语言和分段时间信息
- 能根据状态码定位认证、参数和媒体格式问题
约定最小接口契约
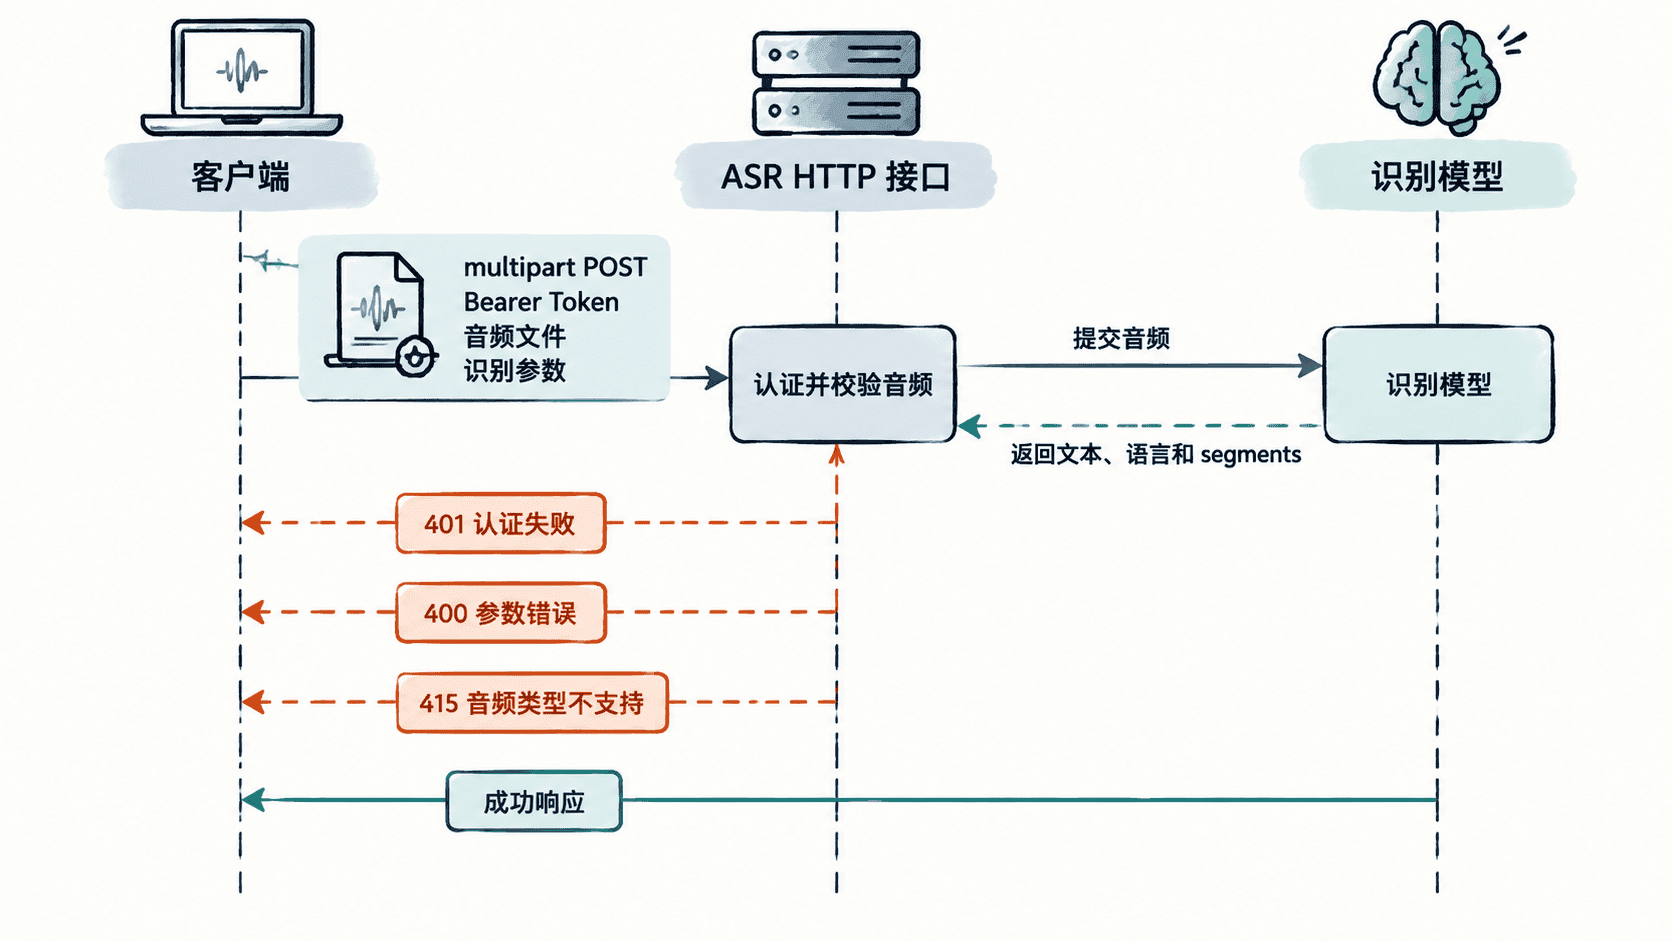
不同 ASR 厂商的 URL、参数和返回字段并不完全相同,因此业务代码不应默认所有供应商都使用同一种格式。本节为了集中练习请求链路,约定一个统一接口:客户端向 POST /v1/asr/transcriptions 上传 multipart 表单。
表单中的 file 保存音频文件,language 指定语言,timestamps 控制是否返回分段时间。认证使用 Authorization: Bearer <TOKEN>。成功响应包含完整文本 text、语言 language 和时间分段 segments。接入真实服务时,应把这些名称映射到供应商实际接口定义。
发起第一次请求
运行前准备 sample.wav,把 ASR_BASE_URL 和 ASR_TOKEN 环境变量设置为实际服务地址与令牌,并确保 Python 环境已经安装 requests。下面代码包含文件上传、认证、参数发送、状态码检查和结果读取,可以直接作为最小客户端入口。
import os
import requests

base_url = os.environ["ASR_BASE_URL"].rstrip("/")
token = os.environ["ASR_TOKEN"]

with open("sample.wav", "rb") as audio_file:
    response = requests.post(
        f"{base_url}/v1/asr/transcriptions",
        headers={"Authorization": f"Bearer {token}"},
        files={"file": ("sample.wav", audio_file, "audio/wav")},
        data={"language": "zh", "timestamps": "segment"},
        timeout=60,
    )

if response.status_code == 401:
    raise RuntimeError("认证失败:检查 ASR_TOKEN")
if response.status_code == 415:
    raise RuntimeError("音频格式不受支持:检查 Content-Type 与实际编码")
if response.status_code >= 400:
    raise RuntimeError(f"请求失败:HTTP {response.status_code} {response.text}")

result = response.json()
print("text:", result["text"])
print("language:", result["language"])

for segment in result.get("segments", []):
    print(f'{segment["start"]:.2f}-{segment["end"]:.2f}: {segment["text"]}')
预期结果:成功请求的 HTTP 状态码为 200。假设 sample.wav 中说的是“你好,欢迎使用语音识别。”,服务按本课约定返回文本、语言和一个时间分段,响应体形态如下;分段时间会根据实际识别结果变化。
{"text":"你好,欢迎使用语音识别。","language":"zh","segments":[{"start":0.0,"end":2.84,"text":"你好,欢迎使用语音识别。"}]}对应的控制台输出形态为:
text: 你好,欢迎使用语音识别。
language: zh
<TIME>-<TIME>: 你好,欢迎使用语音识别。
<TIME> 表示实际的分段起止秒数。真实接口如果不提供时间信息,可以让 segments 为空;如果业务必须生成字幕或做音频高亮,则应明确选择支持时间戳的响应模式。
按状态码定位基本异常
401 Unauthorized 通常表示令牌缺失、失效,或者认证头格式不符合接口要求。这种错误属于确定性错误,在修改认证信息之前反复重试没有意义。
400 Bad Request 一般说明请求已经到达服务端,但参数无法通过校验,例如字段名错误、语言值不合法或 multipart 表单缺少文件。排查时应保留服务返回的错误体,并与实际接口文档逐项对照。
415 Unsupported Media Type 更直接地指向音频类型问题。即使上传文件叫 sample.wav,内部编码仍可能不满足接口要求,因此要同时检查真实编码、采样率、声道数以及请求中的 Content-Type。
不要把 HTTP 200 当成识别完成
请求成功后还需要检查响应内容。最基本的条件是 text 存在且不是空字符串;业务依赖语言信息时还要验证 language;业务依赖字幕或时间轴时,则需要检查每个分段的 start 不大于 end,并确认分段整体按时间递增。
生产环境还应记录请求 ID、耗时、HTTP 状态码和错误分类,方便定位模型慢、网络慢还是参数错误。但日志中不要保存完整认证令牌,也不要默认记录包含敏感信息的原始音频。
完成这些检查后,文件式语音识别的最小链路就闭环了:音频作为请求输入,接口完成认证与格式校验,模型产生识别结果,客户端再验证文本和时间信息。后续扩展流式识别时,变化主要发生在音频传输和增量结果处理方式,而这套输入契约与错误分类仍然适用。